Thông tin khoa học và công nghệ cập nhật từ nhiều nguồn tin trong nước và quốc tế
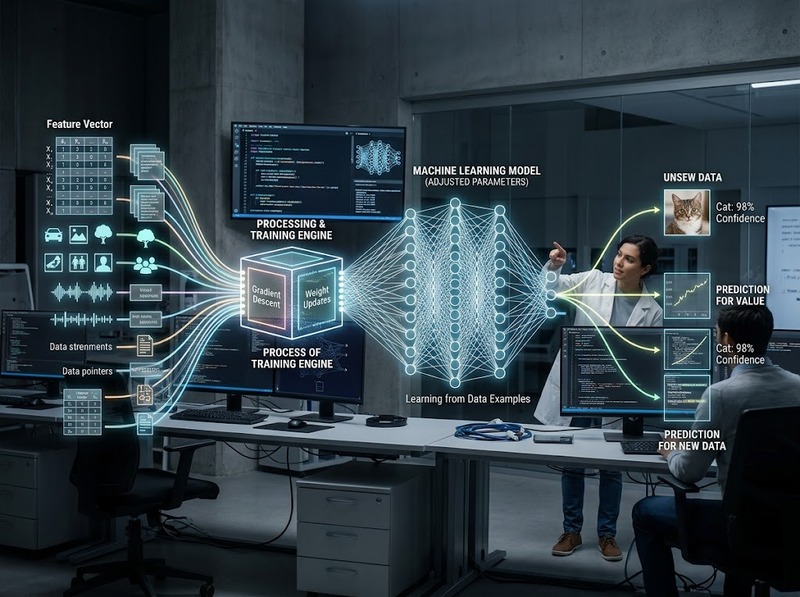
Mô hình học máy được tạo từ dữ liệu như thế nào?
Một mô hình học máy có thể hiểu là một hệ thống toán học được điều chỉnh để tìm và sử dụng quy luật trong dữ liệu nhằm tạo ra dự đoán hoặc quyết định. Điểm quan trọng là mô hình không đơn giản “lưu lại” toàn bộ dữ liệu huấn luyện. Trong quá trình học, thuật toán tìm các tham số phù hợp với cấu trúc của dữ liệu để có thể áp dụng quy luật đã học lên những dữ liệu mới
Học tăng cường học qua phần thưởng như thế nào?
Học tăng cường là một phương pháp học máy trong đó một tác nhân học cách hành động thông qua tương tác với môi trường thay vì được cung cấp sẵn đáp án đúng cho từng tình huống. Ở mỗi bước, tác nhân quan sát trạng thái, chọn một hành động, nhận phản hồi dưới dạng phần thưởng hoặc phạt rồi dùng trải nghiệm đó để điều chỉnh cách hành động trong tương lai.
Học không giám sát phát hiện cấu trúc dữ liệu thế nào?
Học không giám sát làm việc với các quan sát chưa có nhãn mục tiêu. Thay vì học một ánh xạ từ dữ liệu đầu vào tới đáp án đã biết, thuật toán tìm những quy luật nội tại theo một tiêu chí toán học: điểm nào gần nhau, vùng nào có mật độ cao, hướng nào chứa nhiều biến thiên hoặc quan sát nào khác biệt rõ so với phần còn lại.
Học có giám sát học từ dữ liệu gắn nhãn thế nào?
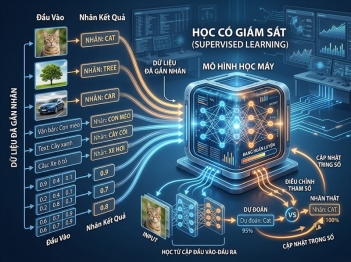
Học có giám sát là phương pháp học máy trong đó mô hình được huấn luyện từ các mẫu dữ liệu đã có đầu vào và nhãn đúng tương ứng. Thay vì chỉ quan sát dữ liệu để tìm nhóm hoặc cấu trúc, mô hình học cách liên hệ đầu vào với đầu ra mong muốn, sau đó dùng mối quan hệ đã học để dự đoán nhãn cho dữ liệu mới.
Học máy khác lập trình theo quy tắc như thế nào?
Nếu lập trình truyền thống trả lời câu hỏi “Tôi phải viết quy tắc nào để máy xử lý tình huống này?”, thì học máy chuyển trọng tâm sang “Tôi có thể cung cấp dữ liệu và mục tiêu nào để máy học ra cách xử lý?”
Trí tuệ nhân tạo hỗ trợ hệ thống thông minh như thế nào?
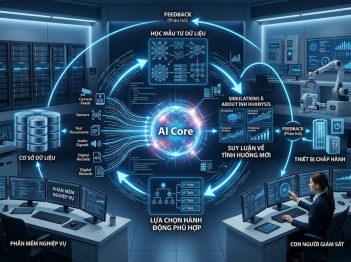
Trí tuệ nhân tạo (AI) là nhóm phương pháp và công nghệ cho phép máy thực hiện những nhiệm vụ thường cần đến năng lực nhận biết mẫu, học từ dữ liệu, suy luận, dự đoán hoặc lựa chọn hành động. Trong một hệ thống thông minh, AI thường không phải toàn bộ hệ thống. Nó là lớp tạo ra khả năng thích nghi và hỗ trợ quyết định, nằm bên cạnh dữ liệu, cảm biến, phần mềm nghiệp vụ, cơ sở luật, giao diện, thiết bị chấp hành và con người.
Hệ thống tự động khác điều khiển thủ công như thế nào?
Hệ thống tự động là gì?
Mã hóa và nén dữ liệu khác nhau như thế nào?
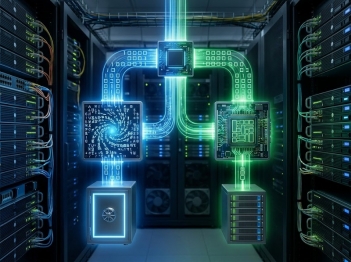
Mã hóa và nén dữ liệu đều biến đổi dữ liệu đầu vào thành một dạng khác, nhưng mục đích cốt lõi không giống nhau. Mã hóa tập trung vào bảo mật: biến dữ liệu thành dạng không thể đọc được nếu không có khóa hoặc cơ chế giải mã phù hợp. Nén tập trung vào hiệu quả lưu trữ và truyền tải: biểu diễn cùng thông tin bằng ít dữ liệu hơn.
Những đặc điểm nào khiến dữ liệu được xem là big data?
Big data là gì?
Hệ thống tự động hóa gồm những thành phần nào?
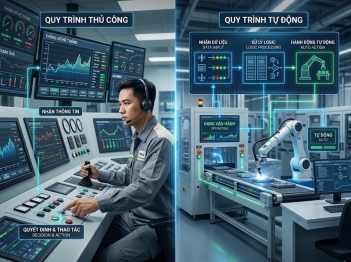
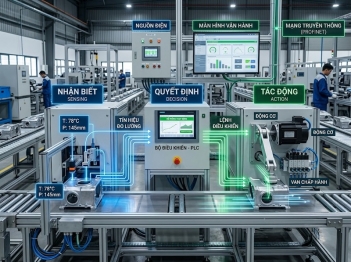
Một hệ thống tự động có thể đơn giản như bộ điều nhiệt hoặc phức tạp như một dây chuyền sản xuất. Dù quy mô khác nhau, có thể phân tích chúng bằng ba câu hỏi: hệ thống nhận biết trạng thái bằng gì, quyết định bằng gì và tác động lên quá trình bằng gì. Ba chức năng đó lần lượt thuộc về cảm biến, bộ điều khiển và cơ cấu chấp hành. Nguồn điện, thiết bị bảo vệ, giao diện vận hành và truyền thông có thể rất quan trọng trong hệ thống thực tế, nhưng chúng là các lớp hỗ trợ cho chuỗi chức năng đo – quyết định – tác động.
Nén dữ liệu làm giảm dung lượng lưu trữ như thế nào?
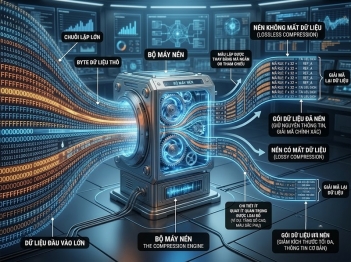
Nén dữ liệu làm tệp nhỏ đi bằng cách tạo ra một biểu diễn cần ít bit hơn biểu diễn ban đầu. Thay vì lưu mọi ký hiệu, giá trị hoặc chuỗi lặp theo cách cố định, thuật toán tìm cấu trúc có thể mã hóa gọn hơn rồi lưu mã cùng những thông tin cần thiết để giải mã.
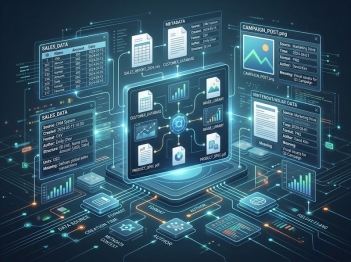
Metadata mô tả dữ liệu như thế nào?
Metadata là dữ liệu dùng để mô tả dữ liệu khác. Thay vì chứa trực tiếp nội dung cần khai thác, metadata cung cấp ngữ cảnh để con người hoặc hệ thống nhận biết, tìm kiếm, phân loại và sử dụng dữ liệu đúng cách.
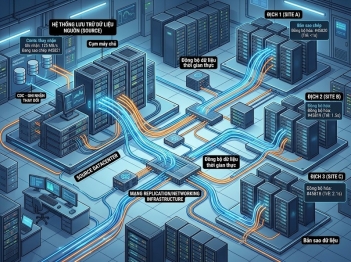
Data replication đồng bộ dữ liệu giữa các hệ thống thế nào?
Data replication là cơ chế tạo và duy trì một hoặc nhiều bản sao của dữ liệu trên các hệ thống lưu trữ khác nhau. Thay vì chỉ tồn tại ở một nơi, dữ liệu từ hệ thống nguồn được ghi nhận thay đổi, truyền sang hệ thống đích rồi áp dụng để bản sao có thể tiếp tục phản ánh trạng thái của nguồn
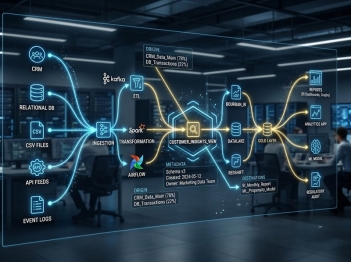
Data lineage theo dõi nguồn gốc dữ liệu như thế nào?
Data lineage là cách mô tả và theo dõi nguồn gốc, luồng di chuyển, các bước xử lý và mối quan hệ giữa dữ liệu trong suốt vòng đời của nó. Thay vì chỉ biết một bảng dữ liệu hiện đang nằm ở đâu, lineage giúp trả lời câu hỏi: dữ liệu này đến từ đâu, được tạo bởi quy trình nào, đã qua những biến đổi nào và đang được những hệ thống nào sử dụng?
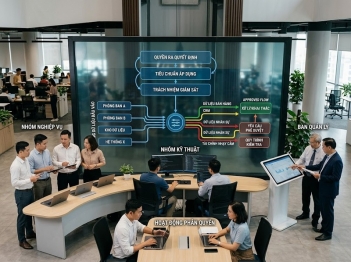
Quản trị dữ liệu giúp tổ chức kiểm soát dữ liệu thế nào?
Quản trị dữ liệu không phải là trực tiếp quản lý từng cơ sở dữ liệu hay kiểm soát từng thao tác kỹ thuật. Nó thiết lập cơ chế ra quyết định đối với dữ liệu: ai được quyết định, quyết định theo nguyên tắc nào, ai phải chịu trách nhiệm và tổ chức kiểm tra việc thực hiện bằng cách nào. Vì vậy, khả năng kiểm soát dữ liệu đến từ sự kết hợp giữa quyền hạn, chuẩn, trách nhiệm và giám sát chứ không chỉ từ phần mềm hay quyền truy cập.
Dữ liệu trùng lặp ảnh hưởng chất lượng thông tin thế nào?
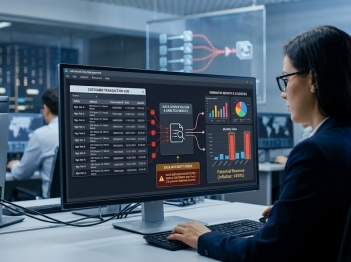
Dữ liệu trùng lặp là tình trạng cùng một thực thể, sự kiện hoặc bản ghi được lưu nhiều lần trong một tập dữ liệu, dù có thể giống hệt hoặc khác nhau về cách biểu diễn. Ví dụ, một khách hàng có thể xuất hiện hai bản ghi do nhập thông tin nhiều lần, hoặc cùng một giao dịch được ghi nhận lại bởi hai hệ thống.
Vì sao dữ liệu giữa nhiều hệ thống có thể không nhất quán?
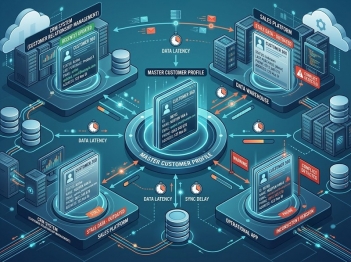
Khi cùng một thông tin xuất hiện ở CRM, ERP, hệ thống bán hàng, kho dữ liệu hoặc ứng dụng khác, việc các nguồn trả về cùng một giá trị không phải lúc nào cũng được bảo đảm. Một hệ thống có thể đã ghi nhận thay đổi trong khi hệ thống khác vẫn giữ phiên bản cũ; nghiêm trọng hơn, hai hệ thống có thể cùng cập nhật một dữ liệu nhưng theo các quy tắc khác nhau.
Làm sao nhận biết độ chính xác của dữ liệu bị suy giảm?
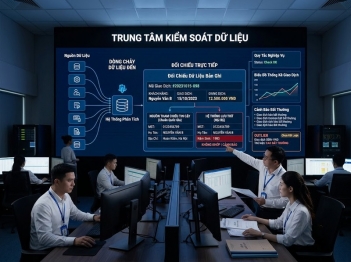
Độ chính xác của dữ liệu phản ánh mức độ một giá trị mô tả đúng đối tượng, sự kiện hoặc trạng thái thực mà nó đại diện. Một dữ liệu có thể đúng định dạng, đầy đủ và không mâu thuẫn với hệ thống nhưng vẫn sai nếu giá trị đó không đúng với thực tế.
Tính đầy đủ của dữ liệu ảnh hưởng phân tích thế nào?
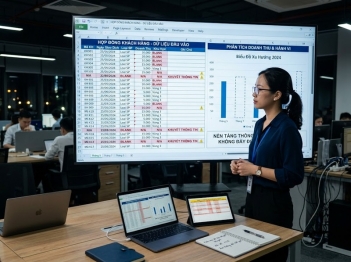
Tính đầy đủ của dữ liệu là mức độ mà tập dữ liệu có đủ các thông tin cần thiết để trả lời câu hỏi phân tích mà không tạo ra khoảng trống làm thay đổi đáng kể kết quả. Một bộ dữ liệu có nhiều bản ghi chưa chắc đã đầy đủ: nếu thiếu biến quan trọng, thiếu nhóm đối tượng cần phân tích hoặc thiếu dữ liệu ở một giai đoạn then chốt, kết luận vẫn có thể bị sai lệch.
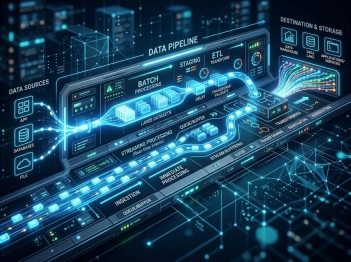
Dữ liệu di chuyển qua data pipeline như thế nào?
Một data pipeline xác định cách dữ liệu được đọc từ nguồn, chuyển qua các bước trung gian, xử lý khi cần và ghi vào hệ thống đích. Pipeline có thể chỉ di chuyển dữ liệu nguyên trạng hoặc thực hiện thêm các thao tác như kiểm tra, làm sạch, đổi cấu trúc, kết hợp và tổng hợp.
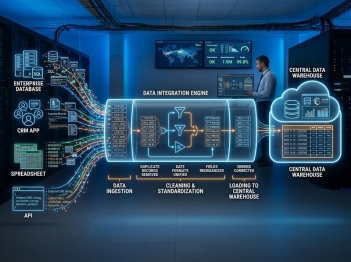
ETL gồm những bước nào trong quá trình tích hợp dữ liệu?
ETL là viết tắt của Extract – Transform – Load, tương ứng với trích xuất – chuyển đổi – tải dữ liệu. Đây là một quy trình tích hợp dữ liệu trong đó dữ liệu được lấy từ một hoặc nhiều hệ thống nguồn, xử lý để trở nên nhất quán và phù hợp với yêu cầu sử dụng, sau đó được nạp vào hệ thống đích.
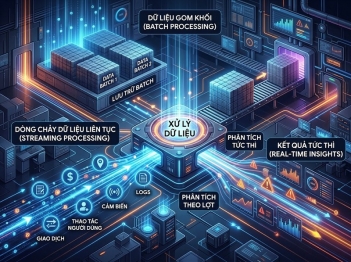
Stream processing khác batch processing như thế nào?
Dữ liệu có thể được xử lý ngay khi phát sinh hoặc được tích lũy thành một tập dữ liệu rồi xử lý theo từng đợt. Hai cách tiếp cận này tương ứng với stream processing và batch processing. Khác biệt cốt lõi không nằm ở việc dữ liệu lớn hay nhỏ, mà ở cách hệ thống tổ chức thời điểm và đơn vị xử lý dữ liệu
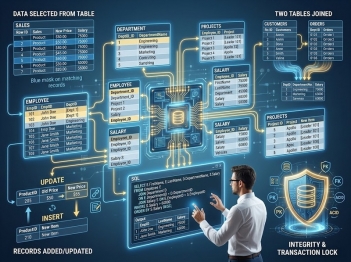
SQL làm việc với dữ liệu quan hệ như thế nào?
SQL (Structured Query Language) là ngôn ngữ dùng để làm việc với dữ liệu được tổ chức theo mô hình quan hệ. Thay vì mô tả từng bước máy tính phải thực hiện, người dùng SQL chủ yếu khai báo muốn lấy, thêm, thay đổi hoặc xóa dữ liệu nào; hệ quản trị cơ sở dữ liệu (DBMS) sẽ quyết định cách thực thi phù hợp.
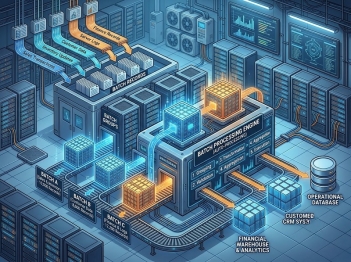
Batch processing phù hợp với những loại tác vụ nào?
Batch processing, hay xử lý dữ liệu theo lô, là cách tổ chức công việc trong đó dữ liệu hoặc các tác vụ được gom thành một nhóm rồi xử lý cùng nhau thay vì xử lý ngay từng bản ghi khi phát sinh. Mô hình này đặc biệt phù hợp với các công việc có tính lặp lại, khối lượng lớn, có thể lập lịch và không yêu cầu kết quả tức thời.

