
Những đặc điểm nào khiến dữ liệu được xem là big data?
Mục lục
- Khối lượng dữ liệu lớn là đặc trưng cốt lõi của big data
- Tốc độ phát sinh và xử lý dữ liệu tạo nên đặc trưng Velocity
- Đa dạng định dạng và nguồn dữ liệu tạo nên Variety
- Vì sao Volume, Velocity và Variety phải được xem xét cùng nhau?
- Big data không có một ngưỡng dung lượng cố định
- Đặc trưng của big data có ý nghĩa gì trong thực tế?
Big data là tập dữ liệu có quy mô, tốc độ phát sinh và mức độ đa dạng đủ lớn để các phương pháp xử lý dữ liệu truyền thống gặp hạn chế. Tìm hiểu các đặc trưng cốt lõi giúp nhận diện big data và hiểu vì sao chúng cần cách tiếp cận khác trong lưu trữ, xử lý và phân tích
Big data là gì?
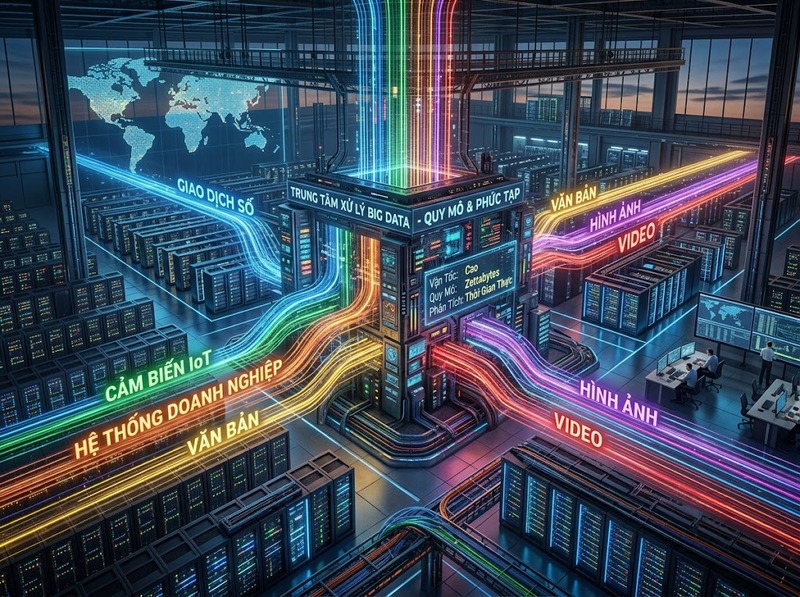
Big data, hay dữ liệu lớn, không đơn thuần là một tập dữ liệu có dung lượng rất lớn. Khái niệm này dùng để mô tả những tập dữ liệu có quy mô, tốc độ phát sinh, mức độ đa dạng hoặc yêu cầu xử lý khiến các phương pháp quản lý dữ liệu truyền thống khó đáp ứng hiệu quả.
Điểm quan trọng là không tồn tại một ngưỡng dung lượng cố định để mọi dữ liệu vượt qua đều trở thành big data. Một tập dữ liệu có thể được xem là dữ liệu lớn khi quy mô và đặc tính của nó tạo ra thách thức đáng kể đối với việc thu thập, lưu trữ, xử lý, quản trị hoặc phân tích.
Vì vậy, để nhận diện big data, cần xem xét nhiều đặc trưng đồng thời thay vì chỉ nhìn vào số gigabyte hay terabyte.
Khối lượng dữ liệu lớn là đặc trưng cốt lõi của big data
Volume là đặc trưng nói về lượng dữ liệu cần thu thập, lưu trữ và xử lý. Đây là đặc điểm thường được nhắc đến đầu tiên khi nói về big data.
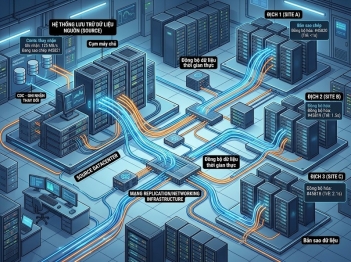
Dữ liệu có thể phát sinh từ nhiều nguồn như giao dịch, thiết bị cảm biến, ứng dụng, website, mạng xã hội, hệ thống doanh nghiệp hoặc các thiết bị kết nối. Khi lượng dữ liệu tăng liên tục, việc lưu trữ trên một hệ thống đơn lẻ hoặc xử lý bằng các công cụ truyền thống có thể trở nên kém hiệu quả.
Tuy nhiên, Volume không chỉ có nghĩa là dữ liệu nhiều. Vấn đề thực tế nằm ở khả năng quản lý lượng dữ liệu đó trong một khoảng thời gian nhất định. Một hệ thống có thể xử lý vài gigabyte dễ dàng, nhưng khi dữ liệu tăng lên hàng terabyte hoặc petabyte và tiếp tục phát sinh mỗi ngày, yêu cầu về kiến trúc lưu trữ, phân phối dữ liệu và năng lực tính toán sẽ thay đổi đáng kể.
Do đó, khi đánh giá đặc trưng Volume, cần quan tâm đến:
· Quy mô dữ liệu hiện tại
· Tốc độ tăng trưởng của dữ liệu
· Khả năng lưu trữ và mở rộng hệ thống
· Chi phí quản lý dữ liệu
· Khối lượng dữ liệu cần truy xuất hoặc phân tích
Volume càng lớn và tốc độ tăng trưởng càng cao, áp lực lên hệ thống xử lý càng rõ rệt.
Tốc độ phát sinh và xử lý dữ liệu tạo nên đặc trưng Velocity
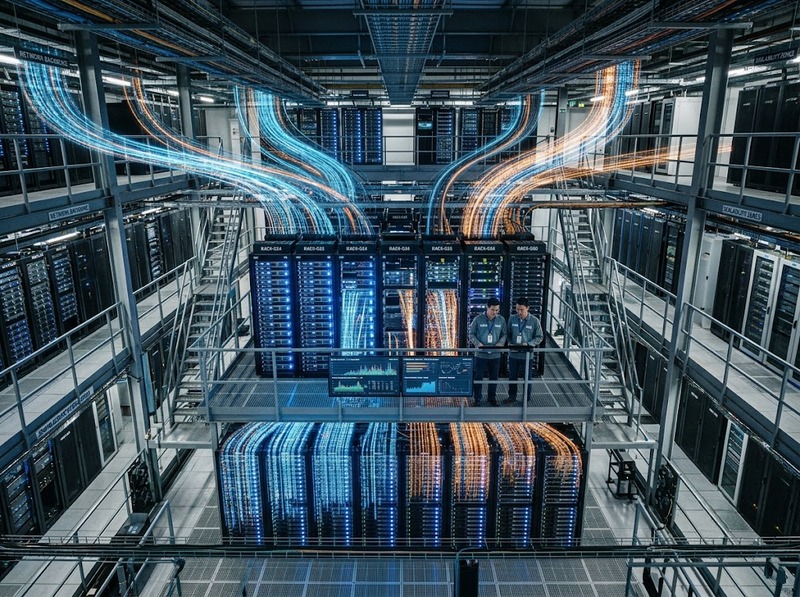
Velocity đề cập đến tốc độ dữ liệu được tạo ra, truyền đi, thu nhận và xử lý.
Trong các hệ thống truyền thống, dữ liệu có thể được thu thập rồi xử lý theo lô vào những thời điểm định kỳ. Nhưng với big data, dữ liệu có thể xuất hiện liên tục và nhanh đến mức giá trị của việc phân tích phụ thuộc vào khả năng xử lý kịp thời.
Ví dụ, một hệ thống có thể liên tục nhận dữ liệu từ hàng nghìn hoặc hàng triệu thiết bị, giao dịch hoặc tương tác người dùng. Nếu dữ liệu chỉ được xử lý sau nhiều giờ hoặc nhiều ngày, một số thông tin có giá trị theo thời điểm có thể không còn hữu ích.
Velocity vì vậy đặt ra ba bài toán liên quan:
1. Dữ liệu được tạo ra nhanh đến mức nào
2. Dữ liệu được truyền và thu thập nhanh đến mức nào
3. Hệ thống có thể xử lý dữ liệu với tốc độ nào
Đây cũng là lý do big data không chỉ liên quan đến dung lượng lưu trữ. Một tập dữ liệu không quá lớn nhưng được tạo ra với tốc độ rất cao vẫn có thể tạo ra thách thức về xử lý dữ liệu.
Đa dạng định dạng và nguồn dữ liệu tạo nên Variety
Variety phản ánh sự đa dạng của dữ liệu. Đây là điểm khiến việc quản lý big data phức tạp hơn so với một cơ sở dữ liệu có cấu trúc thống nhất.
Dữ liệu có thể tồn tại dưới nhiều dạng:
· Dữ liệu có cấu trúc: bảng, bản ghi giao dịch, dữ liệu quan hệ
· Dữ liệu bán cấu trúc: JSON, XML hoặc các định dạng có cấu trúc linh hoạt
· Dữ liệu phi cấu trúc: văn bản, hình ảnh, âm thanh, video
Ngoài khác biệt về định dạng, dữ liệu còn có thể đến từ nhiều nguồn khác nhau. Các nguồn này có cách biểu diễn, chất lượng, tần suất cập nhật và ngữ cảnh sử dụng không giống nhau.
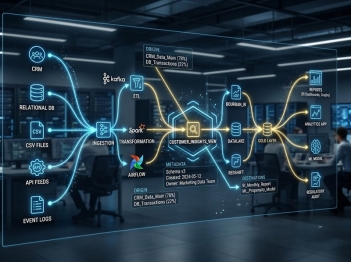
Vì vậy, bài toán của Variety không chỉ là lưu được nhiều loại dữ liệu. Hệ thống còn phải có khả năng thu thập, tích hợp, chuẩn hóa và phân tích những dữ liệu có cấu trúc khác nhau.
Đây là một trong những lý do kiến trúc dữ liệu lớn thường cần nhiều tầng xử lý thay vì chỉ dựa vào một cơ sở dữ liệu truyền thống.
Vì sao Volume, Velocity và Variety phải được xem xét cùng nhau?
Ba đặc trưng Volume, Velocity và Variety, thường được gọi là mô hình 3V, giúp mô tả ba khía cạnh quan trọng của big data: dữ liệu nhiều đến đâu, phát sinh nhanh thế nào và đa dạng đến mức nào.
Chúng không tồn tại hoàn toàn độc lập.
Một hệ thống có thể đồng thời phải xử lý:
· Lượng dữ liệu rất lớn
· Dữ liệu phát sinh liên tục với tốc độ cao
· Nhiều loại dữ liệu từ nhiều nguồn khác nhau
Khi ba yếu tố này kết hợp, thách thức không còn nằm ở việc "có đủ chỗ để lưu dữ liệu hay không". Hệ thống còn phải bảo đảm dữ liệu được tiếp nhận, tổ chức, xử lý và phân tích phù hợp với mục tiêu sử dụng.
Chẳng hạn, một kho dữ liệu có dung lượng lớn nhưng dữ liệu chỉ được cập nhật định kỳ có thể chưa tạo ra cùng một bài toán xử lý như hệ thống vừa có dung lượng lớn vừa tiếp nhận dữ liệu theo thời gian thực. Tương tự, dữ liệu có cùng dung lượng nhưng bao gồm nhiều định dạng khác nhau sẽ tạo ra yêu cầu tích hợp phức tạp hơn.
Vì vậy, không nên dùng một tiêu chí duy nhất để xác định big data. Bản chất của dữ liệu lớn nằm ở sự kết hợp giữa quy mô và độ phức tạp của việc thu thập, lưu trữ, xử lý và khai thác dữ liệu.
Big data không có một ngưỡng dung lượng cố định
Một hiểu lầm phổ biến là cứ đạt một con số dung lượng nhất định thì dữ liệu sẽ trở thành big data. Cách hiểu này quá đơn giản.
Không có một mốc kiểu "trên X TB là big data" có thể áp dụng cho mọi tổ chức và mọi hệ thống. Một quy mô dữ liệu có thể rất lớn đối với một doanh nghiệp nhỏ nhưng lại là mức xử lý bình thường đối với một nền tảng công nghệ lớn.
Do đó, việc nhận diện big data cần đặt trong bối cảnh của:
· Năng lực phần cứng và lưu trữ
· Công cụ xử lý đang sử dụng
· Tốc độ dữ liệu phát sinh
· Sự đa dạng của dữ liệu
· Yêu cầu về thời gian xử lý
· Khả năng mở rộng của hệ thống
Điều này giúp phân biệt dữ liệu có dung lượng lớn với big data theo nghĩa một bài toán quản trị và xử lý dữ liệu phức tạp.
Đặc trưng của big data có ý nghĩa gì trong thực tế?
Những đặc trưng trên ảnh hưởng trực tiếp đến cách một hệ thống thiết kế và vận hành dữ liệu.
Volume tạo áp lực lên lưu trữ và năng lực tính toán. Hệ thống cần có khả năng mở rộng khi lượng dữ liệu tiếp tục tăng.
Velocity quyết định yêu cầu về tốc độ thu thập và xử lý. Với dữ liệu cần phản hồi nhanh, xử lý theo lô có thể không đáp ứng được nhu cầu.
Variety tạo ra yêu cầu về tích hợp và quản trị nhiều loại dữ liệu. Hệ thống phải xử lý được sự khác biệt về định dạng, nguồn và cấu trúc.
Ba yếu tố này cũng giúp xác định khi nào một phương pháp xử lý dữ liệu truyền thống bắt đầu bộc lộ giới hạn. Khi dữ liệu tăng về quy mô, tốc độ và độ đa dạng đến mức phương pháp hiện tại không còn đáp ứng hiệu quả, nhu cầu về kiến trúc và công nghệ big data trở nên rõ ràng hơn.
Big data được nhận diện không chỉ bởi việc dữ liệu có "nhiều", mà bởi những đặc tính khiến dữ liệu trở nên khó thu thập, lưu trữ, xử lý và khai thác bằng cách tiếp cận thông thường. Ba đặc trưng nền tảng gồm Volume về khối lượng, Velocity về tốc độ và Variety về sự đa dạng. Không có một ngưỡng dung lượng duy nhất áp dụng cho mọi trường hợp; cần đánh giá các đặc trưng này trong mối quan hệ với yêu cầu và năng lực xử lý của hệ thống.

GỬI Ý KIẾN BÌNH LUẬN

