
Data replication đồng bộ dữ liệu giữa các hệ thống thế nào?
Mục lục
- Data replication là gì và bản sao dữ liệu được tạo ra như thế nào?
- Cơ chế data replication truyền thay đổi giữa hệ thống nguồn và đích
- Đồng bộ và bất đồng bộ trong data replication khác nhau thế nào?
- Những mô hình data replication nào thường được sử dụng?
- Data replication được sử dụng để làm gì trong hệ thống lưu trữ?
- Độ trễ, tính nhất quán và giới hạn của data replication cần lưu ý
Data replication là cơ chế sao chép và duy trì dữ liệu giữa hệ thống nguồn với một hoặc nhiều hệ thống đích. Bài viết giải thích cách replication truyền thay đổi, khác biệt giữa đồng bộ và bất đồng bộ, các giới hạn về độ trễ, nhất quán và cách ứng dụng trong lưu trữ dữ liệu
Data replication là cơ chế tạo và duy trì một hoặc nhiều bản sao của dữ liệu trên các hệ thống lưu trữ khác nhau. Thay vì chỉ tồn tại ở một nơi, dữ liệu từ hệ thống nguồn được ghi nhận thay đổi, truyền sang hệ thống đích rồi áp dụng để bản sao có thể tiếp tục phản ánh trạng thái của nguồn
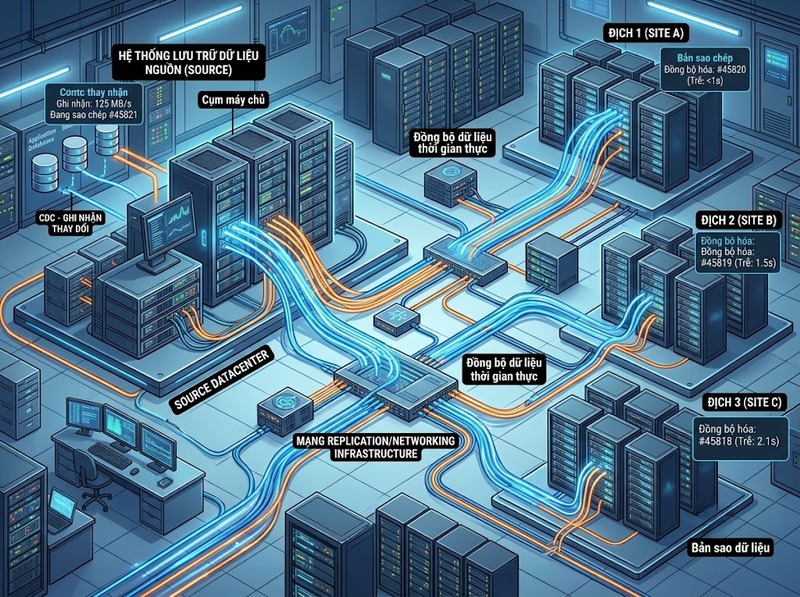
Trong thực tế, replication có thể kết nối các máy chủ cơ sở dữ liệu, cụm lưu trữ, vùng địa lý hoặc các bucket lưu trữ. Cách đồng bộ không phải lúc nào cũng giống nhau: hệ thống có thể yêu cầu bản sao xác nhận ngay khi dữ liệu được ghi, hoặc cho phép bản sao cập nhật sau một khoảng trễ
Data replication là gì và bản sao dữ liệu được tạo ra như thế nào?
Data replication tập trung vào việc duy trì nhiều bản sao của cùng một tập dữ liệu giữa các hệ thống có quan hệ với nhau. Một hệ thống thường đóng vai trò nguồn, nơi thay đổi dữ liệu phát sinh, còn hệ thống đích nhận và áp dụng những thay đổi đó
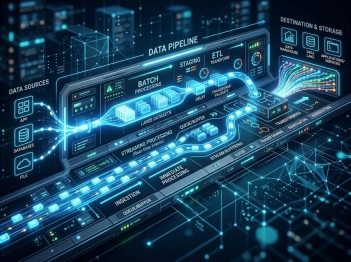
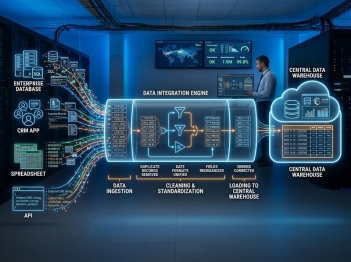
Luồng replication cơ bản có thể hình dung như sau:
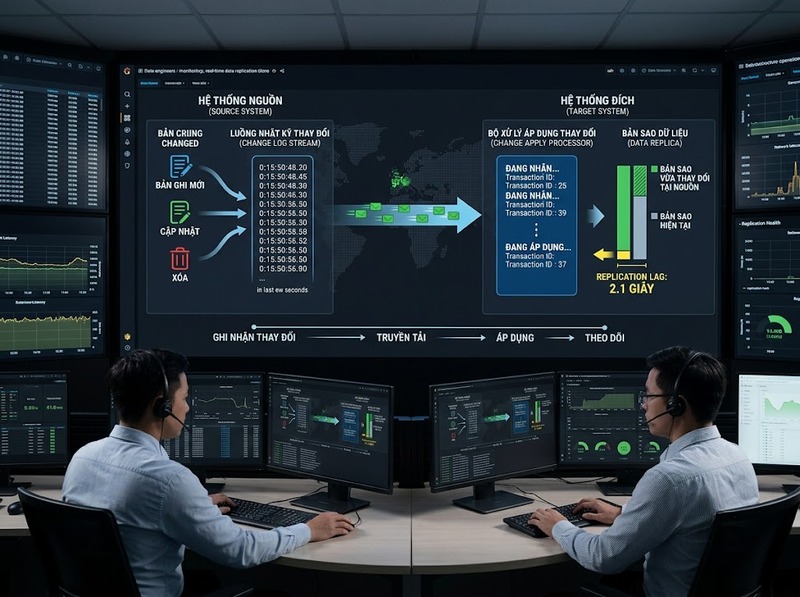
Dữ liệu thay đổi → Ghi nhận thay đổi → Truyền thay đổi → Áp dụng tại hệ thống đích → Kiểm tra trạng thái bản sao
Cách ghi nhận thay đổi phụ thuộc vào công nghệ. Với cơ sở dữ liệu, hệ thống có thể sử dụng transaction log hoặc cơ chế tương tự để truyền các thay đổi thay vì liên tục sao chép toàn bộ dữ liệu. PostgreSQL, chẳng hạn, sử dụng WAL cho streaming replication và phân biệt máy chủ primary với standby; logical replication lại tổ chức theo publisher và subscriber
Điểm quan trọng là replication không đơn thuần là thao tác "copy file" một lần. Một hệ thống replication phải tiếp tục xử lý các thay đổi phát sinh sau lần sao chép ban đầu để bản sao không nhanh chóng trở nên lỗi thời
Cơ chế data replication truyền thay đổi giữa hệ thống nguồn và đích
Một quy trình replication thường có bốn lớp chính
1. Ghi nhận thay đổi
Hệ thống nguồn xác định dữ liệu nào đã thay đổi. Có thể là bản ghi mới, bản ghi được cập nhật hoặc xóa
2. Đóng gói và truyền thay đổi
Các thay đổi được đưa vào luồng replication và truyền qua mạng tới hệ thống đích. Với log-based replication, hệ thống có thể truyền thông tin thay đổi từ transaction log thay vì đọc lại toàn bộ dữ liệu nguồn
3. Nhận và áp dụng
Hệ thống đích nhận các thay đổi rồi ghi chúng vào cấu trúc lưu trữ tương ứng. Với logical replication, dữ liệu có thể được chuyển thành các thay đổi ở mức logic; với physical replication, bản sao có thể phản ánh cấu trúc lưu trữ ở mức thấp hơn
4. Theo dõi độ trễ và trạng thái
Hệ thống phải biết bản sao đang theo kịp nguồn hay bị chậm. Nếu tốc độ phát sinh thay đổi ở nguồn cao hơn tốc độ truyền hoặc áp dụng tại đích, replication lag sẽ tăng
Vì vậy, replication thực chất là một chuỗi xử lý liên tục chứ không phải một lần sao chép độc lập. Độ trễ giữa thời điểm nguồn ghi dữ liệu và thời điểm bản sao áp dụng dữ liệu là một chỉ báo quan trọng để đánh giá trạng thái đồng bộ
Đồng bộ và bất đồng bộ trong data replication khác nhau thế nào?
Hai mô hình quan trọng nhất là synchronous replication và asynchronous replication
Replication đồng bộ
Với đồng bộ, thao tác ghi có thể phải chờ hệ thống đích xác nhận đã nhận hoặc ghi dữ liệu theo mức đảm bảo được cấu hình trước khi giao dịch được xem là hoàn tất
Ưu điểm chính là giảm khoảng thời gian mà dữ liệu đã được xác nhận ở nguồn nhưng chưa tồn tại an toàn ở bản sao. Đổi lại, thời gian phản hồi của thao tác ghi có thể tăng vì nó phụ thuộc vào việc truyền dữ liệu và phản hồi qua mạng
PostgreSQL mô tả synchronous replication theo hướng giao dịch ghi phải chờ xác nhận từ standby đồng bộ; thời gian chờ tối thiểu cũng chịu ảnh hưởng bởi thời gian truyền hai chiều giữa primary và standby
Replication bất đồng bộ
Với bất đồng bộ, hệ thống nguồn có thể hoàn tất thao tác ghi trước khi bản sao đích cập nhật xong. Bản sao vì vậy có thể chậm hơn nguồn một khoảng thời gian
Mô hình này thường giảm ảnh hưởng của replication lên độ trễ ghi. Đổi lại, khi nguồn gặp sự cố trước khi các thay đổi chưa kịp truyền sang đích, bản sao có thể thiếu một phần dữ liệu mới nhất
Ví dụ, Amazon RDS sử dụng asynchronous replication cho read replica trong nhiều trường hợp. Read replica có thể phục vụ truy vấn đọc, nhưng dữ liệu trên đó có thể có replication lag so với cơ sở dữ liệu chính
Trade-off cốt lõi là: đồng bộ ưu tiên mức nhất quán và độ bền dữ liệu tại thời điểm ghi, còn bất đồng bộ ưu tiên hiệu năng ghi và khả năng chấp nhận một mức độ trễ giữa các bản sao
Những mô hình data replication nào thường được sử dụng?
Data replication có thể được phân loại theo cách dữ liệu được sao chép và quyền ghi của các hệ thống
Một chiều và nhiều chiều
Trong replication một chiều, dữ liệu chủ yếu đi từ nguồn sang đích. Mô hình primary–standby là ví dụ điển hình
Trong replication nhiều chiều, nhiều hệ thống có thể phát sinh thay đổi. Khi đó cơ chế xử lý xung đột trở nên quan trọng vì cùng một dữ liệu có thể được sửa ở nhiều nơi trước khi các thay đổi được hợp nhất
Physical và logical replication
Physical replication tập trung vào việc duy trì bản sao ở mức vật lý hoặc gần với cấu trúc lưu trữ của hệ thống nguồn
Logical replication truyền các thay đổi ở mức logic, chẳng hạn thay đổi đối với các bảng hoặc bản ghi. Cách này có thể phù hợp khi hệ thống đích không cần có bản sao vật lý giống hoàn toàn nguồn
PostgreSQL hỗ trợ cả streaming replication ở mức physical và logical replication với mô hình publisher–subscriber
Replication trong cùng vùng và khác vùng
Các bản sao có thể nằm trên cùng một khu vực hạ tầng hoặc ở những vùng địa lý khác nhau. Amazon S3 hỗ trợ replication object giữa các bucket trong cùng Region hoặc giữa các Region, trong đó live replication có thể tự động sao chép object mới và object được cập nhật
Replication khác vùng giúp tách bản sao khỏi một điểm lỗi vật lý hoặc khu vực, nhưng đồng thời làm tăng yêu cầu về mạng, độ trễ và chi phí truyền dữ liệu
Data replication được sử dụng để làm gì trong hệ thống lưu trữ?
Replication thường được triển khai khi một hệ thống không nên phụ thuộc vào duy nhất một bản dữ liệu
Tăng khả năng sẵn sàng
Nếu hệ thống chính gặp sự cố, một bản sao phù hợp có thể được sử dụng để phục hồi hoặc chuyển vai trò thành hệ thống hoạt động chính
Mở rộng tải đọc
Một số replica có thể phục vụ truy vấn đọc thay vì để toàn bộ tải tập trung vào hệ thống chính. Read replica của cơ sở dữ liệu là mô hình điển hình
Phục hồi sau sự cố
Bản sao đặt ở vị trí hoặc vùng hạ tầng khác có thể giảm tác động của sự cố tại hệ thống nguồn. Tuy nhiên, replication không tự động thay thế backup vì lỗi logic, thao tác xóa nhầm hoặc dữ liệu hỏng có thể được truyền sang bản sao
Phân phối dữ liệu
Các bản sao ở nhiều khu vực giúp hệ thống đưa dữ liệu đến gần nơi phát sinh nhu cầu sử dụng hơn, tùy theo kiến trúc và cơ chế nhất quán được lựa chọn
Tách hệ thống lưu trữ
Replication cũng có thể được dùng khi dữ liệu cần xuất hiện trong nhiều hệ thống có vai trò khác nhau, chẳng hạn hệ thống vận hành và hệ thống phục vụ phân tích, miễn là cơ chế chuyển đổi dữ liệu đáp ứng đúng yêu cầu của từng hệ thống
Độ trễ, tính nhất quán và giới hạn của data replication cần lưu ý
Replication tạo thêm bản sao nhưng không đảm bảo mọi bản sao luôn giống nhau tại mọi thời điểm
Với asynchronous replication, replication lag là trạng thái bình thường. Nếu nguồn ghi nhanh hơn khả năng truyền hoặc áp dụng của đích, khoảng cách giữa hai hệ thống sẽ tăng
Điều này dẫn đến một số giới hạn cần xác định trước
Độ trễ dữ liệu: bản sao có thể chưa chứa thay đổi mới nhất
Rủi ro khi failover: nếu bản sao chưa nhận đủ thay đổi trước khi nguồn hỏng, dữ liệu mới nhất có thể không có trên bản sao được chuyển sang
Xung đột dữ liệu: mô hình nhiều chiều cần quy tắc xác định cách xử lý khi nhiều hệ thống cùng sửa một dữ liệu
Chi phí hiệu năng: synchronous replication có thể làm tăng thời gian phản hồi của thao tác ghi, đặc biệt khi khoảng cách mạng lớn
Chi phí hạ tầng: nhiều bản sao đồng nghĩa với thêm dung lượng lưu trữ, tài nguyên xử lý và trong một số kiến trúc là chi phí truyền dữ liệu
Do đó, thiết kế replication cần bắt đầu từ yêu cầu thực tế: dữ liệu có thể trễ bao lâu, mất bao nhiêu dữ liệu là chấp nhận được, bản sao có cần phục vụ đọc hay không, hệ thống cần chịu loại sự cố nào và việc ghi dữ liệu có được phép chậm hơn để đổi lấy mức bảo vệ cao hơn hay không
Replication phù hợp nhất khi các yêu cầu này được chuyển thành những tiêu chí vận hành cụ thể như replication lag, RPO, RTO, độ trễ ghi và khả năng chuyển đổi khi hệ thống nguồn gặp sự cố
Data replication vì thế không chỉ là tạo thêm một bản sao. Cốt lõi của nó là duy trì quan hệ giữa dữ liệu nguồn và các bản sao thông qua một cơ chế ghi nhận, truyền và áp dụng thay đổi. Việc chọn đồng bộ hay bất đồng bộ, một chiều hay nhiều chiều, physical hay logical phải dựa trên yêu cầu về nhất quán, hiệu năng, khả năng phục hồi và cách dữ liệu được sử dụng ở từng hệ thống

GỬI Ý KIẾN BÌNH LUẬN

