
Làm sao nhận biết độ chính xác của dữ liệu bị suy giảm?
Mục lục
- Độ chính xác của dữ liệu là gì?
- Độ chính xác của dữ liệu bị suy giảm như thế nào?
- Những dấu hiệu nào cho thấy dữ liệu có thể bị sai lệch?
- Cách kiểm tra độ chính xác của dữ liệu theo mức độ tin cậy
- Vì sao outlier hoặc data drift chưa đủ để kết luận dữ liệu sai?
- Quy trình theo dõi độ chính xác của dữ liệu trong thực tế
Độ chính xác của dữ liệu phản ánh dữ liệu có đúng với thực tế hay không. Có thể phát hiện suy giảm bằng đối soát, quy tắc nghiệp vụ, chỉ số sai số và kiểm tra bất thường.
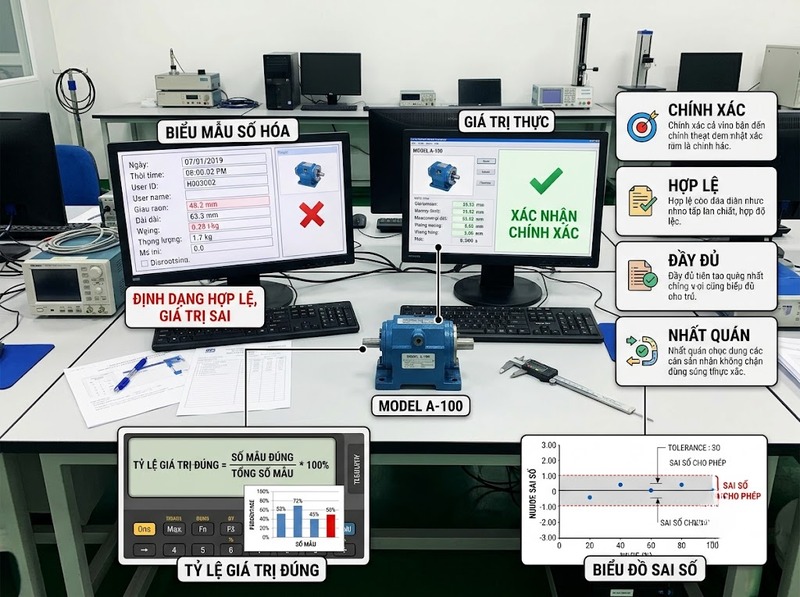
Độ chính xác của dữ liệu phản ánh mức độ một giá trị mô tả đúng đối tượng, sự kiện hoặc trạng thái thực mà nó đại diện. Một dữ liệu có thể đúng định dạng, đầy đủ và không mâu thuẫn với hệ thống nhưng vẫn sai nếu giá trị đó không đúng với thực tế.
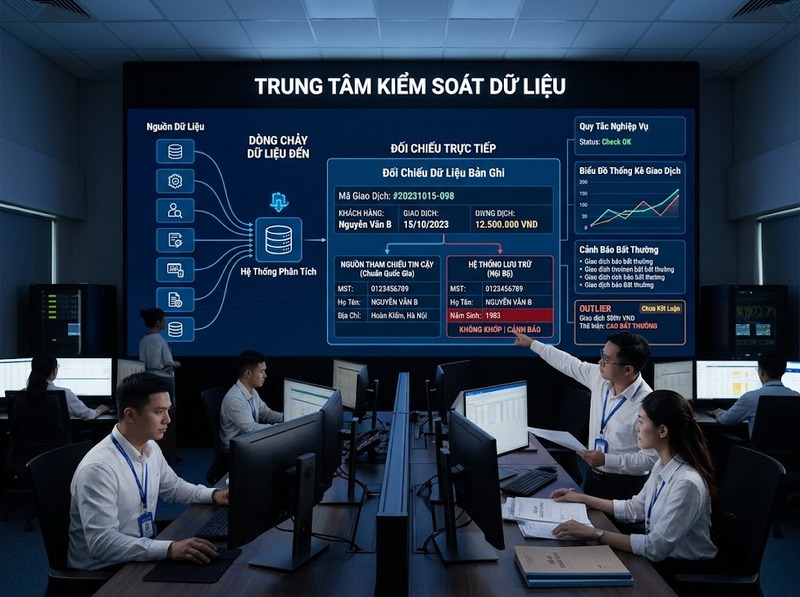
Cách chắc chắn nhất để xác định dữ liệu sai là so sánh với ground truth hoặc một nguồn tham chiếu đáng tin cậy. Khi không có nguồn chuẩn, các quy tắc nghiệp vụ, đối soát giữa hệ thống và phương pháp phát hiện bất thường chỉ cho biết dữ liệu có khả năng sai. Đặc biệt, một outlier không mặc nhiên là dữ liệu lỗi và một giá trị trông hoàn toàn bình thường vẫn có thể không chính xác.
Độ chính xác của dữ liệu là gì?
Theo cách tiếp cận của mô hình chất lượng dữ liệu ISO/IEC 25012, accuracy liên quan đến mức dữ liệu biểu diễn đúng giá trị thực của thuộc tính hoặc sự kiện trong một bối cảnh sử dụng cụ thể. Vì vậy, độ chính xác luôn gắn với câu hỏi: giá trị đang lưu có đúng với điều thực sự xảy ra hay không?
Khái niệm này cần được tách khỏi một số đặc tính chất lượng dữ liệu thường bị nhầm lẫn:
|
Đặc tính |
Câu hỏi cần kiểm tra |
|
Độ chính xác |
Giá trị có đúng với thực tế hoặc nguồn chuẩn không? |
|
Tính hợp lệ |
Giá trị có đúng định dạng, kiểu dữ liệu và quy tắc cho phép không? |
|
Tính đầy đủ |
Dữ liệu cần thiết có bị thiếu không? |
|
Tính nhất quán |
Các giá trị liên quan hoặc các hệ thống có mâu thuẫn nhau không? |
Ví dụ, địa chỉ email abc@example.com có thể vượt qua kiểm tra định dạng nhưng vẫn không chính xác nếu đó không phải email thật của khách hàng. Tương tự, một mã khách hàng có thể tồn tại hợp lệ trong cơ sở dữ liệu nhưng vẫn bị gán nhầm cho giao dịch.
Khi có giá trị chuẩn, độ chính xác của dữ liệu phân loại hoặc dữ liệu yêu cầu khớp chính xác có thể được lượng hóa:
Accuracy rate = Số giá trị được xác nhận đúng / Tổng số giá trị được kiểm tra × 100%
Với dữ liệu số, khái niệm “đúng” thường cần thêm dung sai. Khi đó có thể dùng sai số tuyệt đối trung bình (MAE), sai số bình phương trung bình căn bậc hai (RMSE) hoặc tỷ lệ giá trị nằm trong khoảng sai số chấp nhận được. Chỉ số phù hợp phụ thuộc bản chất dữ liệu và mức sai số mà nghiệp vụ cho phép.
Độ chính xác của dữ liệu bị suy giảm như thế nào?
Độ chính xác suy giảm khi mối quan hệ giữa giá trị được lưu và thực tế mà giá trị đó đại diện bị phá vỡ. Lỗi có thể phát sinh ngay tại nguồn hoặc xuất hiện trong quá trình dữ liệu được di chuyển và biến đổi.
Một số cơ chế thường gặp gồm:
· Sai tại thời điểm thu thập: Nhập nhầm, chọn nhầm đối tượng, cảm biến lệch chuẩn hoặc dữ liệu được lấy từ nguồn không còn đáng tin cậy
· Sai trong quá trình biến đổi: Mapping nhầm trường, đổi đơn vị không chính xác, làm tròn ngoài dự kiến, cắt mất chữ số hoặc áp dụng công thức sai
· Sai khi tích hợp dữ liệu: Join bằng khóa không phù hợp, ghép nhầm bản ghi hoặc đồng bộ một giá trị sang sai thực thể
· Sai do thay đổi ngữ cảnh: Đơn vị đo, múi giờ, định nghĩa trường hoặc quy tắc nghiệp vụ thay đổi nhưng pipeline vẫn xử lý theo giả định cũ
· Sai do dữ liệu tham chiếu lỗi thời: Giá trị nguồn đã thay đổi nhưng master data hoặc bảng tra cứu chưa được cập nhật
Điểm đáng chú ý là lỗi không nhất thiết tạo ra giá trị “trông vô lý”. Nếu một cảm biến luôn đo cao hơn thực tế 2°C, chuỗi số liệu vẫn có thể rất mượt và nằm trong phạm vi quen thuộc. Đây là sai lệch có hệ thống, khó phát hiện hơn một lỗi đơn lẻ tạo ra giá trị cực đoan.
Những dấu hiệu nào cho thấy dữ liệu có thể bị sai lệch?
Không phải dấu hiệu nào cũng chứng minh được dữ liệu sai. Tuy nhiên, sự xuất hiện hoặc gia tăng của các tín hiệu dưới đây là lý do để kiểm tra sâu hơn.
Giá trị vi phạm điều kiện chắc chắn phải đúng là tín hiệu mạnh nhất. Ví dụ, ngày kết thúc xảy ra trước ngày bắt đầu, tổng tiền không bằng các thành phần cấu thành hoặc một đại lượng xuất hiện ngoài phạm vi vật lý mà hệ thống có thể tạo ra.
Dữ liệu không khớp với nguồn tham chiếu đáng tin cậy cũng là dấu hiệu quan trọng. Nếu địa chỉ, trạng thái đơn hàng hoặc số dư trong hệ thống phân tích khác với system of record đã được xác nhận, cần xác định hệ thống nào phản ánh trạng thái thực tại thời điểm so sánh.
Quan hệ giữa các trường bị phá vỡ có thể tiết lộ lỗi mà kiểm tra từng trường riêng lẻ không thấy. Một giá trị có thể hợp lệ khi đứng một mình nhưng sai khi đặt cạnh các dữ liệu liên quan.
Một tín hiệu khác là tỷ lệ vi phạm hoặc sai khác tăng đột ngột theo thời gian. Nếu tỷ lệ mismatch vốn ổn định quanh một mức thấp rồi tăng mạnh ngay sau khi thay đổi nguồn dữ liệu, schema hoặc pipeline, nguyên nhân nhiều khả năng nằm ở quá trình thu thập hay biến đổi.
Cuối cùng, cần chú ý đến sai lệch có tính hệ thống. Lỗi tập trung ở một nguồn, chi nhánh, thiết bị, phiên bản phần mềm hoặc khoảng thời gian thường cung cấp nhiều thông tin hơn việc chỉ biết toàn bộ tập dữ liệu có một số outlier.
Cách kiểm tra độ chính xác của dữ liệu theo mức độ tin cậy
Khi có ground truth hoặc nguồn tham chiếu
Đây là trường hợp có khả năng kết luận cao nhất. Có thể lấy mẫu hoặc kiểm tra toàn bộ dữ liệu rồi đối chiếu từng giá trị với nguồn được xem là đúng.
Với dữ liệu cần khớp tuyệt đối, theo dõi accuracy rate hoặc error rate là đủ trực quan. Với đại lượng liên tục như nhiệt độ, khoảng cách hoặc số đo thiết bị, nên đo độ lớn sai số thay vì chỉ phân loại đúng/sai.
MAE cho biết trung bình mỗi quan sát lệch bao nhiêu đơn vị so với giá trị chuẩn. RMSE nhạy hơn với các sai số lớn vì phần sai lệch được bình phương trước khi lấy trung bình. Nếu nghiệp vụ chấp nhận một khoảng dung sai, tỷ lệ giá trị nằm ngoài dung sai thường dễ chuyển thành cảnh báo vận hành hơn.
Khi không có ground truth
Không có nguồn chuẩn không đồng nghĩa với việc không thể kiểm soát chất lượng, nhưng kết luận cần thận trọng hơn.
Có thể triển khai các lớp kiểm tra như:
· Quy tắc miền giá trị và quy tắc nghiệp vụ
· Đối soát giữa hai hệ thống độc lập
· Kiểm tra quan hệ giữa các trường
· So sánh tổng hợp trước và sau các bước ETL
· Kiểm tra một mẫu dữ liệu bằng con người hoặc nguồn bên ngoài đáng tin cậy
· Theo dõi tỷ lệ bản ghi vi phạm các quy tắc đã xác định
Ví dụ:
Violation rate = Số bản ghi vi phạm quy tắc / Tổng số bản ghi được kiểm tra × 100%
Tỷ lệ này hữu ích để phát hiện sự thay đổi về chất lượng, nhưng không nên gọi nó là “tỷ lệ dữ liệu không chính xác” nếu chưa xác nhận các bản ghi vi phạm thực sự sai.
Dùng thống kê để phát hiện giá trị đáng nghi
Phương pháp thống kê đặc biệt hữu ích khi khối lượng dữ liệu quá lớn để kiểm tra thủ công. Một kỹ thuật phổ biến là sử dụng khoảng tứ phân vị IQR. Với:
IQR = Q3 − Q1
các quan sát nhỏ hơn Q1 − 1,5 × IQR hoặc lớn hơn Q3 1,5 × IQR thường được gắn cờ là outlier để điều tra.
Ngưỡng 1,5 × IQR chỉ là quy tắc sàng lọc phổ biến, không phải tiêu chuẩn xác định một giá trị đúng hay sai. Phân phối lệch, dữ liệu theo mùa hoặc những sự kiện hiếm nhưng hợp lệ có thể tạo nhiều outlier hoàn toàn chính xác.
Tương tự, một sự thay đổi rõ rệt trong phân phối dữ liệu theo ngày, tuần hoặc theo nguồn có thể báo hiệu pipeline gặp lỗi, nhưng cũng có thể phản ánh hành vi thực tế đã thay đổi. Vì vậy, drift cần được kiểm tra cùng bối cảnh nghiệp vụ và các thay đổi của hệ thống.
Không tồn tại một ngưỡng độ chính xác chung phù hợp cho mọi bộ dữ liệu. Mức chấp nhận phải dựa trên tác động của sai số, độ biến thiên tự nhiên, độ tin cậy của nguồn tham chiếu và các yêu cầu hợp đồng, kỹ thuật hoặc quy định nếu có.
Vì sao outlier hoặc data drift chưa đủ để kết luận dữ liệu sai?
Phát hiện bất thường trả lời câu hỏi “giá trị này có khác mẫu thông thường không?”, trong khi kiểm tra độ chính xác trả lời “giá trị này có đúng với thực tế không?”. Hai câu hỏi có liên quan nhưng không tương đương.
|
Biểu hiện thống kê |
Giá trị thực tế |
Ý nghĩa |
|
Bất thường |
Đúng |
Sự kiện hiếm nhưng có thật |
|
Bất thường |
Sai |
Lỗi dễ được hệ thống phát hiện |
|
Bình thường |
Sai |
Lỗi khó phát hiện vì giá trị vẫn hợp lý |
|
Bình thường |
Đúng |
Trường hợp thông thường |
Một giao dịch lớn bất thường có thể hoàn toàn hợp lệ. Ngược lại, mã của một khách hàng bị thay bằng mã của khách hàng khác vẫn có thể đúng định dạng, tồn tại trong hệ thống và không tạo bất kỳ outlier số học nào.
Sai lệch có hệ thống cũng có thể ẩn trong vùng “bình thường”. Nếu toàn bộ thiết bị của một lô sản xuất cùng đo lệch theo một hướng nhỏ, phân phối nội bộ của chúng vẫn có thể ổn định. Chỉ khi đối chiếu với chuẩn hoặc thiết bị tham chiếu mới xác định được lỗi.
Do đó, anomaly detection phù hợp để ưu tiên những điểm cần kiểm tra, không nên được dùng một mình để gắn nhãn dữ liệu là sai.
Quy trình theo dõi độ chính xác của dữ liệu trong thực tế
Một hệ thống kiểm soát hiệu quả nên bắt đầu từ các trường dữ liệu quan trọng thay vì cố kiểm tra mọi cột với cùng mức độ.
1. Xác định dữ liệu cần bảo vệ
2. Chọn các trường có ảnh hưởng trực tiếp đến báo cáo, giao dịch, quyết định hoặc quy trình vận hành. Mỗi trường cần có định nghĩa rõ về ý nghĩa, đơn vị và thời điểm mà giá trị đại diện
3. Xác định nguồn chuẩn hoặc cách xác minh
4. Ưu tiên ground truth, system of record hoặc nguồn tham chiếu đã được kiểm soát. Nếu không có, phải ghi rõ rằng kết quả từ rule và thống kê chỉ là chỉ báo gián tiếp
5. Thiết lập quy tắc và dung sai
6. Xác định miền giá trị, quan hệ giữa các trường, mức sai số số học cho phép và các trường hợp ngoại lệ hợp lệ. Dung sai nên dựa trên nhu cầu nghiệp vụ thay vì chọn một tỷ lệ tùy ý
7. Theo dõi chỉ số theo nguồn và thời gian
8. Tùy loại dữ liệu, có thể dùng accuracy rate, mismatch rate, violation rate, MAE hoặc tỷ lệ vượt dung sai. Phân tách chỉ số theo nguồn, hệ thống, thiết bị hoặc phiên bản pipeline giúp phát hiện lỗi cục bộ mà số trung bình toàn hệ thống có thể che khuất
9. Cảnh báo theo cả ngưỡng và thay đổi so với baseline
10. Một hệ thống vẫn có thể nằm trong giới hạn tuyệt đối nhưng chất lượng đang giảm dần. Theo dõi mức thay đổi so với lịch sử giúp phát hiện suy giảm sớm hơn
11. Xác minh các cảnh báo trước khi kết luận
12. Lấy mẫu bản ghi bị gắn cờ, đối chiếu lại với nguồn và phân loại rõ “đã xác nhận sai” với “bất thường cần điều tra”. Cách phân biệt này tránh biến mô hình phát hiện bất thường thành một thước đo độ chính xác giả
Nếu chưa có ground truth, cách an toàn hơn là báo cáo tỷ lệ bản ghi đáng nghi hoặc tỷ lệ vi phạm quy tắc, thay vì công bố một con số “độ chính xác 98%” mà không có cơ sở xác nhận hai phần trăm còn lại thực sự sai.
Độ chính xác của dữ liệu được xác định bởi mức độ dữ liệu phản ánh đúng thực tế, không phải bởi việc giá trị trông hợp lý hay vượt qua kiểm tra định dạng. Mức tin cậy cao nhất đến từ đối chiếu với ground truth hoặc nguồn chuẩn; quy tắc nghiệp vụ và thống kê đóng vai trò phát hiện dấu hiệu khi nguồn chuẩn không sẵn có. Muốn nhận biết chất lượng đang suy giảm, cần theo dõi sai khác theo thời gian và theo nguồn, xác minh các cảnh báo, đồng thời luôn tách biệt dữ liệu bất thường khỏi dữ liệu đã được chứng minh là sai.

GỬI Ý KIẾN BÌNH LUẬN

