
Tính đầy đủ của dữ liệu ảnh hưởng phân tích thế nào?
Mục lục
Tính đầy đủ của dữ liệu quyết định mức độ đáng tin của phân tích. Khi dữ liệu bị thiếu không đúng cách, kết quả có thể sai lệch, khó kiểm chứng và dẫn đến kết luận không phản ánh đúng thực tế
Tính đầy đủ của dữ liệu là mức độ mà tập dữ liệu có đủ các thông tin cần thiết để trả lời câu hỏi phân tích mà không tạo ra khoảng trống làm thay đổi đáng kể kết quả. Một bộ dữ liệu có nhiều bản ghi chưa chắc đã đầy đủ: nếu thiếu biến quan trọng, thiếu nhóm đối tượng cần phân tích hoặc thiếu dữ liệu ở một giai đoạn then chốt, kết luận vẫn có thể bị sai lệch.
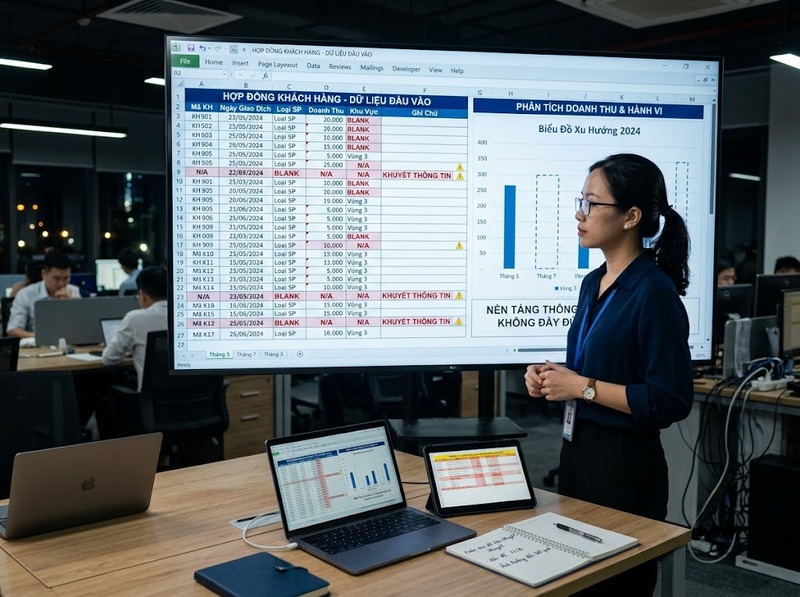
Điểm quan trọng là dữ liệu thiếu không tự động khiến mọi phân tích sai. Rủi ro xuất hiện khi phần thiếu có liên quan đến biến đang được đo, nhóm đối tượng hoặc cơ chế tạo ra kết quả. Vì vậy, đánh giá tính đầy đủ phải gắn với mục tiêu phân tích chứ không chỉ dựa trên số ô dữ liệu bị trống.
Tính đầy đủ của dữ liệu là gì?
Tính đầy đủ của dữ liệu phản ánh việc những thông tin cần thiết cho một mục tiêu phân tích đã được thu thập ở mức phù hợp hay chưa. Có thể xem đây là một thuộc tính của chất lượng dữ liệu, nhưng nó không đồng nghĩa với việc mọi trường dữ liệu đều phải có giá trị.
Chẳng hạn, nếu phân tích doanh thu theo khu vực, việc thiếu một trường không liên quan có thể không ảnh hưởng đáng kể. Ngược lại, nếu phần lớn doanh thu không có thông tin khu vực, việc so sánh giữa các khu vực sẽ mất cơ sở.
Có ba câu hỏi cần đặt ra:
· Dữ liệu có bao phủ đủ đối tượng cần nghiên cứu không
· Các biến cần thiết cho câu hỏi phân tích có được thu thập không
· Phần dữ liệu bị thiếu có tập trung ở một nhóm, thời điểm hoặc điều kiện cụ thể không
Vì vậy, tính đầy đủ phải được đánh giá theo mục đích sử dụng dữ liệu, thay vì chỉ hỏi "có bao nhiêu dữ liệu bị thiếu".
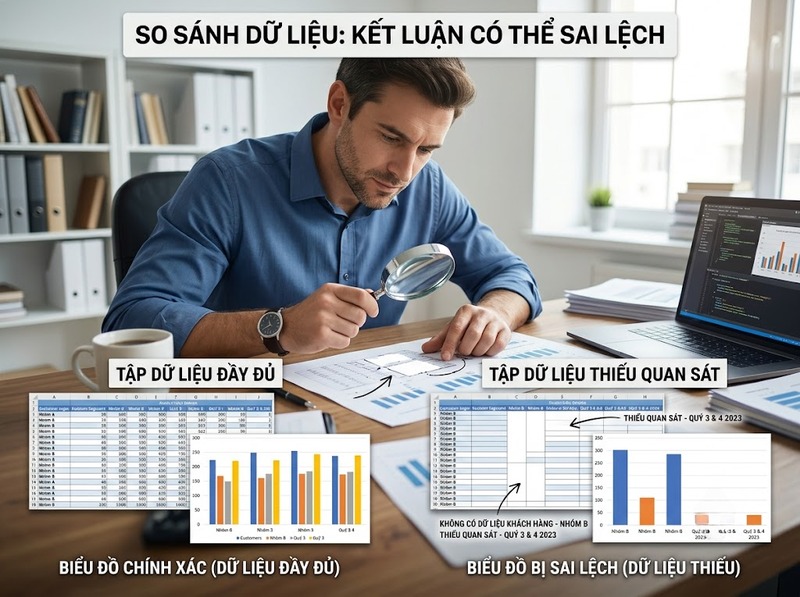
Vì sao dữ liệu thiếu có thể làm thay đổi kết quả phân tích?
Dữ liệu thiếu tạo rủi ro lớn nhất khi phần bị thiếu không phân bố ngẫu nhiên. Nếu các bản ghi thiếu dữ liệu có đặc điểm khác với những bản ghi còn lại, mẫu dữ liệu được sử dụng để phân tích có thể không còn đại diện cho tổng thể ban đầu.
Ví dụ, một doanh nghiệp muốn đánh giá mức độ hài lòng của khách hàng nhưng chỉ nhận được phản hồi từ những người chủ động điền khảo sát. Nếu nhóm khách hàng không hài lòng ít phản hồi hơn, điểm hài lòng trung bình có thể cao hơn thực tế.
Cơ chế sai lệch thường diễn ra theo chuỗi:
Dữ liệu bị thiếu → tập dữ liệu phân tích thay đổi → phân bố quan sát thay đổi → ước lượng thay đổi → kết luận có thể sai
Điều này cho thấy vấn đề không nằm đơn thuần ở số lượng dữ liệu thiếu. Một tỷ lệ thiếu nhỏ nhưng tập trung đúng vào nhóm có ảnh hưởng lớn đến kết quả vẫn có thể nguy hiểm hơn một tỷ lệ thiếu cao nhưng phân bố tương đối đồng đều.
Những dạng thiếu dữ liệu nào đáng lo ngại?
Không phải mọi khoảng trống dữ liệu đều có mức rủi ro giống nhau. Có thể phân biệt dựa trên vị trí và nguyên nhân của phần thiếu.
Thiếu một phần giá trị của biến
Một số bản ghi có dữ liệu, trong khi các bản ghi khác không có. Nếu biến đó đóng vai trò quan trọng trong mô hình hoặc phép so sánh, việc loại bỏ các bản ghi thiếu có thể làm thay đổi thành phần của mẫu.
Thiếu cả một nhóm đối tượng
Đây thường là trường hợp nghiêm trọng hơn. Ví dụ, dữ liệu khảo sát có đầy đủ người dùng lâu năm nhưng gần như không có người dùng mới. Khi đó, kết quả có thể phản ánh rất tốt nhóm lâu năm nhưng không thể đại diện cho toàn bộ người dùng.
Thiếu dữ liệu theo thời gian
Nếu dữ liệu của một số tháng, quý hoặc giai đoạn quan trọng bị mất, việc phân tích xu hướng có thể trở nên sai lệch. Một biến động xảy ra đúng trong khoảng thời gian bị thiếu sẽ không được phản ánh trong kết quả.
Thiếu dữ liệu có hệ thống
Đây là trường hợp cần đặc biệt thận trọng. Nếu khả năng một giá trị bị thiếu phụ thuộc vào chính đặc điểm của đối tượng hoặc kết quả cần phân tích, phần dữ liệu còn lại có thể tạo ra một bức tranh khác với thực tế.
Vì vậy, khi phát hiện dữ liệu thiếu, câu hỏi quan trọng không chỉ là "thiếu bao nhiêu?" mà còn là "thiếu ở đâu và vì sao?"
Làm thế nào để biết dữ liệu chưa đủ cho một phân tích?
Có thể bắt đầu bằng việc đối chiếu dữ liệu hiện có với yêu cầu của câu hỏi phân tích.
Trước hết, xác định đơn vị phân tích và phạm vi cần bao phủ. Nếu muốn kết luận về toàn bộ khách hàng nhưng dữ liệu chỉ đại diện cho một nhóm khách hàng, vấn đề không chỉ là thiếu giá trị mà là thiếu phạm vi quan sát.
Tiếp theo, kiểm tra các biến quan trọng và tỷ lệ giá trị thiếu của từng biến. Tuy nhiên, một tỷ lệ phần trăm tổng thể chưa đủ để đánh giá rủi ro. Cần kiểm tra thêm việc thiếu dữ liệu có tập trung theo:
· Nhóm đối tượng
· Thời gian
· Khu vực
· Sản phẩm hoặc dịch vụ
· Mức độ sử dụng
· Kết quả cần phân tích
Cuối cùng, cần kiểm tra liệu kết luận có thay đổi khi xử lý phần dữ liệu thiếu theo những cách hợp lý khác nhau hay không. Nếu kết quả thay đổi mạnh, dữ liệu thiếu đang là một nguồn bất định quan trọng và cần được phản ánh trong kết luận.
Dữ liệu thiếu ảnh hưởng thế nào đến độ tin cậy của kết luận?
Ảnh hưởng có thể xuất hiện ở nhiều tầng khác nhau.
Thứ nhất, làm giảm khả năng đại diện. Mẫu phân tích có thể không còn phản ánh đúng tổng thể mà người phân tích muốn kết luận.
Thứ hai, làm sai các phép so sánh. Nếu một nhóm có tỷ lệ thiếu cao hơn nhóm còn lại, chênh lệch quan sát được có thể không phải chênh lệch thực tế.
Thứ ba, làm suy yếu mô hình phân tích. Khi biến quan trọng bị thiếu, mô hình có thể phải sử dụng ít quan sát hơn hoặc dựa trên thông tin không đầy đủ.
Thứ tư, làm tăng bất định nhưng không phải lúc nào cũng được nhận ra. Một kết quả có thể trông rất chính xác về mặt tính toán, trong khi vấn đề thực sự nằm ở dữ liệu đầu vào.
Do đó, cần phân biệt độ chính xác của phép tính với độ đáng tin của kết luận. Một phép tính hoàn toàn chính xác trên dữ liệu không đầy đủ vẫn có thể dẫn đến kết luận sai.
Làm gì khi dữ liệu không đầy đủ?
Cách xử lý phải phụ thuộc vào nguyên nhân, mức độ và vai trò của phần dữ liệu thiếu. Không nên mặc định rằng cứ loại bỏ các bản ghi thiếu là có thể giải quyết vấn đề.
Một quy trình hợp lý gồm:
1. Xác định dữ liệu nào đang thiếu: Phân biệt thiếu giá trị, thiếu biến, thiếu nhóm đối tượng và thiếu giai đoạn thời gian
2. Tìm nguyên nhân thiếu: Xác định phần thiếu xuất hiện ngẫu nhiên hay tập trung vào một nhóm cụ thể
3. Đánh giá mức độ ảnh hưởng: Kiểm tra phần thiếu có liên quan trực tiếp đến câu hỏi và kết luận cần đưa ra hay không
4. Chọn phương án xử lý phù hợp: Có thể bổ sung dữ liệu, loại bỏ có kiểm soát, hoặc sử dụng phương pháp xử lý dữ liệu thiếu phù hợp với bối cảnh
5. Kiểm tra độ nhạy của kết quả: So sánh kết quả dưới các cách xử lý hợp lý khác nhau
6. Ghi rõ giới hạn: Nếu dữ liệu vẫn chưa đủ để hỗ trợ một kết luận chắc chắn, cần thu hẹp phạm vi kết luận thay vì diễn giải quá mức
Nguyên tắc quan trọng là không biến dữ liệu thiếu thành một giả định vô hình. Nếu phải ước lượng hoặc thay thế giá trị thiếu, phần xử lý đó cần được xem là một nguồn bất định của phân tích.
Tính đầy đủ của dữ liệu không đơn giản là có ít hay nhiều ô trống. Điều quyết định là dữ liệu còn thiếu có làm mất đi thông tin cần thiết để trả lời câu hỏi phân tích hay không. Khi phần thiếu tập trung ở nhóm, thời gian hoặc biến quan trọng, kết quả có thể mất tính đại diện và dẫn đến kết luận sai dù phép tính được thực hiện hoàn toàn chính xác. Vì vậy, một phân tích đáng tin cậy cần đánh giá đồng thời mức độ thiếu, vị trí thiếu, nguyên nhân thiếu và tác động của phần thiếu lên kết luận.

GỬI Ý KIẾN BÌNH LUẬN

