
Batch processing phù hợp với những loại tác vụ nào?
Mục lục
- Batch processing là gì và hoạt động theo cơ chế nào?
- Những đặc điểm nào khiến một tác vụ phù hợp với batch processing?
- Batch processing phù hợp với những loại tác vụ nào?
- Khi nào batch processing không phải lựa chọn phù hợp?
- Những yếu tố cần cân nhắc khi thiết kế batch processing
- Batch processing có ưu điểm và giới hạn gì?
Batch processing là phương thức gom dữ liệu hoặc công việc thành từng lô để xử lý theo lịch hoặc khi đủ điều kiện, phù hợp với các tác vụ khối lượng lớn, lặp lại và không yêu cầu phản hồi ngay lập tức
Batch processing, hay xử lý dữ liệu theo lô, là cách tổ chức công việc trong đó dữ liệu hoặc các tác vụ được gom thành một nhóm rồi xử lý cùng nhau thay vì xử lý ngay từng bản ghi khi phát sinh. Mô hình này đặc biệt phù hợp với các công việc có tính lặp lại, khối lượng lớn, có thể lập lịch và không yêu cầu kết quả tức thời.
Batch processing là gì và hoạt động theo cơ chế nào?
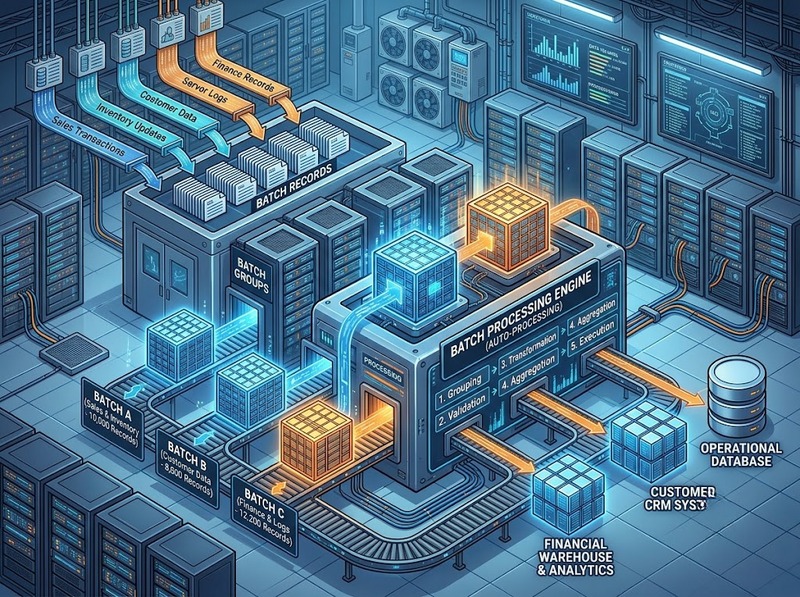
Trong batch processing, hệ thống trước tiên thu thập dữ liệu hoặc xác định một tập công việc cần xử lý. Đến một thời điểm định trước, khi đạt đủ số lượng hoặc khi một điều kiện được kích hoạt, hệ thống bắt đầu chạy job trên toàn bộ lô dữ liệu đó.
Một quy trình batch điển hình có thể gồm:
1. Thu thập dữ liệu đầu vào
2. Gom dữ liệu thành một batch
3. Đưa batch vào hàng đợi hoặc lịch thực thi
4. Đọc và xử lý dữ liệu theo các bước đã định nghĩa
5. Ghi kết quả sang hệ thống đích
6. Ghi log, kiểm tra trạng thái và xử lý lỗi nếu có
Các job có thể chạy tuần tự hoặc song song, tùy thuộc vào quan hệ phụ thuộc và cách thiết kế hệ thống.
Điểm quan trọng là batch processing không đồng nghĩa với việc dữ liệu phải được xử lý vào ban đêm. “Theo lô” mô tả cách gom và thực thi công việc, còn thời điểm chạy có thể là mỗi giờ, mỗi ngày, mỗi tuần, khi đủ số bản ghi hoặc theo một lịch khác.
Những đặc điểm nào khiến một tác vụ phù hợp với batch processing?
Batch processing phù hợp nhất khi tác vụ có một hoặc nhiều đặc điểm sau:
· Khối lượng dữ liệu lớn: Hệ thống phải xử lý nhiều bản ghi hoặc nhiều job tương tự
· Tính lặp lại cao: Quy trình được thực hiện theo cùng một logic trong nhiều chu kỳ
· Có thể trì hoãn kết quả: Người dùng không cần kết quả ngay sau khi dữ liệu phát sinh
· Có lịch xử lý rõ ràng: Công việc có thể chạy theo giờ, ngày, tuần hoặc chu kỳ nghiệp vụ
· Ít tương tác trực tiếp: Job có thể chạy tự động sau khi được cấu hình
· Có thể gom dữ liệu: Nhiều bản ghi có thể được xử lý chung mà không làm thay đổi ý nghĩa nghiệp vụ
Ngược lại, nếu người dùng cần phản hồi gần như ngay lập tức sau mỗi sự kiện, xử lý theo thời gian thực hoặc streaming thường phù hợp hơn.
Batch processing phù hợp với những loại tác vụ nào?
ETL và đồng bộ dữ liệu định kỳ
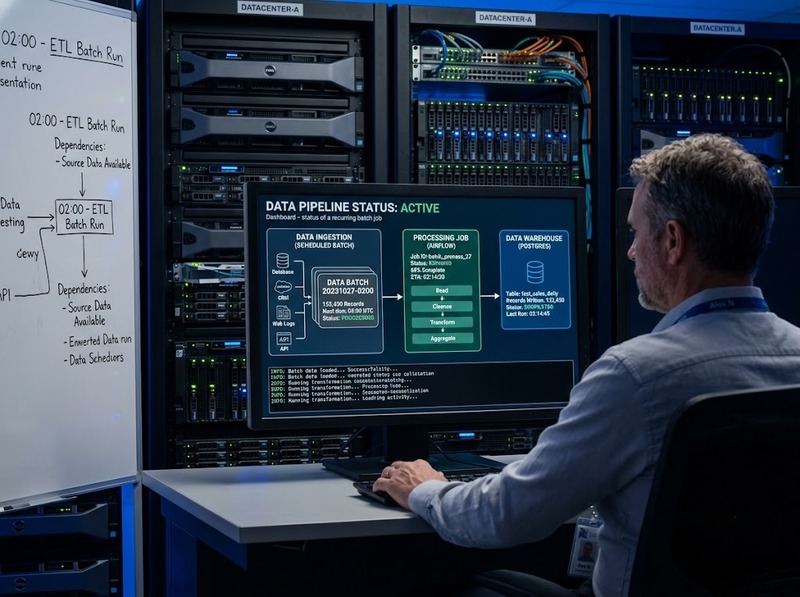
Đây là một nhóm tác vụ điển hình của batch processing. Hệ thống có thể lấy dữ liệu từ nhiều nguồn, làm sạch, biến đổi rồi nạp vào kho dữ liệu theo lịch.
Ví dụ, dữ liệu giao dịch phát sinh trong ngày có thể được tổng hợp vào cuối ngày để cập nhật kho dữ liệu phục vụ báo cáo và phân tích.
Mô hình này phù hợp khi dữ liệu không cần xuất hiện ngay trong hệ thống phân tích mà có thể được cập nhật theo các đợt.
Tổng hợp và tạo báo cáo
Các báo cáo định kỳ thường không cần tính toán lại sau từng giao dịch. Hệ thống có thể gom dữ liệu trong một khoảng thời gian rồi thực hiện các phép tổng hợp như doanh thu, số đơn hàng, tồn kho hoặc các chỉ số vận hành.
Batch processing đặc biệt hữu ích khi báo cáo cần quét lượng dữ liệu lớn và có lịch phát hành cố định.
Tính lương, thanh toán và đối soát
Các quy trình nghiệp vụ theo chu kỳ cũng phù hợp với xử lý theo lô. Ví dụ, doanh nghiệp có thể gom dữ liệu chấm công để tính lương theo kỳ, xử lý các khoản thanh toán định kỳ hoặc thực hiện đối soát giao dịch.
Những công việc này thường có thời điểm chốt dữ liệu và không nhất thiết phải hoàn thành ngay khi từng bản ghi xuất hiện.
Sao lưu, chuyển đổi và xử lý tệp
Batch processing có thể được dùng để thực hiện các công việc như sao lưu dữ liệu, chuyển đổi định dạng tệp, nén dữ liệu hoặc xử lý một thư mục lớn theo lịch.
Đây là những tác vụ có khối lượng công việc tương đối lớn nhưng không nhất thiết cần tương tác liên tục với người dùng.
Xử lý dữ liệu cho phân tích và machine learning
Các pipeline phân tích có thể sử dụng batch để thu thập dữ liệu, làm sạch, biến đổi và tạo tập dữ liệu phục vụ phân tích hoặc huấn luyện mô hình.
Batch cũng phù hợp với những workload tính toán lớn có thể xếp hàng và chạy tự động thay vì yêu cầu người dùng theo dõi từng bước.
Khi nào batch processing không phải lựa chọn phù hợp?
Batch processing không phải giải pháp tối ưu cho mọi loại dữ liệu. Vấn đề cốt lõi là độ trễ có thể chấp nhận được.
Nếu một sự kiện cần tạo phản hồi ngay, việc chờ đến batch tiếp theo có thể làm giảm giá trị của hệ thống. Ví dụ, phát hiện gian lận trong giao dịch, cập nhật trạng thái trực tiếp cho người dùng hoặc xử lý dữ liệu cảm biến cần độ trễ thấp thường có yêu cầu khác với một báo cáo cuối ngày.
Có thể phân biệt đơn giản:
|
Nhu cầu |
Phương thức phù hợp |
|
Xử lý dữ liệu theo chu kỳ |
Batch processing |
|
Xử lý lượng dữ liệu lớn không cần phản hồi ngay |
Batch processing |
|
Tạo báo cáo định kỳ |
Batch processing |
|
Cần phản hồi ngay sau khi sự kiện xảy ra |
Real-time/stream processing |
|
Phân tích dữ liệu liên tục |
Stream processing thường phù hợp hơn |
Ranh giới này không tuyệt đối. Một hệ thống thực tế có thể kết hợp batch và stream processing, trong đó mỗi phương thức đảm nhận phần workload phù hợp với yêu cầu về độ trễ và khối lượng.
Những yếu tố cần cân nhắc khi thiết kế batch processing
Một batch job không chỉ cần xác định dữ liệu nào sẽ được xử lý mà còn phải xác định cách hệ thống vận hành khi khối lượng dữ liệu và điều kiện thực thi thay đổi.
Các yếu tố quan trọng gồm:
· Batch size: Mỗi lần xử lý bao nhiêu bản ghi hoặc đơn vị công việc
· Lịch chạy: Job chạy theo thời gian cố định hay theo điều kiện
· Dependency: Job nào phải hoàn thành trước job nào
· Retry: Xử lý thế nào khi một job thất bại
· Monitoring: Theo dõi trạng thái, thời gian chạy và lỗi ra sao
· Resource allocation: Cấp CPU, bộ nhớ hoặc tài nguyên tính toán theo workload thế nào
· SLA và thời gian hoàn thành: Batch phải hoàn tất trong khoảng thời gian nào
Khi batch quá lớn, một lần chạy có thể tiêu tốn nhiều tài nguyên hoặc khó khôi phục khi thất bại. Nếu batch quá nhỏ, hệ thống có thể phải khởi động và quản lý quá nhiều job, làm tăng overhead. Vì vậy, batch size và lịch chạy cần được xác định dựa trên khối lượng dữ liệu, thời gian xử lý và yêu cầu nghiệp vụ.
Batch processing có ưu điểm và giới hạn gì?
Batch processing có lợi thế rõ rệt khi workload có tính lặp lại và có thể tự động hóa. Việc gom nhiều đơn vị công việc cho phép hệ thống tổ chức tài nguyên tập trung, giảm nhu cầu xử lý thủ công và tận dụng những khoảng thời gian tài nguyên sẵn có.
Tuy nhiên, mô hình này đánh đổi bằng độ trễ. Dữ liệu thường phải chờ đến lần chạy tiếp theo mới được xử lý. Ngoài ra, một job xử lý lượng dữ liệu lớn có thể tạo ra yêu cầu đáng kể về tài nguyên, thời gian chạy, lưu trữ trung gian và cơ chế phục hồi lỗi.
Do đó, không nên chọn batch chỉ vì dữ liệu có số lượng lớn. Câu hỏi quan trọng hơn là: kết quả có cần xuất hiện ngay khi dữ liệu phát sinh hay có thể chờ đến một chu kỳ xử lý?
Batch processing phù hợp khi câu trả lời là có thể chờ.
Batch processing phù hợp nhất với các tác vụ khối lượng lớn, lặp lại, có thể gom dữ liệu và không yêu cầu phản hồi tức thời, chẳng hạn ETL định kỳ, tổng hợp báo cáo, tính lương, đối soát, sao lưu, chuyển đổi dữ liệu và một số workload phân tích hoặc machine learning. Khi yêu cầu chuyển sang phản hồi tức thời, xử lý liên tục hoặc độ trễ thấp, kiến trúc real-time hoặc stream processing thường phù hợp hơn.
Vì vậy, tiêu chí quan trọng nhất để xác định có nên dùng batch processing không phải chỉ là dữ liệu nhiều hay ít, mà là đặc tính của workload, khả năng trì hoãn kết quả và chu kỳ mà nghiệp vụ yêu cầu.

GỬI Ý KIẾN BÌNH LUẬN

