
Dữ liệu di chuyển qua data pipeline như thế nào?
Mục lục
Data pipeline là chuỗi bước đưa dữ liệu từ hệ thống nguồn qua thu nhận, xử lý và kiểm tra đến nơi lưu trữ hoặc ứng dụng đích. Hiểu luồng này giúp phân biệt ETL, ELT, batch và streaming, đồng thời xác định dữ liệu được biến đổi ở đâu.
Một data pipeline xác định cách dữ liệu được đọc từ nguồn, chuyển qua các bước trung gian, xử lý khi cần và ghi vào hệ thống đích. Pipeline có thể chỉ di chuyển dữ liệu nguyên trạng hoặc thực hiện thêm các thao tác như kiểm tra, làm sạch, đổi cấu trúc, kết hợp và tổng hợp.
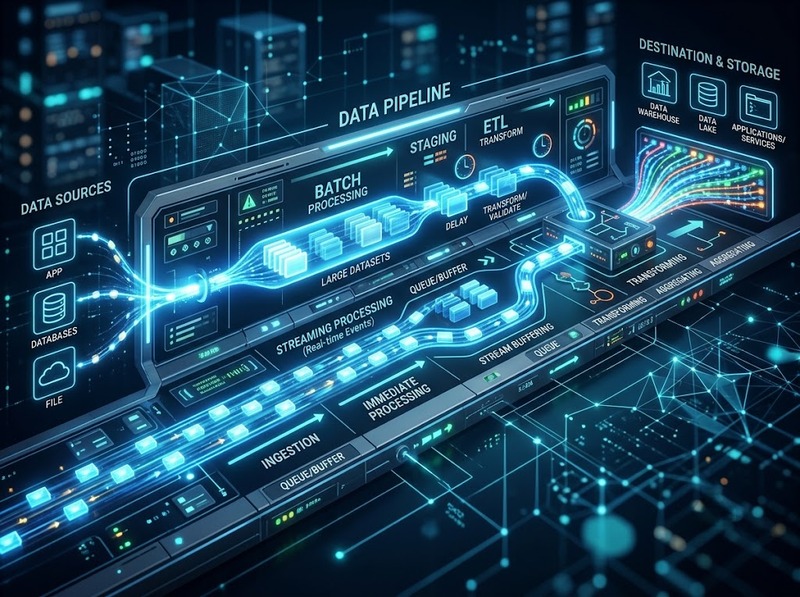
“Pipeline” là luồng xử lý logic, không nhất thiết là một đường truyền vật lý duy nhất. Dữ liệu có thể đi theo từng lô, đi liên tục khi sự kiện phát sinh, qua vùng đệm trung gian hoặc được tải vào nơi lưu trữ trước khi biến đổi.
Data pipeline là chuỗi xử lý nối nguồn với đích
Ở mức cơ bản, data pipeline gồm một chuỗi stage kết nối việc đọc dữ liệu với việc ghi kết quả. Google Cloud mô tả pipeline theo mô hình tương tự: đọc từ một hoặc nhiều source, thực hiện transform và ghi tới destination; một pipeline cũng có thể chỉ di chuyển dữ liệu mà không cần transform.
Luồng điển hình có thể hình dung như sau:
1. Nguồn tạo hoặc lưu dữ liệu
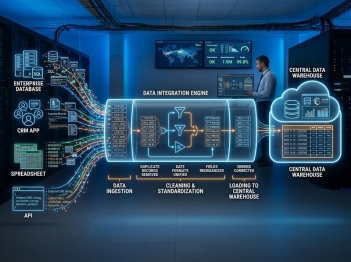
2. Lớp ingestion đọc hoặc nhận dữ liệu từ nguồn
3. Dữ liệu được truyền trực tiếp hoặc giữ tạm trong buffer, queue hay staging area
4. Các bước processing kiểm tra, làm sạch hoặc biến đổi dữ liệu nếu cần
5. Dữ liệu được load hoặc ghi vào sink
6. Hệ thống phía sau đọc và sử dụng dữ liệu tại đích
Không phải pipeline nào cũng có đầy đủ các bước trên. Một pipeline sao chép dữ liệu từ hệ thống A sang hệ thống B mà không biến đổi vẫn là data pipeline. ETL chỉ là một loại pipeline cụ thể, không phải tên gọi khác của mọi data pipeline. AWS cũng phân biệt rõ ETL với data pipeline theo điểm này.
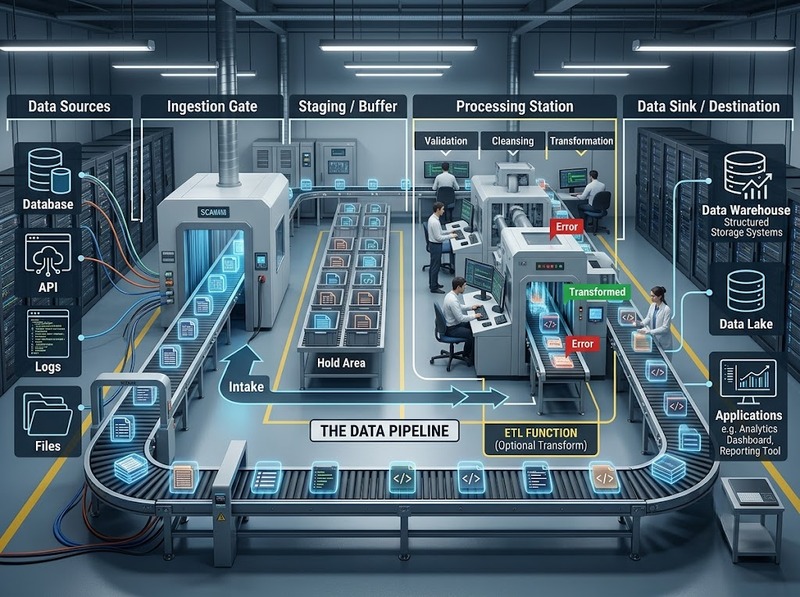
Dữ liệu rời nguồn qua lớp ingestion như thế nào?
Source có thể là cơ sở dữ liệu giao dịch, tệp, API, ứng dụng, log hoặc hệ thống phát sự kiện. Ingestion là giai đoạn pipeline lấy dữ liệu từ các nguồn đó để đưa vào luồng xử lý.
Cách lấy dữ liệu phụ thuộc vào cách nguồn thay đổi. Một pipeline có thể đọc một snapshot lớn theo lịch hoặc chỉ lấy phần mới và phần đã thay đổi. Cách thứ hai thường được gọi là incremental ingestion; change data capture (CDC) là một cơ chế thường dùng để nhận biết những thay đổi cần đồng bộ thay vì xử lý lại toàn bộ dữ liệu nguồn ở mỗi chu kỳ.
Sau ingestion, dữ liệu không bắt buộc phải đi thẳng vào bước transform. Queue, buffer hoặc staging area có thể giữ dữ liệu tạm thời khi tốc độ phát sinh dữ liệu và tốc độ xử lý không giống nhau. Lớp trung gian cũng có thể tách source khỏi processor để một phía không phải chờ phía còn lại ở mọi thời điểm.
Vùng đệm không phải điều kiện bắt buộc của data pipeline. Nếu source và stage tiếp theo có thể trao đổi trực tiếp với nhau theo yêu cầu vận hành, dữ liệu có thể được chuyển thẳng mà không qua staging.
Xử lý và biến đổi diễn ra ở đâu trong pipeline?
Sau khi được thu nhận, dữ liệu có thể được giữ nguyên hoặc trải qua các phép xử lý như chuẩn hóa định dạng, đổi kiểu dữ liệu, loại bản ghi không hợp lệ, kiểm tra quy tắc, nối nhiều nguồn, làm giàu thông tin hoặc tổng hợp.
Vị trí của transform không cố định. Nó phụ thuộc vào thứ tự mà pipeline sử dụng để extract, load và transform.
ETL biến đổi trước khi tải
ETL là viết tắt của Extract, Transform, Load. Dữ liệu được lấy khỏi nguồn, biến đổi theo các quy tắc cần thiết rồi mới nạp vào hệ thống đích.
Với mô hình này, dữ liệu đi theo thứ tự:
Source → Extract → Transform → Load → Destination
Staging area có thể xuất hiện giữa các bước để giữ dữ liệu tạm thời. AWS mô tả ETL là một dạng data pipeline đặc biệt trong đó dữ liệu được trích xuất, biến đổi rồi mới tải vào data lake hoặc data warehouse.
ELT tải trước rồi mới biến đổi
ELT đổi thứ tự thành Extract, Load, Transform. Dữ liệu được lấy từ source và đưa vào hệ thống đích trước; các phép transform diễn ra sau khi dữ liệu đã được load.
Luồng khi đó là:
Source → Extract → Load → Transform
Khác biệt giữa ETL và ELT vì vậy nằm chủ yếu ở vị trí của bước transform so với load. Với ETL, dữ liệu được biến đổi trước khi đến kho đích; với ELT, dữ liệu được tải trước và xử lý trong môi trường đích sau đó.
Transform cũng không phải thành phần bắt buộc. Nếu mục tiêu chỉ là sao chép hoặc đồng bộ dữ liệu, pipeline có thể đi từ source tới sink mà không có bước biến đổi riêng.
Dữ liệu đến sink và được lưu trữ ra sao?
Sink là nơi một pipeline hoặc một stage ghi dữ liệu đầu ra. Đích có thể là data warehouse, data lake, cơ sở dữ liệu, hệ thống tìm kiếm hoặc một ứng dụng khác cần nhận dữ liệu.
Trong mô hình của Google Cloud, pipeline đọc từ source và ghi tới sink; ngoài hai đầu này, pipeline còn có thể tương tác với hệ thống bên ngoài để lọc, làm giàu hoặc thực hiện logic bổ sung.
Cần phân biệt sink với vùng lưu trữ trung gian. Queue hoặc staging area giữ dữ liệu giữa các stage để phục vụ luồng xử lý. Sink là đích mà stage hoặc pipeline đang hướng tới. Hai vai trò này phụ thuộc vào phạm vi quan sát: một data warehouse có thể là sink của pipeline nhập dữ liệu nhưng lại trở thành source cho một pipeline phân tích khác.
Vì vậy, “đã lưu trữ” không có nghĩa dữ liệu đã kết thúc toàn bộ vòng đời. Nó chỉ có thể là điểm kết thúc của pipeline đang xét. Từ đó, dữ liệu có thể tiếp tục trở thành đầu vào của một luồng khác.
Batch và streaming làm thay đổi cách dữ liệu di chuyển
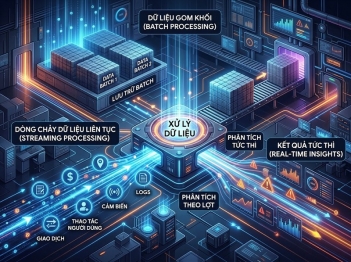
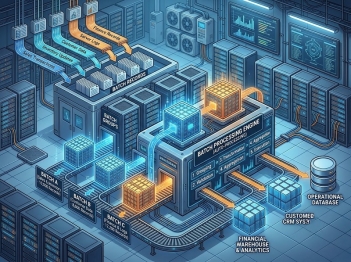
Batch pipeline xử lý dữ liệu theo từng lô. Pipeline thường được kích hoạt theo một lịch hoặc chu kỳ xác định, sau đó xử lý tập dữ liệu thuộc lần chạy đó. Streaming pipeline duy trì luồng xử lý liên tục để nhận và xử lý dữ liệu khi dữ liệu trở nên sẵn sàng. Google Cloud hỗ trợ cả hai mô hình và mô tả batch pipeline theo lịch, còn streaming pipeline chạy liên tục sau khi được khởi tạo.
Khác biệt quan trọng nằm ở thời điểm một bản ghi được xử lý. Với batch, bản ghi có thể phải chờ lần chạy tiếp theo trước khi được xử lý hoặc chuyển sang stage kế tiếp. Với streaming, dữ liệu có thể được đưa vào xử lý ngay khi xuất hiện trong luồng.
Streaming không đồng nghĩa với độ trễ bằng không. Source, queue, tốc độ xử lý, sink và các hệ thống bên ngoài đều có thể giới hạn tốc độ chung. Google Cloud cũng lưu ý rằng khả năng mở rộng của source, sink hoặc dịch vụ ngoài có thể tạo giới hạn trên cho hiệu năng của pipeline.
Do đó, không có một con số chung để khẳng định mọi data pipeline “nhanh” hay “chậm”. Các hệ thống thường đánh giá bằng những chỉ số phù hợp với yêu cầu riêng như latency, throughput, backlog hoặc data freshness thay vì dùng một ngưỡng cố định cho mọi pipeline.
Điều phối và xử lý lỗi giữ cho luồng dữ liệu tiếp tục
Các stage trong pipeline thường có dependency. Một task có thể chỉ được chạy khi task phía trước hoàn thành, khi dữ liệu nguồn đã sẵn sàng hoặc khi một điều kiện khác được đáp ứng. Orchestration quản lý những quan hệ này bằng cách lập lịch, kích hoạt và theo dõi các task.
Apache Airflow minh họa rõ cách hoạt động đó: workflow được biểu diễn bằng DAG gồm các task và dependency; dependency xác định thứ tự chạy, còn scheduler theo dõi các task và kích hoạt chúng khi điều kiện phụ thuộc đã được thỏa mãn.
Điều này cũng cho thấy orchestration và data movement không phải một việc. Orchestrator quyết định task nào chạy và khi nào chạy; dữ liệu thực tế có thể được đọc hoặc ghi bởi database connector, processing engine, message queue, storage service hoặc chính code của task.
Khi một task thất bại, pipeline còn phải xác định cách phản ứng: thử lại, dừng luồng, phát cảnh báo hoặc tách dữ liệu lỗi để xử lý riêng. Cơ chế cụ thể phụ thuộc vào yêu cầu nhất quán và mức độ chấp nhận lỗi của hệ thống. Các nền tảng orchestration như Airflow cung cấp dependency và retry policy để kiểm soát những tình huống này.
Muốn lần theo một bản ghi đang di chuyển qua data pipeline, có thể kiểm tra sáu điểm: source của nó, cách ingestion diễn ra, có buffer trung gian hay không, transform xảy ra trước hay sau load, sink nào nhận kết quả và điều kiện nào quyết định stage tiếp theo được chạy. Cách lần theo này tách rõ đường đi của dữ liệu khỏi lớp điều phối workflow.
Dữ liệu di chuyển qua data pipeline bằng một chuỗi stage liên kết: source cung cấp dữ liệu, ingestion đưa dữ liệu vào luồng, các bước trung gian truyền hoặc giữ tạm dữ liệu, processing thực hiện transform khi cần và sink nhận kết quả. Batch và streaming quyết định nhịp xử lý, còn ETL và ELT quyết định transform nằm trước hay sau bước load.
Không có một sơ đồ duy nhất áp dụng cho mọi hệ thống. Pipeline có thể rất ngắn hoặc gồm nhiều stage, có hoặc không có staging, biến đổi trước hoặc sau khi tải. Muốn hiểu chính xác một data pipeline, cần xác định thứ tự các stage, dependency giữa chúng và điều kiện để dữ liệu chuyển từ bước này sang bước tiếp theo.

GỬI Ý KIẾN BÌNH LUẬN

