
Dữ liệu trùng lặp ảnh hưởng chất lượng thông tin thế nào?
Mục lục
- Dữ liệu trùng lặp là gì và hình thành như thế nào?
- Vì sao dữ liệu trùng lặp làm giảm chất lượng thông tin?
- Dữ liệu trùng lặp ảnh hưởng đến thống kê và phân tích ra sao?
- Dữ liệu trùng lặp gây vấn đề gì trong vận hành?
- Làm thế nào để nhận diện và kiểm soát dữ liệu trùng lặp?
- Khi nào dữ liệu trùng lặp đặc biệt nghiêm trọng?
Dữ liệu trùng lặp làm sai lệch thống kê, giảm độ tin cậy của phân tích và gây lãng phí trong vận hành. Bài viết giải thích cơ chế phát sinh, tác động và cách kiểm soát để duy trì chất lượng thông tin
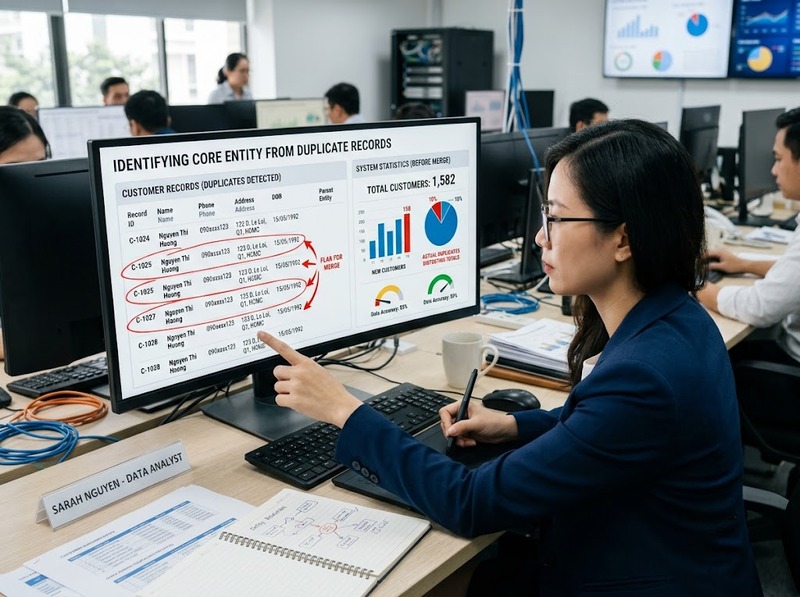
Dữ liệu trùng lặp là tình trạng cùng một thực thể, sự kiện hoặc bản ghi được lưu nhiều lần trong một tập dữ liệu, dù có thể giống hệt hoặc khác nhau về cách biểu diễn. Ví dụ, một khách hàng có thể xuất hiện hai bản ghi do nhập thông tin nhiều lần, hoặc cùng một giao dịch được ghi nhận lại bởi hai hệ thống.
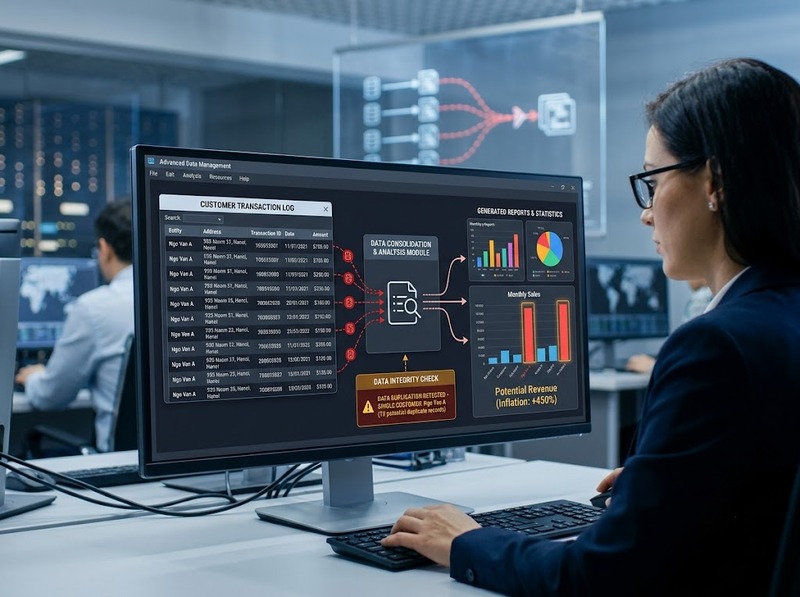
Vấn đề không nằm đơn thuần ở số lượng bản ghi dư thừa. Khi dữ liệu trùng lặp được đưa vào thống kê, phân tích hoặc quy trình vận hành mà không được nhận diện, một thực thể có thể bị tính như nhiều thực thể. Vì vậy, dữ liệu đầu vào không còn phản ánh đúng hiện trạng và chất lượng thông tin đầu ra cũng suy giảm.
Dữ liệu trùng lặp là gì và hình thành như thế nào?
Về bản chất, dữ liệu trùng lặp xuất hiện khi nhiều bản ghi cùng mô tả một đối tượng hoặc sự kiện nhưng hệ thống xử lý chúng như những bản ghi độc lập. Mức độ trùng lặp có thể rất rõ, chẳng hạn hai dòng dữ liệu giống hoàn toàn, hoặc khó phát hiện hơn khi một số trường có cách viết khác nhau.
Các dạng thường gặp gồm:
· Trùng hoàn toàn: Nhiều bản ghi có cùng các giá trị nhận diện
· Trùng do nhập liệu: Một đối tượng được tạo thành nhiều bản ghi vì dữ liệu được nhập nhiều lần
· Trùng do khác định dạng: Cùng một thông tin nhưng khác cách viết, viết tắt hoặc định dạng
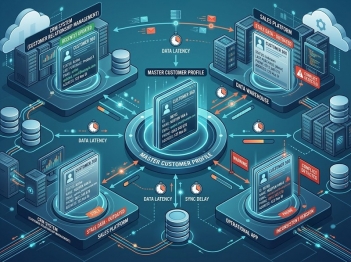
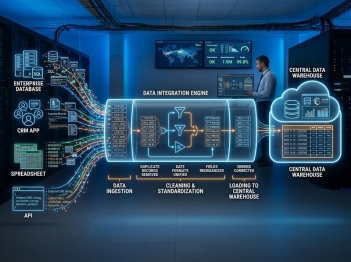
· Trùng do hợp nhất nguồn: Hai hệ thống cùng cung cấp dữ liệu về một đối tượng nhưng không có cơ chế đối chiếu
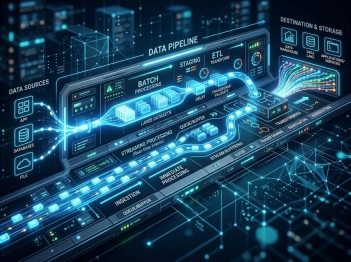
· Trùng theo thời điểm: Cùng một sự kiện được ghi nhận nhiều lần trong quá trình đồng bộ hoặc truyền dữ liệu
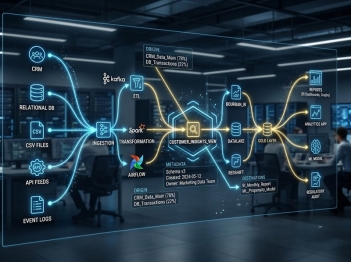
Nguyên nhân thường nằm ở quy trình thu thập, tích hợp và quản trị dữ liệu. Nếu không có khóa định danh phù hợp, quy tắc kiểm tra trước khi ghi, hoặc cơ chế đối soát giữa các nguồn, bản ghi trùng có thể tích lũy theo thời gian.
Điểm quan trọng là không phải mọi bản ghi giống nhau đều là dữ liệu trùng lặp. Hai giao dịch có cùng khách hàng và cùng số tiền vẫn có thể là hai sự kiện khác nhau. Vì vậy, xác định trùng lặp phải dựa trên thực thể hoặc sự kiện được mô tả, không chỉ dựa vào việc so sánh một vài trường dữ liệu.
Vì sao dữ liệu trùng lặp làm giảm chất lượng thông tin?
Cơ chế ảnh hưởng chính là một đối tượng bị đếm nhiều lần nhưng hệ thống tưởng rằng đó là nhiều đối tượng. Khi bản ghi trùng đi qua các bước tổng hợp, tính toán hoặc phân tích, sai lệch ban đầu có thể lan sang kết quả cuối cùng.
Có thể hình dung chuỗi tác động như sau:
Dữ liệu trùng lặp → số lượng bản ghi bị phóng đại → thống kê sai lệch → phân tích sai → quyết định dựa trên thông tin kém tin cậy
Mức độ ảnh hưởng phụ thuộc vào vị trí của dữ liệu trùng trong quy trình. Nếu chỉ tồn tại trong một bảng phụ và được loại bỏ trước khi phân tích, tác động có thể nhỏ. Ngược lại, nếu bản ghi trùng được sử dụng làm nguồn cho nhiều báo cáo và hệ thống nghiệp vụ, một lỗi dữ liệu có thể tạo ra nhiều kết quả sai khác nhau.
Dữ liệu trùng lặp cũng làm giảm khả năng truy nguyên. Khi có nhiều bản ghi cùng mô tả một thực thể, người dùng khó xác định đâu là bản ghi chính xác, bản ghi nào mới nhất và bản ghi nào cần được giữ lại.
Dữ liệu trùng lặp ảnh hưởng đến thống kê và phân tích ra sao?
Ảnh hưởng rõ nhất xuất hiện khi dữ liệu được dùng để đếm, tổng hợp hoặc tính các chỉ số. Một bản ghi bị lặp có thể làm thay đổi cả tử số lẫn mẫu số của phép tính, tùy cách chỉ số được xây dựng.
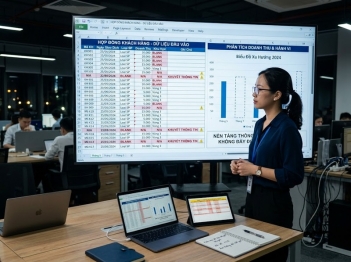
Ví dụ, nếu một khách hàng xuất hiện ba lần trong dữ liệu và hệ thống tính số khách hàng dựa trực tiếp trên số dòng, một khách hàng thực tế có thể bị tính thành ba khách hàng. Khi đó, các chỉ số về quy mô khách hàng, tỷ lệ khách hàng theo nhóm hoặc mức độ đóng góp của từng nhóm đều có nguy cơ sai lệch.
Dữ liệu trùng lặp có thể ảnh hưởng đến:
· Tổng số đối tượng hoặc giao dịch
· Tổng doanh thu hoặc giá trị giao dịch
· Tần suất xuất hiện của một sự kiện
· Tỷ lệ và phần trăm
· Giá trị trung bình
· Phân bố dữ liệu
· Kết quả phân nhóm và phân loại
· Mô hình hoặc báo cáo được xây dựng từ dữ liệu đầu vào
Không phải mọi chỉ số đều bị ảnh hưởng giống nhau. Các phép tính dựa trên tổng số bản ghi thường nhạy cảm với bản ghi trùng hơn những phép tính sử dụng định danh duy nhất. Vì vậy, trước khi diễn giải một kết quả thống kê, cần biết dữ liệu đã được kiểm tra tính duy nhất ở cấp độ nào.
Một sai lệch nhỏ ở dữ liệu nguồn cũng không nên mặc nhiên được xem là không đáng kể. Nếu cùng một tập dữ liệu được dùng cho nhiều báo cáo, sai lệch có thể lặp lại trong nhiều quyết định và làm giảm độ tin cậy tổng thể của hệ thống thông tin.
Dữ liệu trùng lặp gây vấn đề gì trong vận hành?
Trong vận hành, dữ liệu trùng lặp không chỉ làm sai báo cáo mà còn có thể khiến một quy trình được thực hiện nhiều lần cho cùng một đối tượng.
Ví dụ, nếu một khách hàng có hai hồ sơ, hệ thống có thể gửi thông báo hai lần, tạo hai yêu cầu xử lý hoặc phân bổ nguồn lực không chính xác. Với dữ liệu sản phẩm, một mã hàng bị tạo thành nhiều bản ghi có thể khiến tồn kho, đơn hàng hoặc quy trình cập nhật trạng thái khó đồng bộ.
Tác động thường thể hiện ở ba nhóm:
Chi phí vận hành: Nhân viên phải kiểm tra, đối chiếu và xử lý các bản ghi dư thừa
Tính nhất quán: Các hệ thống khác nhau có thể sử dụng những bản ghi khác nhau cho cùng một thực thể
Khả năng ra quyết định: Báo cáo vận hành có thể phản ánh số lượng hoặc trạng thái khác với thực tế
Dữ liệu trùng lặp càng đi sâu vào chuỗi xử lý, chi phí sửa chữa càng có thể tăng vì phải xác định bản ghi nào là chính xác trước khi cập nhật các hệ thống liên quan.
Làm thế nào để nhận diện và kiểm soát dữ liệu trùng lặp?
Kiểm soát dữ liệu trùng lặp nên được thực hiện trước khi dữ liệu trở thành đầu vào cho thống kê, phân tích hoặc quy trình nghiệp vụ quan trọng.
Trước hết, cần xác định định danh của thực thể hoặc sự kiện. Một khách hàng có thể được nhận diện bằng mã khách hàng, còn một giao dịch có thể cần mã giao dịch hoặc tổ hợp các thuộc tính đủ để phân biệt từng sự kiện.
Sau đó có thể áp dụng các lớp kiểm soát:
1. Chuẩn hóa dữ liệu: Đồng nhất cách viết tên, định dạng ngày tháng, số điện thoại, mã hoặc các trường nhận diện
2. Kiểm tra tính duy nhất: Phát hiện các khóa hoặc tổ hợp trường đáng lẽ phải duy nhất nhưng lại xuất hiện nhiều lần
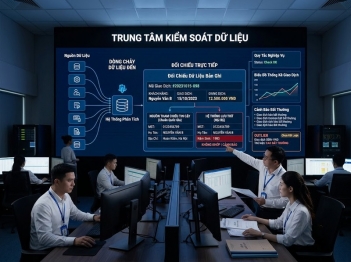
3. Đối chiếu giữa nguồn: Xác định những bản ghi từ nhiều hệ thống đang mô tả cùng một thực thể
4. Xác định quy tắc bản ghi chính: Khi phát hiện trùng, cần có tiêu chí rõ ràng để giữ, hợp nhất hoặc loại bỏ bản ghi
5. Kiểm tra trước khi phân tích: Xác nhận trạng thái trùng lặp trước khi tính toán các chỉ số quan trọng
6. Theo dõi liên tục: Không chỉ làm sạch dữ liệu một lần mà cần phát hiện trùng lặp ngay trong quá trình dữ liệu được tạo và cập nhật
Một nguyên tắc quan trọng là không xóa dữ liệu trùng chỉ vì các bản ghi giống nhau. Nếu chưa xác định chúng đại diện cho cùng một thực thể hoặc sự kiện, việc xóa nhầm có thể làm mất dữ liệu hợp lệ.
Khi nào dữ liệu trùng lặp đặc biệt nghiêm trọng?
Mức độ nghiêm trọng phụ thuộc vào ba yếu tố: dữ liệu được dùng cho mục đích gì, bản ghi trùng chiếm vị trí nào trong quy trình và hệ thống có khả năng phát hiện sai lệch hay không.
Rủi ro cao hơn khi dữ liệu trùng:
· Được dùng để tính các chỉ số quản trị quan trọng
· Là nguồn cho nhiều báo cáo hoặc hệ thống khác
· Liên quan đến giao dịch hoặc sự kiện có giá trị
· Làm thay đổi trạng thái của một thực thể
· Không có định danh duy nhất để kiểm tra
· Khó truy nguyên nguồn phát sinh
Ngược lại, một số bản ghi giống nhau có thể hoàn toàn hợp lệ nếu chúng đại diện cho những sự kiện độc lập. Đây là lý do kiểm soát dữ liệu trùng lặp phải phân biệt giữa bản ghi giống nhau và bản ghi cùng đại diện cho một thực thể hoặc sự kiện.
Vì vậy, mục tiêu của quản trị dữ liệu không phải là làm cho mọi giá trị trong tập dữ liệu đều khác nhau. Mục tiêu là bảo đảm mỗi thực thể hoặc sự kiện được biểu diễn đúng theo quy tắc nghiệp vụ và có thể được nhận diện nhất quán.
Chất lượng thông tin phụ thuộc trực tiếp vào mức độ dữ liệu phản ánh đúng đối tượng mà nó mô tả. Dữ liệu trùng lặp làm suy giảm chất lượng này khi một thực thể hoặc sự kiện bị ghi nhận nhiều lần, từ đó có thể làm sai thống kê, phân tích và các hoạt động vận hành. Kiểm soát hiệu quả cần bắt đầu từ định danh, chuẩn hóa và quy tắc ghi nhận, sau đó tiếp tục bằng kiểm tra và đối soát trong toàn bộ vòng đời dữ liệu.:::

GỬI Ý KIẾN BÌNH LUẬN

