
Data lineage theo dõi nguồn gốc dữ liệu như thế nào?
Mục lục
- Data lineage là gì và theo dõi những thành phần nào?
- Data lineage truy vết quá trình biến đổi dữ liệu như thế nào?
- Lineage ghi nhận nguồn, luồng và biến đổi dữ liệu ra sao?
- Data lineage giúp truy nguyên một thay đổi dữ liệu như thế nào?
- Data lineage có thể theo dõi đến mức cột dữ liệu không?
- Data lineage khác gì với data catalog và data flow?
- Data lineage có giới hạn gì khi truy vết dữ liệu?
Data lineage cho biết dữ liệu bắt đầu từ đâu, đi qua những hệ thống và bước xử lý nào, được biến đổi ra sao và tạo ra đầu ra nào, từ đó giúp truy vết nguồn gốc và đánh giá tác động khi dữ liệu thay đổi
Data lineage là cách mô tả và theo dõi nguồn gốc, luồng di chuyển, các bước xử lý và mối quan hệ giữa dữ liệu trong suốt vòng đời của nó. Thay vì chỉ biết một bảng dữ liệu hiện đang nằm ở đâu, lineage giúp trả lời câu hỏi: dữ liệu này đến từ đâu, được tạo bởi quy trình nào, đã qua những biến đổi nào và đang được những hệ thống nào sử dụng?
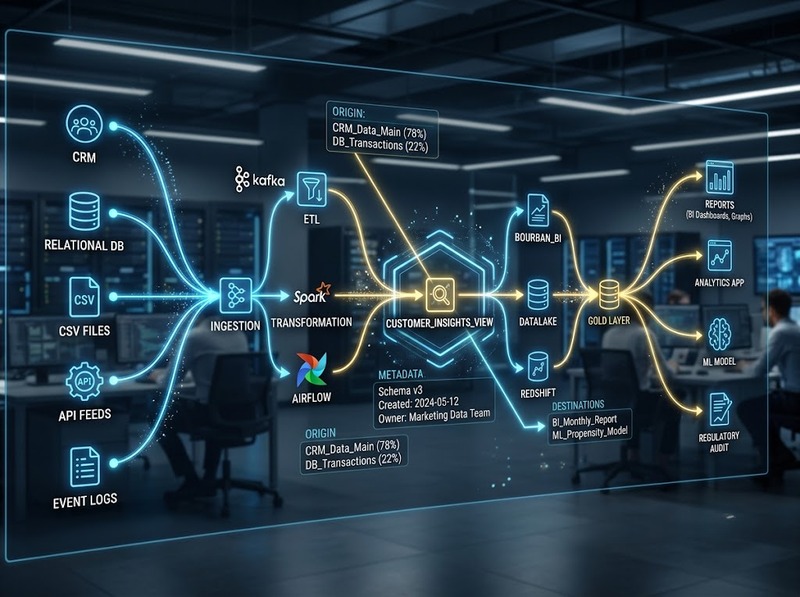
Một lineage có thể được hình dung như một đồ thị:
Nguồn dữ liệu → Job/Pipeline → Dataset trung gian → Biến đổi → Dataset đầu ra → Báo cáo/ứng dụng
Trong các hệ thống hiện đại, lineage thường được xây dựng từ metadata về dataset, job và từng lần chạy của job. OpenLineage, chẳng hạn, sử dụng ba thực thể cốt lõi này để ghi nhận quan hệ giữa dữ liệu và quá trình xử lý.
Data lineage là gì và theo dõi những thành phần nào?
Data lineage tập trung vào mối quan hệ giữa dữ liệu và quá trình tạo ra hoặc sử dụng dữ liệu, chứ không chỉ là danh sách vị trí lưu trữ.
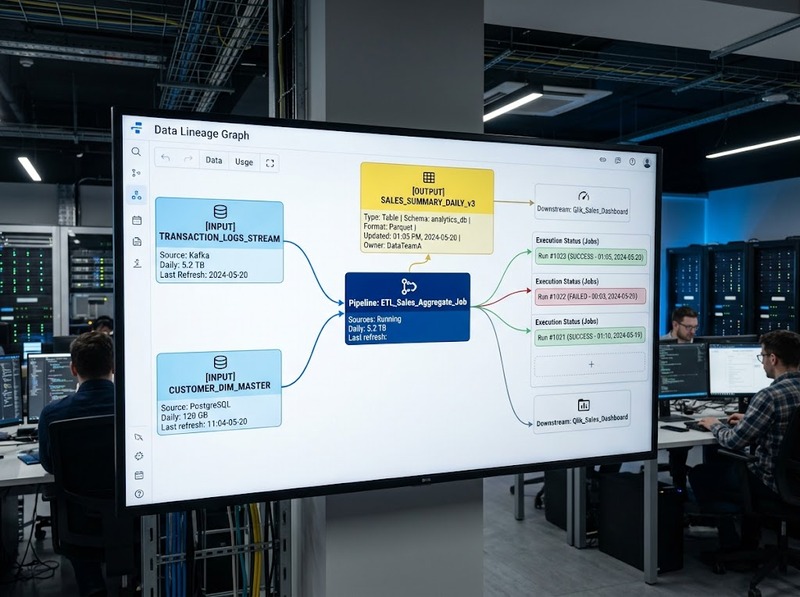
Một mô hình lineage thường cần ít nhất ba thành phần:
· Dataset: Nguồn hoặc tập dữ liệu được đọc, ghi hoặc biến đổi
· Job: Công việc xử lý dữ liệu như SQL query, ETL job, pipeline hoặc tác vụ xử lý
· Run: Một lần thực thi cụ thể của job, giúp biết một biến đổi xảy ra vào thời điểm nào và với đầu vào nào
OpenLineage mô hình hóa chính xác ba lớp này; một Job có thể tiêu thụ Dataset đầu vào và tạo Dataset đầu ra, còn Run đại diện cho một lần thực thi của Job.
Ví dụ, một pipeline bán hàng có thể đọc orders_raw, thực hiện làm sạch và tổng hợp, rồi tạo daily_sales. Lineage không chỉ lưu rằng hai bảng có liên quan mà còn ghi nhận job nào tạo ra quan hệ đó và lần chạy nào đã thực hiện nó.
Đây là điểm quan trọng: nếu chỉ lưu metadata của bảng, ta biết “cái gì tồn tại”; lineage bổ sung thông tin về “cái gì tạo ra cái gì và bằng quá trình nào”.
Data lineage truy vết quá trình biến đổi dữ liệu như thế nào?
Cơ chế truy vết dựa trên việc ghi nhận các quan hệ giữa input → processing → output trong từng bước của pipeline.
Giả sử dữ liệu đi theo chuỗi:
CRM → customer_raw → ETL → customer_clean → SQL model → customer_360 → Dashboard
Lineage sẽ nối các thành phần này thành một chuỗi quan hệ. Khi mở một dataset, người dùng có thể đi ngược để tìm upstream hoặc đi xuôi để xem downstream.
Có thể phân biệt hai hướng truy vết chính:
Upstream lineage trả lời:
Dataset này bắt nguồn từ đâu?
Ví dụ, khi phát hiện số liệu trong customer_360 bất thường, người vận hành có thể lần ngược qua các job và dataset để tìm nguồn dữ liệu hoặc bước biến đổi có vấn đề.
Downstream lineage trả lời:
Nếu dataset này thay đổi, những thành phần nào có thể bị ảnh hưởng?
Ví dụ, khi thay đổi schema của một bảng nguồn, lineage giúp xác định các bảng trung gian, báo cáo hoặc quy trình downstream đang phụ thuộc vào bảng đó.
Lineage vì vậy không chỉ là “đường đi” của dữ liệu. Nó còn là bản đồ quan hệ phụ thuộc, cho phép kết nối các quan sát từ nhiều job và nền tảng thành một lineage graph.
Lineage ghi nhận nguồn, luồng và biến đổi dữ liệu ra sao?
Để truy vết có ý nghĩa, lineage cần ghi nhận nhiều lớp metadata thay vì chỉ lưu tên dataset.
Nguồn dữ liệu
Nguồn có thể là database, bảng, file, object storage hoặc hệ thống nghiệp vụ. Metadata của dataset giúp xác định dataset cụ thể trong hệ sinh thái dữ liệu.
Luồng xử lý
Job hoặc pipeline cho biết dữ liệu được xử lý bởi thành phần nào. Một job có thể đọc một hoặc nhiều dataset đầu vào rồi tạo ra một hoặc nhiều dataset đầu ra.
Lần thực thi
Run cho biết một lần chạy cụ thể của job. Điều này quan trọng vì cùng một job có thể chạy nhiều lần với các đầu vào hoặc partition khác nhau. OpenLineage sử dụng RunEvent để ghi nhận các trạng thái trong vòng đời thực thi như bắt đầu, hoàn tất hoặc thất bại.
Metadata của biến đổi
Tùy hệ thống, lineage có thể được mở rộng bằng metadata mô tả thêm job, input, output hoặc run. OpenLineage gọi các phần metadata mở rộng này là facets.
Nhờ vậy, một lineage hữu ích có thể trả lời không chỉ “A tạo ra B”, mà còn “A được xử lý bởi job nào, trong lần chạy nào và quan hệ đó được ghi nhận bằng metadata nào”.
Data lineage giúp truy nguyên một thay đổi dữ liệu như thế nào?
Giá trị thực tế của lineage thể hiện rõ nhất khi có lỗi hoặc một thay đổi trong hệ thống.
Giả sử dashboard doanh thu xuất hiện số liệu thấp bất thường. Nếu không có lineage, việc điều tra có thể phải kiểm tra lần lượt nguồn dữ liệu, các pipeline trung gian, bảng tổng hợp và câu SQL.
Với lineage, quy trình truy nguyên có thể đi theo hướng:
Dashboard → Dataset báo cáo → Job tổng hợp → Dataset trung gian → Job ETL → Dataset nguồn
Từ đó, người vận hành có thể xác định:
1. Dataset nào trực tiếp cung cấp số liệu cho dashboard
2. Job nào tạo hoặc biến đổi dataset đó
3. Dataset upstream nào cung cấp đầu vào
4. Lần chạy nào có liên quan
5. Thay đổi xuất hiện ở đâu trong chuỗi
Lineage cũng hỗ trợ phân tích tác động. Nếu một dataset hoặc schema chuẩn bị thay đổi, việc nhìn downstream dependency giúp xác định những thành phần có khả năng bị ảnh hưởng trước khi triển khai thay đổi.
Các hệ thống catalog có hỗ trợ lineage cũng sử dụng thông tin về transformation và operation để phục vụ việc hiểu provenance, auditing và governance. AWS Glue Data Catalog là một ví dụ về hệ thống lưu metadata và lineage của các transformation, operation trên dữ liệu.
Data lineage có thể theo dõi đến mức cột dữ liệu không?
Có. Lineage có thể được xây dựng ở nhiều mức chi tiết, từ dataset-level đến column-level.
Dataset-level lineage cho biết:
orders_raw → orders_clean → sales_report
Column-level lineage đi sâu hơn:
orders_raw.customer_id → orders_clean.customer_id → sales_report.customer_id
hoặc:
orders_raw.quantity × orders_raw.unit_price → sales_report.revenue
Mức column-level đặc biệt hữu ích khi một trường dữ liệu thay đổi. Thay vì chỉ biết một bảng downstream phụ thuộc vào bảng nguồn, người dùng có thể xác định cột nào chịu ảnh hưởng và nó được tạo ra từ những trường nào.
Microsoft Purview, chẳng hạn, hỗ trợ các khái niệm asset-level lineage, dataset column lineage và process column lineage trong hệ thống catalog của mình.
Tuy nhiên, mức độ chi tiết phụ thuộc vào khả năng thu thập metadata của từng hệ thống. Không phải mọi pipeline đều tự động cung cấp column-level lineage đầy đủ.
Data lineage khác gì với data catalog và data flow?
Ba khái niệm này liên quan chặt chẽ nhưng không giống nhau.
Data catalog tập trung vào việc giúp tổ chức biết dữ liệu nào đang tồn tại và hiểu metadata của dữ liệu đó. Ví dụ, AWS Glue Data Catalog lưu thông tin như schema, kiểu dữ liệu, vị trí và các metadata liên quan đến dataset.
Data flow tập trung vào dòng di chuyển của dữ liệu trong một quy trình hoặc hệ thống.
Data lineage tập trung vào nguồn gốc và quan hệ phụ thuộc của dữ liệu qua các bước xử lý, bao gồm cả upstream, downstream và các transformation liên quan.
Có thể hình dung đơn giản:
Catalog = Dữ liệu là gì và đang ở đâu?
Data flow = Dữ liệu di chuyển qua đâu?
Lineage = Dữ liệu bắt nguồn từ đâu, được tạo ra bằng quá trình nào và những thành phần nào phụ thuộc vào nó?
Trong thực tế, catalog và lineage thường được kết hợp vì metadata của catalog cung cấp ngữ cảnh cho lineage, còn lineage bổ sung quan hệ giữa các asset.
Data lineage có giới hạn gì khi truy vết dữ liệu?
Lineage không tự động bảo đảm rằng mọi quan hệ dữ liệu đều được phát hiện hoặc mọi thông tin trong lineage đều chính xác.
Độ đầy đủ phụ thuộc vào khả năng thu thập metadata từ các nguồn, job, scheduler và framework xử lý dữ liệu. Nếu một pipeline không phát ra hoặc không được công cụ lineage thu thập metadata phù hợp, đồ thị lineage có thể thiếu một đoạn.
Ngoài ra, lineage mô tả nguồn gốc và quan hệ xử lý, nhưng không tự nó chứng minh dữ liệu đầu ra là đúng hay có chất lượng cao. Một pipeline có lineage đầy đủ vẫn có thể tạo ra dữ liệu sai nếu logic xử lý sai hoặc dữ liệu nguồn có vấn đề.
Vì vậy, lineage nên được xem là lớp truy nguyên và hiểu phụ thuộc, phối hợp với data quality, catalog, governance và monitoring thay vì thay thế các cơ chế đó.
Tóm lại, data lineage theo dõi dữ liệu bằng cách ghi nhận quan hệ giữa dataset, quá trình xử lý và các lần thực thi, từ đó tạo thành một đồ thị có thể truy ngược về nguồn hoặc đi xuôi đến các thành phần phụ thuộc. Khi được thu thập đủ metadata, lineage cho phép xác định dữ liệu bắt đầu từ đâu, đã trải qua những biến đổi nào, thay đổi nào có thể gây ảnh hưởng và cần kiểm tra ở đâu khi xảy ra sự cố.
Hỏi đáp về data lineage
Data lineage có phải chỉ là sơ đồ luồng dữ liệu không?
Không. Sơ đồ luồng chỉ mô tả đường đi của dữ liệu, còn lineage tập trung vào nguồn gốc, quan hệ phụ thuộc và quá trình tạo ra dữ liệu, thường gắn với metadata của dataset, job và từng lần chạy.
Data lineage có thể truy ngược đến nguồn dữ liệu ban đầu không?
Có, nếu các bước trung gian được thu thập lineage đầy đủ. Người dùng có thể lần upstream từ dataset hoặc báo cáo về các dataset và job đã tạo ra chúng.
Data lineage có giúp đánh giá tác động khi thay đổi schema không?
Có. Bằng cách xem các quan hệ downstream, lineage giúp xác định những dataset, quy trình hoặc đầu ra có khả năng phụ thuộc vào thành phần chuẩn bị thay đổi.

GỬI Ý KIẾN BÌNH LUẬN

