
Nén dữ liệu làm giảm dung lượng lưu trữ như thế nào?
Mục lục
- Nén dữ liệu giảm số bit cần lưu bằng một biểu diễn ngắn hơn
- Vì sao dữ liệu có thể được biểu diễn bằng ít bit hơn?
- Nén không mất dữ liệu và nén mất dữ liệu giảm dung lượng theo hai cách khác nhau
- Các thuật toán biến mẫu lặp thành biểu diễn ngắn hơn ra sao?
- Vì sao không phải tệp nào cũng nén được nhiều?
- Giảm dung lượng lưu trữ đi kèm những đánh đổi nào?
Nén dữ liệu giảm dung lượng bằng cách thay cách biểu diễn dài bằng mã ngắn hơn, khai thác tính lặp và khả năng dự đoán của dữ liệu; mức tiết kiệm thực tế phụ thuộc cấu trúc dữ liệu và phương pháp nén.
Nén dữ liệu làm tệp nhỏ đi bằng cách tạo ra một biểu diễn cần ít bit hơn biểu diễn ban đầu. Thay vì lưu mọi ký hiệu, giá trị hoặc chuỗi lặp theo cách cố định, thuật toán tìm cấu trúc có thể mã hóa gọn hơn rồi lưu mã cùng những thông tin cần thiết để giải mã.
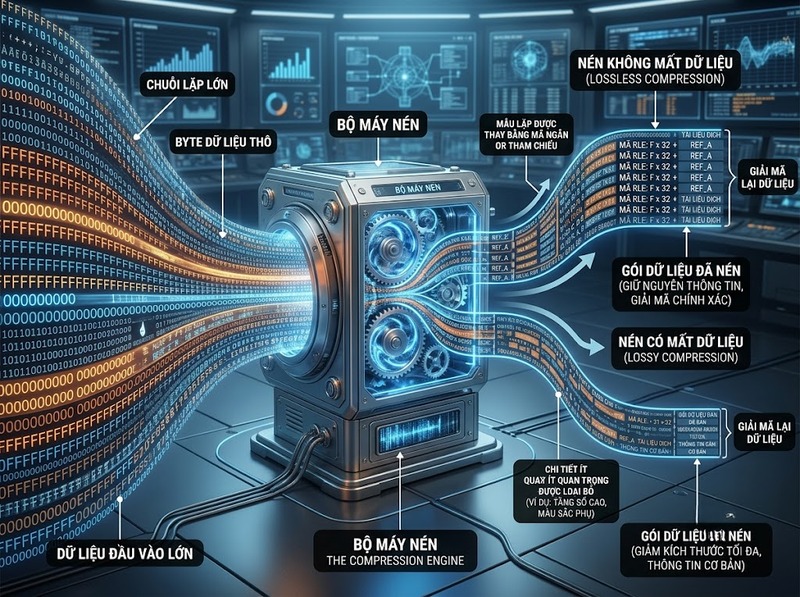
Với nén không mất dữ liệu, quá trình giải nén phải khôi phục chính xác dữ liệu gốc. Với nén mất dữ liệu, một phần thông tin được loại bỏ có chủ đích để đổi lấy kích thước nhỏ hơn. Vì vậy, “giảm dung lượng” có thể đến từ hai nguồn khác nhau: biểu diễn hiệu quả hơn hoặc thực sự giữ lại ít thông tin hơn.
Nén dữ liệu giảm số bit cần lưu bằng một biểu diễn ngắn hơn
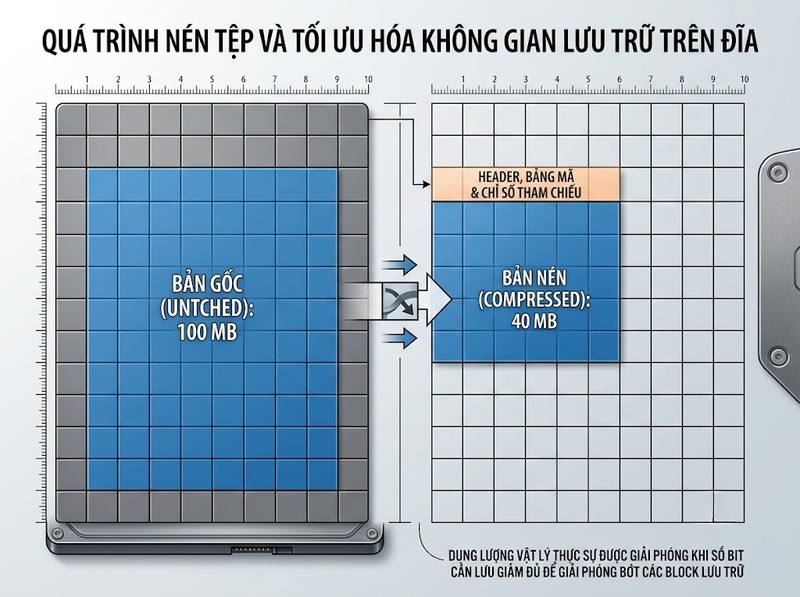
Dung lượng số về cơ bản phụ thuộc vào số bit phải lưu. Nếu dữ liệu ban đầu có kích thước (O) và bản nén có kích thước (C), phần dung lượng tiết kiệm là (O-C). Tỷ lệ tiết kiệm có thể tính bằng ((1-C/O)\times100%). Chẳng hạn, tệp 100 MB sau nén còn 40 MB thì kích thước còn lại bằng 40% ban đầu và dung lượng tiết kiệm là 60 MB, tương đương 60%.
Thuật toán đạt được kết quả đó bằng cách tạo một chuỗi bit mới ngắn hơn. Chuỗi bit mới không chỉ chứa dữ liệu đã mã hóa mà thường còn có thông tin để bộ giải nén hiểu cách khôi phục nội dung, chẳng hạn bảng mã, chỉ số tham chiếu, tham số hoặc phần đầu của định dạng. Vì vậy, lợi ích thực tế phải tính trên toàn bộ tệp nén chứ không chỉ phần dữ liệu đã biến đổi.
Ở cấp hệ thống tệp, kích thước logic nhỏ hơn cũng chưa chắc làm số byte chiếm dụng vật lý giảm đúng từng byte. Ổ lưu trữ thường cấp phát không gian theo block hoặc cluster, nên một thay đổi rất nhỏ có thể chưa làm giảm số block được cấp. Khi mức nén đủ lớn, số block cần thiết mới giảm tương ứng.
Vì sao dữ liệu có thể được biểu diễn bằng ít bit hơn?
Nhiều dữ liệu thực tế chứa tính dư thừa: một phần nội dung có thể dự đoán từ phần còn lại hoặc một số mẫu xuất hiện nhiều hơn những mẫu khác. Văn bản có tần suất ký tự và từ không đồng đều; ảnh thường có nhiều pixel lân cận giống hoặc gần giống nhau; các mẫu âm thanh liên tiếp cũng thường có quan hệ với nhau. Cách mã hóa cố định không nhất thiết tận dụng những đặc điểm đó.
Một bộ nén có thể dành mã ngắn cho trường hợp phổ biến và mã dài hơn cho trường hợp hiếm. Nó cũng có thể thay một chuỗi đã từng xuất hiện bằng tham chiếu tới chuỗi trước đó. Khi phần tiết kiệm từ các cách biểu diễn này lớn hơn chi phí lưu bảng mã, tham chiếu và metadata, tệp cuối cùng sẽ nhỏ hơn.
Trong lý thuyết thông tin, entropy mô tả mức bất định trung bình của một nguồn dữ liệu theo một mô hình xác suất. Nguồn càng dễ dự đoán thì càng có nhiều cơ hội giảm số bit trung bình cần dùng để biểu diễn. Entropy không cho biết một tệp cụ thể chắc chắn sẽ nén được bao nhiêu, nhưng nó giải thích vì sao dữ liệu có cấu trúc thường nén tốt hơn dữ liệu gần ngẫu nhiên.
Nén không mất dữ liệu và nén mất dữ liệu giảm dung lượng theo hai cách khác nhau
Nén không mất dữ liệu giữ nguyên khả năng khôi phục từng bit
Nén không mất dữ liệu chỉ thay cách biểu diễn. Bộ giải nén phải tái tạo chính xác chuỗi bit ban đầu, vì thế loại nén này phù hợp với văn bản, mã chương trình, cơ sở dữ liệu, tài liệu hoặc những dữ liệu mà một thay đổi nhỏ cũng có thể làm sai nội dung.
Khả năng giảm kích thước đến từ việc khai thác mẫu lặp, tần suất hoặc khả năng dự đoán. Không có thông tin gốc nào được phép bỏ đi. Nếu dữ liệu ban đầu gần như không còn dư thừa đối với thuật toán đang dùng, nén không mất dữ liệu có rất ít không gian để cải thiện.
Nén mất dữ liệu loại bỏ một phần thông tin theo tiêu chí chất lượng
Nén mất dữ liệu có thêm một bước khác: giảm độ chính xác hoặc loại bỏ những thành phần được coi là ít quan trọng đối với mục đích sử dụng. Ảnh, âm thanh và video thường có thể chấp nhận cách tiếp cận này vì người dùng không nhất thiết cần tái tạo từng giá trị mẫu ban đầu.
Nhiều codec không đơn giản là “xóa dữ liệu”. Chúng thường biến đổi tín hiệu sang một biểu diễn thuận lợi hơn, lượng tử hóa một số thành phần để giảm độ chính xác, sau đó tiếp tục dùng kỹ thuật mã hóa không mất dữ liệu để loại bỏ phần dư thừa còn lại. Mức nén cao hơn vì hệ thống vừa giảm lượng thông tin cần giữ vừa mã hóa phần còn lại hiệu quả hơn.
Đổi lại, dữ liệu giải mã không còn giống bit-for-bit với bản gốc. Tăng mức nén có thể làm giảm chất lượng, và việc mã hóa mất dữ liệu nhiều lần có thể tích lũy sai khác tùy định dạng và quy trình xử lý.
Các thuật toán biến mẫu lặp thành biểu diễn ngắn hơn ra sao?
Cách đơn giản nhất có thể thấy ở run-length encoding. Nếu một dữ liệu chứa 100 byte liên tiếp đều là ký tự A, cách lưu trực tiếp cần 100 byte. Trong một mô hình RLE đơn giản, nếu một byte lưu ký tự và một byte lưu số lần lặp, chuỗi đó có thể được biểu diễn bằng cặp (A, 100) chỉ chiếm 2 byte trước khi tính metadata của định dạng. RLE sẽ kém hiệu quả khi dữ liệu liên tục thay đổi và không tạo được các chuỗi lặp dài.
Các thuật toán dựa trên từ điển khai thác mẫu dài hơn. Khi một đoạn đã xuất hiện, lần xuất hiện tiếp theo có thể được lưu dưới dạng khoảng cách và độ dài thay vì ghi lại toàn bộ đoạn. DEFLATE, được mô tả trong RFC 1951, kết hợp kiểu tham chiếu dựa trên LZ77 với mã Huffman. Nhờ đó, nó vừa rút gọn các chuỗi lặp vừa giảm số bit dành cho các ký hiệu hoặc độ dài xuất hiện thường xuyên.
Mã Huffman tập trung vào xác suất xuất hiện. Những ký hiệu thường gặp được gán mã ngắn hơn, còn ký hiệu ít gặp nhận mã dài hơn. Bộ mã được thiết kế để có thể giải mã không mơ hồ. Lợi ích chỉ xuất hiện khi phân bố tần suất đủ lệch và phần tiết kiệm lớn hơn chi phí mô tả bảng mã hoặc cấu trúc tương đương.
Các phương pháp trên minh họa cùng một nguyên tắc: thuật toán không làm một bit “nhỏ hơn”. Nó thay một cấu trúc dài bằng một ký hiệu, tham chiếu hoặc mã có số bit thấp hơn rồi cung cấp đủ quy tắc để diễn giải biểu diễn mới.
Vì sao không phải tệp nào cũng nén được nhiều?
Nén không mất dữ liệu không thể làm mọi chuỗi đầu vào ngắn đi. Với mọi chuỗi dài (n) bit có (2^n) khả năng khác nhau, trong khi tổng số chuỗi có độ dài nhỏ hơn (n) chỉ là (2^n-1). Nếu mỗi đầu vào phải khôi phục duy nhất về đúng dữ liệu ban đầu, không thể gán cho toàn bộ (2^n) đầu vào những biểu diễn ngắn hơn mà vẫn giữ ánh xạ một-một.
Hệ quả thực tế là có những tệp nén rất tốt, có tệp gần như không thay đổi và thậm chí có tệp lớn hơn sau nén do phải bổ sung header hoặc metadata. Khả năng giảm dung lượng phụ thuộc vào mức dư thừa mà thuật toán có thể nhận ra chứ không chỉ phụ thuộc kích thước ban đầu.
Dữ liệu đã được nén bằng JPEG, ZIP hoặc các codec video thường còn ít mẫu dư thừa mà một lần nén tiếp theo có thể khai thác. Dữ liệu ngẫu nhiên hoặc dữ liệu mã hóa cũng có xu hướng khó nén vì phân bố của chúng gần với dạng khó dự đoán đối với các bộ nén thông thường. Ngược lại, văn bản có cấu trúc, log lặp lại hoặc dữ liệu thô có quan hệ mạnh giữa các giá trị thường tạo nhiều cơ hội hơn.
Do đó, không có một tỷ lệ giảm dung lượng chung có thể áp dụng cho mọi tệp. Cùng một thuật toán và cùng một mức thiết lập vẫn có thể tạo ra kết quả rất khác khi nội dung đầu vào thay đổi.
Giảm dung lượng lưu trữ đi kèm những đánh đổi nào?
Không gian lưu trữ tiết kiệm được phải đổi lấy công việc mã hóa và giải mã. Bộ xử lý cần thời gian để tìm mẫu, xây dựng biểu diễn nén và khôi phục dữ liệu khi đọc. Một số định dạng còn làm truy cập ngẫu nhiên phức tạp hơn vì muốn lấy một phần dữ liệu có thể phải giải mã từ một điểm tham chiếu trước đó. Mức ảnh hưởng phụ thuộc thuật toán và cách định dạng tổ chức các khối dữ liệu.
Với nén mất dữ liệu, đánh đổi quan trọng hơn là chất lượng. Dung lượng có thể giảm mạnh hơn vì hệ thống được phép bỏ bớt thông tin, nhưng ngưỡng chấp nhận phải dựa vào mục đích sử dụng. Dữ liệu cần phục hồi chính xác nên dùng nén không mất dữ liệu; dữ liệu đa phương tiện có thể dùng nén mất dữ liệu khi mức suy giảm chất lượng được kiểm soát và phù hợp nhu cầu.
Để đánh giá lợi ích lưu trữ, phép đo hữu ích nhất là nén một tập dữ liệu đại diện bằng đúng thuật toán và tham số dự kiến rồi so sánh (C/O), tỷ lệ tiết kiệm, thời gian nén và thời gian giải nén. Cách đo này phản ánh đặc tính dữ liệu thực tế tốt hơn một tỷ lệ nén chung, vì chính cấu trúc của dữ liệu quyết định phần dư thừa mà thuật toán có thể loại bỏ.
Nén dữ liệu giảm dung lượng vì cùng nội dung có thể được mã hóa bằng ít bit hơn khi trong dữ liệu tồn tại mẫu lặp, phân bố không đồng đều hoặc khả năng dự đoán. Nén không mất dữ liệu giữ đủ thông tin để khôi phục chính xác bản gốc; nén mất dữ liệu có thể giảm thêm kích thước bằng cách loại bỏ một phần chi tiết. Mức tiết kiệm cuối cùng luôn phụ thuộc vào dữ liệu, thuật toán, metadata và mức đánh đổi về chất lượng hoặc tài nguyên xử lý.

GỬI Ý KIẾN BÌNH LUẬN

