
Học có giám sát học từ dữ liệu gắn nhãn thế nào?
Mục lục
- Dữ liệu gắn nhãn là gì và vì sao nó quan trọng?
- Mô hình học quan hệ giữa đầu vào và nhãn như thế nào?
- Học có giám sát gồm những loại bài toán nào?
- Từ huấn luyện đến dự đoán dữ liệu mới diễn ra thế nào?
- Điều gì quyết định mô hình học được quan hệ đúng?
- Học có giám sát nên được hiểu như một quá trình học từ sai số
Học có giám sát dùng dữ liệu đã gắn nhãn để học quan hệ giữa đầu vào và đầu ra, thông qua dự đoán, tính lỗi và điều chỉnh mô hình
Học có giám sát là phương pháp học máy trong đó mô hình được huấn luyện từ các mẫu dữ liệu đã có đầu vào và nhãn đúng tương ứng. Thay vì chỉ quan sát dữ liệu để tìm nhóm hoặc cấu trúc, mô hình học cách liên hệ đầu vào với đầu ra mong muốn, sau đó dùng mối quan hệ đã học để dự đoán nhãn cho dữ liệu mới.
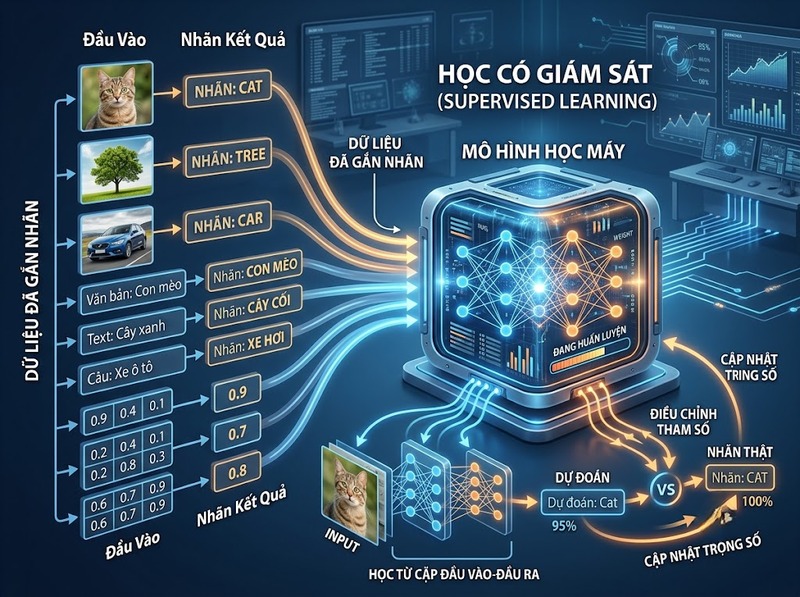
Có thể hình dung dữ liệu huấn luyện dưới dạng các cặp:
(X, y)
Trong đó X là các đặc trưng đầu vào, còn y là nhãn hoặc giá trị mục tiêu. Trong quá trình huấn luyện, mô hình tạo dự đoán từ X, so sánh dự đoán với y, đo mức sai lệch và điều chỉnh các tham số để giảm sai lệch đó. Đây là cơ chế cốt lõi giúp mô hình dần học được quan hệ giữa đầu vào và nhãn.
Dữ liệu gắn nhãn là gì và vì sao nó quan trọng?
Dữ liệu gắn nhãn là dữ liệu mà mỗi mẫu đầu vào đã đi kèm với kết quả mong muốn. Ví dụ, nếu xây dựng mô hình nhận diện email rác, phần đầu vào có thể gồm nội dung email, tiêu đề và thông tin người gửi; nhãn tương ứng có thể là spam hoặc không spam.
Một tập dữ liệu có thể được biểu diễn đơn giản như sau:
|
Đầu vào |
Nhãn |
|
Email A |
Spam |
|
Email B |
Không spam |
|
Email C |
Spam |
Các nhãn này đóng vai trò như đích học. Mô hình không được cung cấp trực tiếp quy tắc “nếu có đặc điểm A thì là spam”. Thay vào đó, nó quan sát nhiều cặp đầu vào–nhãn và tìm ra một hàm dự đoán phù hợp với dữ liệu.
Vì vậy, chất lượng nhãn ảnh hưởng trực tiếp đến quá trình học. Nếu nhiều mẫu bị gắn nhãn sai, không nhất quán hoặc nhãn chỉ là một đại diện không tốt cho mục tiêu cần dự đoán, mô hình có thể học một quan hệ sai dù thuật toán huấn luyện hoạt động đúng.
Mô hình học quan hệ giữa đầu vào và nhãn như thế nào?
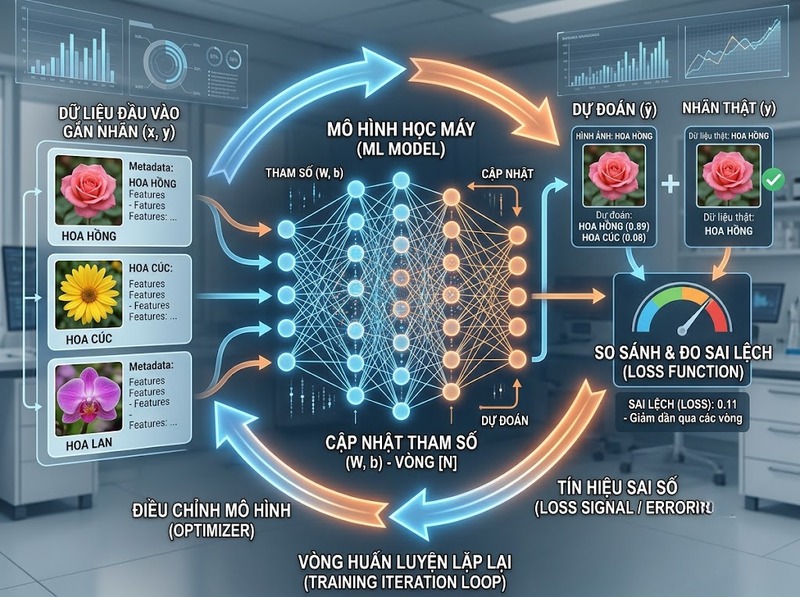
Cốt lõi của học có giám sát là tìm một hàm có thể biến đầu vào thành dự đoán gần với nhãn thực tế:
ŷ = f(X)
Trong đó ŷ là dự đoán của mô hình và y là nhãn thật.
Quá trình học thường diễn ra theo vòng lặp:
1. Mô hình nhận một nhóm mẫu đầu vào X
2. Mô hình tạo dự đoán ŷ
3. Dự đoán được so sánh với nhãn y
4. Hàm mất mát đo mức sai lệch giữa ŷ và y
5. Thuật toán tối ưu điều chỉnh tham số của mô hình
6. Quá trình được lặp lại trên nhiều mẫu dữ liệu
Hàm mất mát là thành phần quan trọng vì nó biến “dự đoán sai” thành một đại lượng có thể tối ưu. Với bài toán hồi quy, chẳng hạn, sai số bình phương trung bình có thể đo khoảng cách giữa giá trị dự đoán và giá trị thực. Mục tiêu huấn luyện là tìm tham số khiến mức mất mát giảm xuống.
Điểm quan trọng là mô hình không đơn giản ghi nhớ nhãn của từng mẫu. Mục tiêu là học một quy luật có khả năng áp dụng cho những mẫu chưa từng xuất hiện trong tập huấn luyện. Đây chính là yêu cầu về khả năng tổng quát hóa.
Học có giám sát gồm những loại bài toán nào?
Hai dạng phổ biến nhất là phân loại và hồi quy.
Phân loại
Phân loại được sử dụng khi đầu ra thuộc một hoặc nhiều lớp xác định trước.
Ví dụ:
· Email → Spam / Không spam
· Ảnh → Mèo / Chó
· Giao dịch → Gian lận / Không gian lận
Với bài toán này, mô hình học ranh giới hoặc quy luật giúp phân biệt các lớp dựa trên đặc trưng của đầu vào.
Hồi quy
Hồi quy được sử dụng khi đầu ra là một giá trị số liên tục.
Ví dụ:
· Diện tích và vị trí nhà → Giá nhà
· Tuổi và các đặc trưng liên quan → Một chỉ số sức khỏe
· Dữ liệu bán hàng → Doanh thu dự kiến
Thay vì chọn một lớp, mô hình học cách ước lượng giá trị mục tiêu.
Điểm chung của cả hai là mô hình đều nhận X cùng với y trong quá trình huấn luyện. Khác biệt nằm ở loại đầu ra và cách xác định sai số phù hợp với bài toán.
Từ huấn luyện đến dự đoán dữ liệu mới diễn ra thế nào?
Sau khi mô hình học từ dữ liệu gắn nhãn, nó được dùng trên dữ liệu chưa biết nhãn. Khi đó chỉ có đầu vào X và mô hình tạo ra dự đoán ŷ.
Ví dụ, mô hình phân loại email đã được huấn luyện bằng hàng nghìn email có nhãn. Khi nhận một email mới, mô hình không được biết trước email đó là spam hay không spam. Nó sử dụng các đặc trưng đã học để đưa ra dự đoán.
Để biết mô hình có thực sự học được hay chỉ ghi nhớ dữ liệu, dữ liệu thường được chia thành các tập riêng biệt:
· Tập huấn luyện: dùng để điều chỉnh mô hình
· Tập xác thực: dùng trong quá trình phát triển để lựa chọn và tinh chỉnh mô hình
· Tập kiểm tra: dùng để đánh giá cuối cùng trên dữ liệu mà mô hình chưa sử dụng để huấn luyện
Một cách chia thường gặp có thể là 70% cho huấn luyện, 15% cho xác thực và 15% cho kiểm tra, nhưng đây không phải tỷ lệ bắt buộc. Quy mô phù hợp phụ thuộc vào số lượng dữ liệu, độ biến thiên của bài toán và yêu cầu đánh giá.
Điều quan trọng hơn tỷ lệ là dữ liệu kiểm tra phải đủ đại diện và không bị trùng với dữ liệu huấn luyện. Nếu mô hình được kiểm tra trên những mẫu mà nó đã thấy trong quá trình học, kết quả có thể tạo ấn tượng quá tốt về khả năng dự đoán dữ liệu mới.
Điều gì quyết định mô hình học được quan hệ đúng?
Không phải cứ có nhiều dữ liệu gắn nhãn là mô hình sẽ học tốt. Có ít nhất ba yếu tố cần được kiểm soát.
Thứ nhất là chất lượng nhãn. Nếu nhãn sai hoặc không nhất quán, mô hình sẽ nhận được tín hiệu học không đáng tin cậy.
Thứ hai là chất lượng và tính đại diện của dữ liệu. Tập huấn luyện cần phản ánh đủ những trường hợp mà mô hình sẽ gặp khi hoạt động thực tế. Nếu dữ liệu huấn luyện khác xa dữ liệu thực tế, mô hình có thể đạt kết quả tốt trong thử nghiệm nhưng hoạt động kém sau khi triển khai.
Thứ ba là mức độ phức tạp của mô hình. Mô hình quá đơn giản có thể không nắm được quan hệ cần thiết, dẫn đến underfitting. Ngược lại, mô hình quá phức tạp có thể học quá sát các đặc điểm riêng của tập huấn luyện, dẫn đến overfitting. Khi đó lỗi trên dữ liệu huấn luyện có thể rất thấp nhưng khả năng dự đoán dữ liệu mới lại kém.
Một vấn đề đặc biệt cần tránh là label leakage: thông tin liên quan trực tiếp đến nhãn vô tình xuất hiện trong các đặc trưng đầu vào. Khi đó mô hình có thể đạt điểm đánh giá rất cao mà không thực sự học được quan hệ có thể sử dụng trong thực tế.
Học có giám sát nên được hiểu như một quá trình học từ sai số
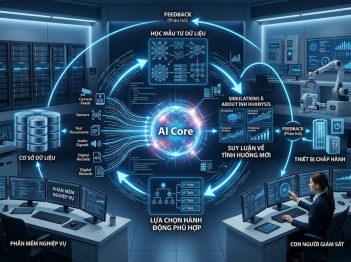
Cách dễ nhất để hiểu cơ chế của học có giám sát là xem nó như một vòng lặp dự đoán → so sánh → điều chỉnh.
Ban đầu, mô hình có các tham số chưa phù hợp. Nó nhận X và tạo ra dự đoán. Nhãn y cho biết kết quả mong muốn là gì. Hàm mất mát đo khoảng cách giữa hai kết quả này. Thuật toán tối ưu sau đó điều chỉnh tham số để những dự đoán tiếp theo phù hợp hơn với dữ liệu huấn luyện.
Sau nhiều vòng lặp, mô hình hình thành một hàm dự đoán thể hiện quan hệ mà nó tìm thấy giữa X và y.
Tuy nhiên, mục tiêu cuối cùng không phải là làm cho mô hình đúng tuyệt đối trên dữ liệu đã nhìn thấy. Mục tiêu là tổng quát hóa sang dữ liệu mới. Vì vậy, một mô hình học có giám sát chỉ thực sự có giá trị khi quan hệ nó học được vẫn tạo ra dự đoán đáng tin cậy ngoài tập dữ liệu dùng để huấn luyện.
Nói ngắn gọn, học có giám sát dùng các cặp dữ liệu đầu vào–nhãn để tạo tín hiệu học; mô hình dự đoán, đo sai lệch với nhãn thật và điều chỉnh tham số nhằm giảm sai số. Qua đó, mô hình học một quan hệ có khả năng dự đoán nhãn cho những dữ liệu mới.

GỬI Ý KIẾN BÌNH LUẬN

