
Học tăng cường học qua phần thưởng như thế nào?
Mục lục
Học tăng cường là cách một tác nhân học cách hành động bằng tương tác với môi trường và tín hiệu phần thưởng. Bài viết giải thích vòng lặp trạng thái–hành động–phần thưởng, cách hệ thống cân bằng khám phá và khai thác, cùng giới hạn của cơ chế này
Học tăng cường là một phương pháp học máy trong đó một tác nhân học cách hành động thông qua tương tác với môi trường thay vì được cung cấp sẵn đáp án đúng cho từng tình huống. Ở mỗi bước, tác nhân quan sát trạng thái, chọn một hành động, nhận phản hồi dưới dạng phần thưởng hoặc phạt rồi dùng trải nghiệm đó để điều chỉnh cách hành động trong tương lai.
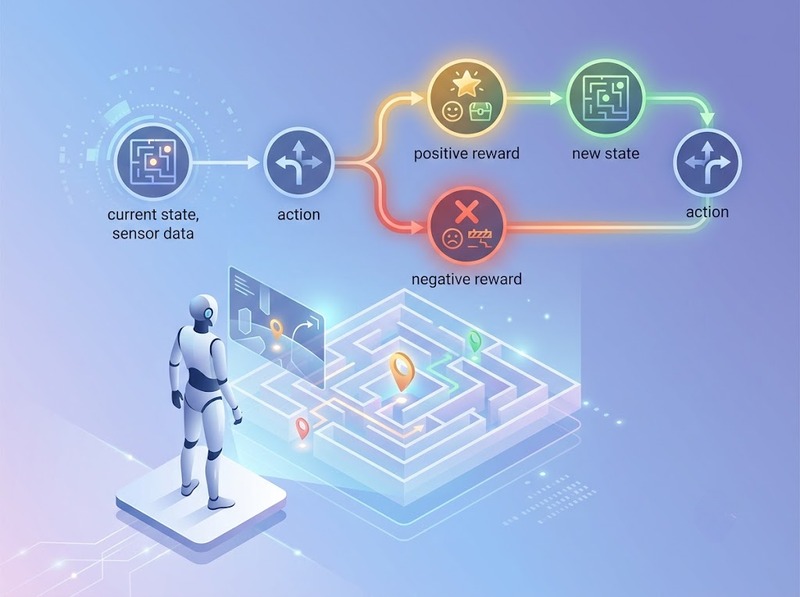
Điểm cốt lõi là hệ thống không chỉ tìm hành động đem lại phần thưởng ngay lập tức. Nó phải học cách lựa chọn chuỗi hành động có khả năng tạo ra tổng phần thưởng cao trong dài hạn. Vì vậy, quá trình học tăng cường gắn chặt với ba vấn đề: thử hành động, đánh giá hậu quả và điều chỉnh chính sách hành động.
Một hệ thống có thể được mô tả bằng vòng lặp:
Trạng thái → Hành động → Môi trường thay đổi → Phần thưởng → Trạng thái mới → Hành động tiếp theo
Qua nhiều lần tương tác, tác nhân dần hình thành một chính sách cho biết nên hành động thế nào trong những trạng thái khác nhau.
Học tăng cường là gì?
Trong học tăng cường, tác nhân không học từ một tập dữ liệu đã gắn nhãn theo kiểu “đầu vào này phải cho ra đáp án X”. Thay vào đó, nó học từ kinh nghiệm do chính quá trình tương tác tạo ra.
Một bài toán thường có các thành phần chính:
· Tác nhân: hệ thống đưa ra quyết định
· Môi trường: thế giới mà tác nhân tương tác
· Trạng thái: thông tin mô tả tình huống hiện tại
· Hành động: lựa chọn mà tác nhân có thể thực hiện
· Phần thưởng: tín hiệu phản hồi cho biết kết quả vừa đạt được có thuận lợi hay không
· Chính sách: quy tắc xác định hành động dựa trên trạng thái
Mục tiêu của tác nhân là tối đa hóa phần thưởng tích lũy theo thời gian. Vì thế, một hành động có thể không mang lại lợi ích tức thời nhưng vẫn đáng chọn nếu nó mở ra một chuỗi kết quả tốt hơn về sau.
Ví dụ, một tác nhân chơi game có thể nhận phần thưởng lớn khi hoàn thành màn chơi. Một nước đi riêng lẻ chưa chắc tạo ra điểm số ngay, nhưng nếu nước đi đó đưa tác nhân tới vị trí thuận lợi để giành chiến thắng, nó vẫn có giá trị đối với quá trình học.
Đây là điểm phân biệt quan trọng giữa phần thưởng tức thời và giá trị dài hạn. Học tăng cường hướng tới việc học cách hành động sao cho kết quả tích lũy trong tương lai được tối ưu.
Hệ thống học qua phần thưởng theo cơ chế nào?
Cơ chế cơ bản bắt đầu bằng một lần quan sát trạng thái. Tác nhân dựa trên chính sách hiện tại để chọn hành động, môi trường phản hồi bằng trạng thái mới và phần thưởng, sau đó kinh nghiệm này được sử dụng để cải thiện chính sách.
Có thể hình dung một lượt tương tác như sau:
1. Tác nhân quan sát trạng thái hiện tại
2. Tác nhân chọn một hành động
3. Môi trường phản ứng với hành động đó
4. Tác nhân nhận phần thưởng và trạng thái mới
5. Hệ thống cập nhật cách đánh giá hành động
6. Ở những lần sau, tác nhân điều chỉnh xác suất hoặc giá trị của các hành động dựa trên kinh nghiệm
Điểm quan trọng nằm ở bước cập nhật. Hệ thống không đơn giản ghi nhớ rằng “hành động A tốt” hoặc “hành động B xấu”. Nó cố gắng liên hệ hành động với những kết quả mà hành động đó có thể dẫn tới.
Trong nhiều thuật toán, một giá trị được sử dụng để ước lượng mức độ đáng lựa chọn của một trạng thái hoặc một cặp trạng thái–hành động. Nếu một hành động hiện tại dẫn tới những trạng thái có triển vọng nhận phần thưởng cao hơn, giá trị của hành động đó có xu hướng tăng. Ngược lại, nếu hành động thường dẫn đến kết quả kém, giá trị của nó sẽ giảm.
Vì vậy, phần thưởng đóng vai trò như tín hiệu định hướng, còn kinh nghiệm qua nhiều bước giúp hệ thống học được mối quan hệ giữa hành động hiện tại và kết quả tương lai.
Vì sao phải thử hành động thay vì chỉ chọn hành động tốt nhất?
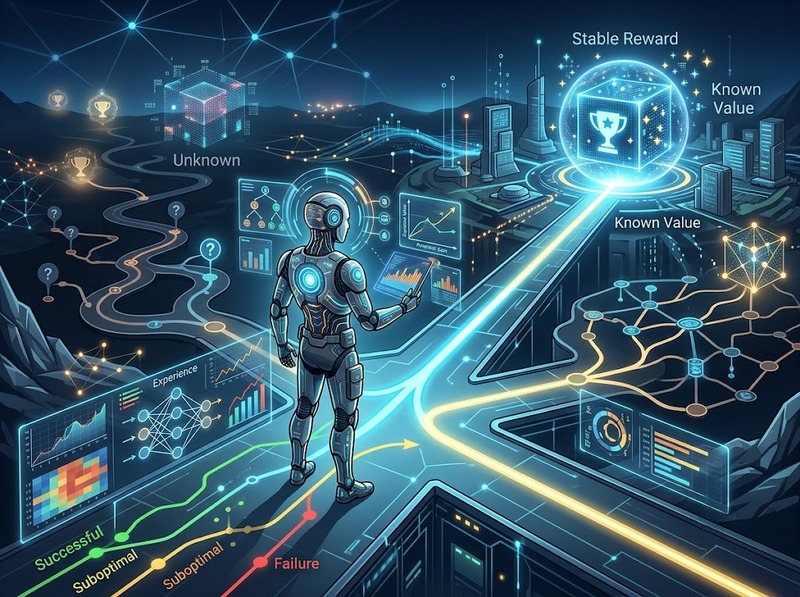
Nếu tác nhân luôn chọn hành động mà nó đang đánh giá cao nhất, nó có thể nhanh chóng khai thác một chiến lược hiện tại nhưng không bao giờ phát hiện ra chiến lược tốt hơn.
Đây là bài toán khám phá và khai thác.
Khai thác là sử dụng hành động mà hệ thống tin rằng đang đem lại kết quả tốt. Khám phá là thử những hành động chưa được đánh giá đầy đủ để tìm kiếm khả năng tốt hơn.
Hai mục tiêu này tạo ra một đánh đổi:
· Chỉ khai thác → hệ thống có thể mắc kẹt trong một chiến lược chưa tối ưu
· Chỉ khám phá → hệ thống liên tục thử nghiệm nhưng không tận dụng được những gì đã học
· Kết hợp cả hai → hệ thống vừa tận dụng kinh nghiệm hiện có, vừa có cơ hội phát hiện chiến lược mới
Ví dụ, một tác nhân chọn đường đi trong một môi trường có nhiều tuyến đường. Nó đã biết một tuyến mang lại phần thưởng khá tốt. Nếu luôn đi tuyến đó, nó có thể không bao giờ phát hiện một tuyến khác mang lại phần thưởng cao hơn. Việc thỉnh thoảng thử tuyến chưa biết chính là cơ chế khám phá.
Trong các hệ thống thực tế, mức độ khám phá có thể được điều chỉnh theo thuật toán và giai đoạn học. Khi hệ thống còn ít kinh nghiệm, khám phá có thể đóng vai trò lớn hơn; khi chính sách đã ổn định hơn, việc khai thác những lựa chọn tốt có thể trở nên quan trọng hơn.
Phần thưởng hiện tại liên quan thế nào đến kết quả dài hạn?
Một trong những điểm khó nhất của học tăng cường là phần thưởng không phải lúc nào cũng xuất hiện ngay sau hành động quyết định.
Giả sử một tác nhân chơi một trò chơi và chỉ nhận phần thưởng khi thắng. Hàng trăm hành động trước đó có thể không nhận được tín hiệu trực tiếp nào. Hệ thống vẫn phải tìm cách xác định những hành động nào đã góp phần tạo nên kết quả cuối cùng.
Đây là vấn đề tín dụng theo thời gian. Một hành động ở thời điểm hiện tại có thể ảnh hưởng đến phần thưởng xuất hiện nhiều bước sau.
Do đó, mục tiêu không đơn thuần là:
Tối đa hóa phần thưởng ở bước tiếp theo
mà là:
Tối đa hóa tổng phần thưởng kỳ vọng trong tương lai
Một cách phổ biến để biểu diễn điều này là sử dụng tổng phần thưởng có chiết khấu:
G = Rₜ₊₁ γRₜ₊₂ γ²Rₜ₊₃ ...
Trong đó:
· R là phần thưởng nhận được ở các thời điểm tiếp theo
· γ là hệ số chiết khấu, thường nằm trong khoảng từ 0 đến 1
· γ càng thấp thì hệ thống càng coi trọng phần thưởng gần hiện tại
· γ càng cao thì kết quả dài hạn càng có ảnh hưởng lớn đến quyết định hiện tại
Cơ chế này giải thích tại sao một hành động có thể được đánh giá cao dù bản thân nó không tạo ra phần thưởng ngay lập tức.
Chính sách, giá trị và quá trình cập nhật tạo thành vòng học
Chính sách là cách tác nhân chuyển trạng thái thành hành động. Ban đầu, chính sách có thể rất kém vì hệ thống chưa có nhiều kinh nghiệm. Sau mỗi lần tương tác, thông tin về phần thưởng và hậu quả được dùng để điều chỉnh chính sách hoặc các giá trị mà chính sách dựa vào.
Có hai ý tưởng thường gặp trong các thuật toán học tăng cường.
Học giá trị tập trung vào câu hỏi: “Trạng thái hoặc hành động này có đáng giá đến mức nào nếu xét các phần thưởng có thể nhận được về sau?”
Học chính sách tập trung vào câu hỏi: “Trong trạng thái này, nên chọn hành động nào?”
Một số phương pháp kết hợp cả hai. Deep Q-Network là ví dụ nổi bật: mạng nơ-ron được sử dụng để ước lượng giá trị hành động từ dữ liệu cảm nhận, cho phép tác nhân học chính sách trong những môi trường có không gian trạng thái lớn. DQN đã được chứng minh trên 49 trò chơi Atari, trong đó tác nhân học trực tiếp từ điểm ảnh và điểm số của trò chơi.
Điều này cho thấy học tăng cường có thể kết hợp với học sâu để xử lý những bài toán mà trạng thái không thể dễ dàng biểu diễn bằng một bảng giá trị nhỏ.
Học tăng cường có những giới hạn nào?
Cơ chế “thử hành động rồi nhận phần thưởng” nghe đơn giản, nhưng việc thiết kế một hệ thống học tăng cường hiệu quả không đơn giản.
Thứ nhất, phần thưởng phải phản ánh đúng mục tiêu. Nếu tín hiệu phần thưởng được thiết kế sai, tác nhân có thể tối ưu một hành vi không đúng với mục đích thực tế. Hệ thống không tự hiểu “điều con người thực sự mong muốn”; nó tối ưu mục tiêu được biểu diễn thông qua tín hiệu học.
Thứ hai, khám phá có thể tốn kém hoặc rủi ro. Trong game, thử một hành động sai thường chỉ khiến tác nhân mất điểm. Trong robot hoặc hệ thống thực, thử nghiệm sai có thể gây thiệt hại hoặc không thể đảo ngược.
Thứ ba, phần thưởng thưa và phần thưởng đến muộn làm bài toán khó hơn. Khi kết quả chỉ xuất hiện sau một chuỗi dài hành động, việc xác định hành động nào đóng góp vào kết quả đó trở nên phức tạp.
Thứ tư, môi trường thay đổi có thể làm chính sách đã học trở nên kém hiệu quả. Một chiến lược tốt trong môi trường ổn định chưa chắc vẫn tốt khi điều kiện vận hành thay đổi.
Các hệ thống nổi tiếng như DQN và AlphaGo cho thấy sức mạnh của học tăng cường khi mục tiêu, môi trường và cơ chế đánh giá được xác định rõ. AlphaGo kết hợp mạng chính sách, mạng giá trị và học tăng cường từ các ván tự chơi; cách tiếp cận này cho phép hệ thống cải thiện chiến lược thông qua kết quả của chính quá trình chơi.
Học tăng cường vì thế không phải một cơ chế đơn giản kiểu “được thưởng thì lặp lại, bị phạt thì tránh”. Bản chất của nó là học một chính sách từ tương tác, trong đó hành động được đánh giá dựa trên hậu quả trước mắt và triển vọng phần thưởng trong tương lai.
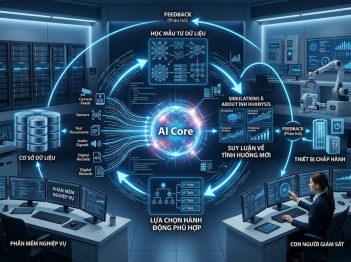
Về bản chất, học tăng cường biến quá trình ra quyết định thành một vòng lặp quan sát → hành động → nhận phần thưởng → cập nhật → thử lại. Hệ thống không cần biết trước đáp án đúng cho mọi trạng thái; nó dùng kinh nghiệm để dần học cách hành động có lợi hơn.
Cơ chế thử hành động đặc biệt quan trọng vì tác nhân phải cân bằng giữa khám phá những khả năng chưa biết và khai thác những lựa chọn đã chứng minh hiệu quả. Khi kết hợp với việc đánh giá phần thưởng dài hạn, vòng lặp này cho phép hệ thống hình thành những chiến lược ngày càng tốt hơn thay vì chỉ phản ứng với phần thưởng tức thời.
Hỏi đáp về Học tăng cường
Học tăng cường có phải là học bằng cách thử và sai không?
Có thể hiểu như vậy ở mức trực quan. Tuy nhiên, hệ thống không chỉ thử ngẫu nhiên rồi ghi nhớ kết quả. Nó sử dụng phần thưởng, trạng thái và kinh nghiệm tích lũy để cập nhật cách đánh giá hành động và chính sách lựa chọn hành động
Phần thưởng có nhất thiết phải là điểm số không?
Không. Phần thưởng là tín hiệu số hóa mục tiêu của bài toán. Nó có thể đại diện cho điểm số, lợi ích, chi phí âm, mức độ hoàn thành nhiệm vụ hoặc một tín hiệu khác tùy cách thiết kế môi trường
Học tăng cường khác học có giám sát ở điểm nào?
Học có giám sát thường học từ các ví dụ đã có nhãn hoặc đáp án mục tiêu. Học tăng cường học thông qua tương tác và phản hồi của môi trường, trong đó tác nhân phải tự tìm ra chuỗi hành động đem lại tổng phần thưởng tốt
Vì sao hệ thống không chỉ chọn hành động có phần thưởng cao nhất?
Vì phần thưởng hiện tại chưa chắc phản ánh kết quả dài hạn. Một hành động không mang lại lợi ích ngay lập tức vẫn có thể dẫn tới một chuỗi trạng thái giúp đạt phần thưởng lớn hơn về sau.

GỬI Ý KIẾN BÌNH LUẬN

