
Học máy khác lập trình theo quy tắc như thế nào?
Mục lục
- Lập trình truyền thống tạo hành vi bằng quy tắc như thế nào?
- Học máy tạo hành vi từ dữ liệu thay vì viết hết quy tắc
- Khác biệt cốt lõi nằm ở cách tạo ra logic xử lý
- Vì sao học máy có thể xử lý những bài toán khó viết quy tắc?
- Học máy không phải lúc nào cũng tốt hơn lập trình truyền thống
- Có thể kết hợp học máy với lập trình theo quy tắc không?
Học máy tạo ra hành vi từ dữ liệu và quá trình học, trong khi lập trình theo quy tắc truyền thống tạo hành vi bằng các quy tắc do con người xác định trước
Nếu lập trình truyền thống trả lời câu hỏi “Tôi phải viết quy tắc nào để máy xử lý tình huống này?”, thì học máy chuyển trọng tâm sang “Tôi có thể cung cấp dữ liệu và mục tiêu nào để máy học ra cách xử lý?”
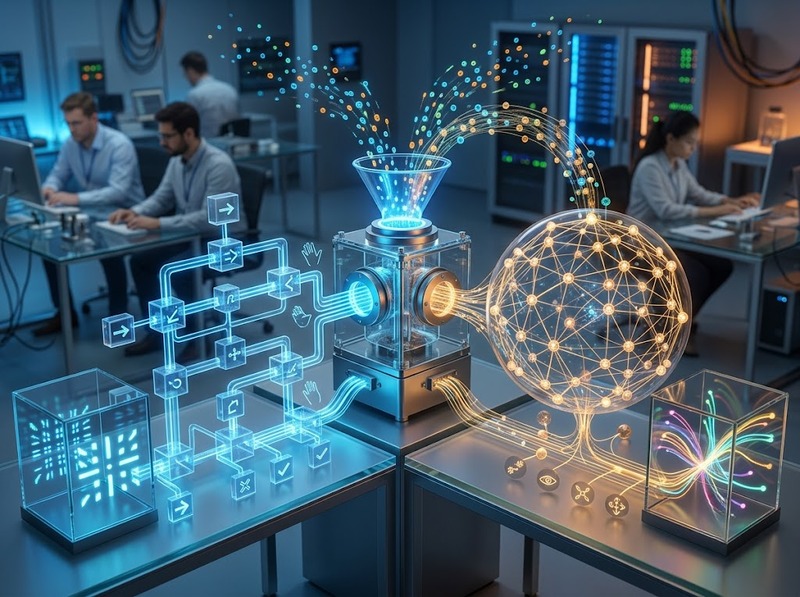
Khác biệt cốt lõi không nằm ở việc cả hai đều chạy trên máy tính, mà nằm ở cách hành vi của hệ thống được tạo ra. Lập trình theo quy tắc truyền thống đưa logic xử lý vào chương trình; học máy dùng dữ liệu để điều chỉnh các tham số của mô hình, từ đó mô hình suy ra đầu ra cho những trường hợp mới.
Lập trình truyền thống tạo hành vi bằng quy tắc như thế nào?
Trong lập trình truyền thống, con người xác định trước các bước xử lý và điều kiện mà chương trình phải tuân theo.
Có thể hình dung đơn giản:
Dữ liệu đầu vào Quy tắc do con người viết → Kết quả
Ví dụ, một chương trình kiểm tra điều kiện nhận ưu đãi có thể được mô tả bằng quy tắc:
· Nếu khách hàng là thành viên và đơn hàng từ 1 triệu đồng trở lên → áp dụng ưu đãi
· Nếu đơn hàng dưới 1 triệu đồng → không áp dụng ưu đãi
· Nếu mã giảm giá hết hạn → từ chối mã
Máy tính không cần tự tìm ra logic của các trường hợp trên. Nó chỉ thực thi những điều kiện đã được lập trình.
Điểm mạnh của cách tiếp cận này là tính minh bạch của logic. Khi chương trình cho kết quả sai, người phát triển có thể kiểm tra trực tiếp điều kiện, nhánh xử lý hoặc dữ liệu đầu vào để tìm nguyên nhân.
Nhưng cách này trở nên khó mở rộng khi quy tắc cần xử lý quá nhiều biến thể. Chẳng hạn, nếu muốn chương trình tự phân biệt thư rác, việc viết thủ công hàng nghìn quy tắc về từ khóa, người gửi, cấu trúc câu và hành vi người dùng sẽ nhanh chóng trở thành một hệ thống phức tạp.
Học máy tạo hành vi từ dữ liệu thay vì viết hết quy tắc
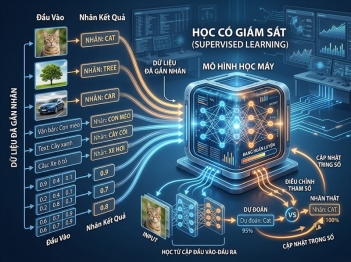
Học máy thay đổi cách xây dựng hành vi bằng cách để mô hình học mối quan hệ giữa dữ liệu đầu vào và kết quả mong muốn.
Có thể hình dung:
Dữ liệu Kết quả/định hướng học → Quá trình huấn luyện → Mô hình → Dự đoán
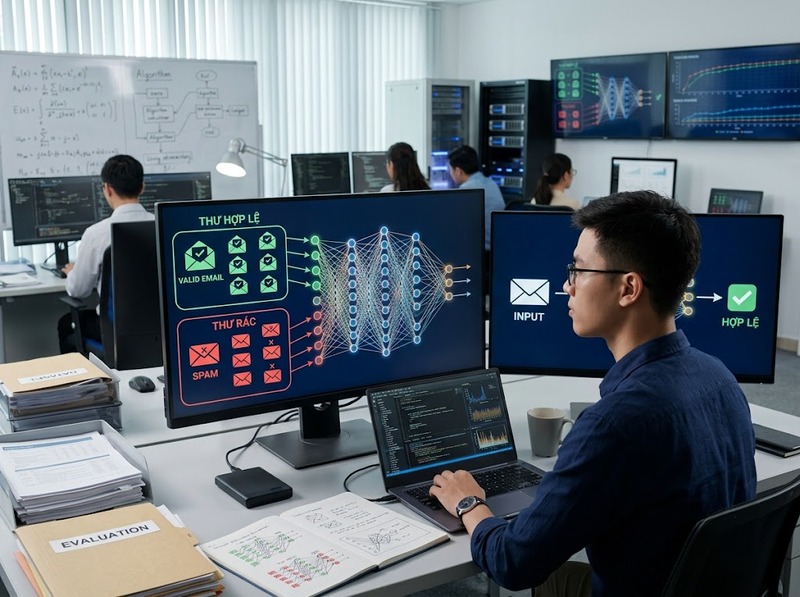
Ví dụ, thay vì viết hàng loạt quy tắc để nhận diện thư rác, người phát triển có thể cung cấp cho mô hình nhiều email đã được gắn nhãn như:
· Thư hợp lệ
· Thư rác
Trong quá trình huấn luyện, mô hình điều chỉnh các tham số của mình để giảm sai lệch giữa dự đoán và kết quả mong muốn. Sau đó, khi gặp một email mới, mô hình sử dụng những gì đã học để đưa ra dự đoán.
Điều quan trọng là người lập trình vẫn thiết kế hệ thống. Họ vẫn phải lựa chọn dữ liệu, xác định mục tiêu, xây dựng quy trình huấn luyện và đánh giá mô hình. Điểm khác là logic chi tiết dùng để tạo dự đoán không nhất thiết được viết thành một danh sách quy tắc nếu-thì rõ ràng.
Vì vậy, nói “học máy tự suy nghĩ” là cách diễn đạt dễ gây hiểu nhầm. Chính xác hơn, mô hình học các mẫu và quan hệ thống kê từ dữ liệu theo một phương pháp được thiết kế trước.
Khác biệt cốt lõi nằm ở cách tạo ra logic xử lý
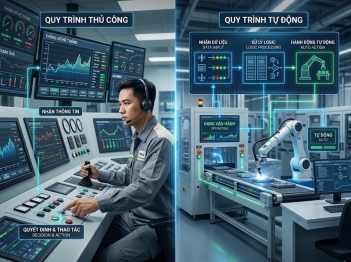
Hai phương pháp có thể cùng nhận một đầu vào và tạo ra một đầu ra, nhưng nguồn gốc của logic bên trong khác nhau.
|
Lập trình theo quy tắc |
Học máy |
|
Con người viết logic xử lý |
Con người thiết kế quá trình để mô hình học từ dữ liệu |
|
Quy tắc thường được biểu diễn trực tiếp trong chương trình |
Logic dự đoán được mã hóa trong các tham số đã học của mô hình |
|
Đầu vào quy tắc → đầu ra |
Đầu vào → mô hình đã học → dự đoán |
|
Thay đổi hành vi thường cần sửa quy tắc hoặc mã |
Có thể thay đổi hành vi bằng cách thay đổi dữ liệu, mục tiêu hoặc quá trình huấn luyện và huấn luyện lại |
|
Phù hợp với logic rõ ràng, có thể đặc tả |
Phù hợp hơn với những quan hệ khó mô tả đầy đủ bằng quy tắc thủ công |
Ví dụ, với bài toán tính thuế theo một công thức đã được quy định rõ, lập trình truyền thống thường phù hợp vì công thức có thể được biểu diễn trực tiếp.
Ngược lại, với bài toán nhận diện khuôn mặt hoặc phân loại hình ảnh, rất khó viết thủ công toàn bộ quy tắc mô tả mọi biến đổi về ánh sáng, góc nhìn, kích thước và đặc điểm hình ảnh. Học máy có lợi thế vì mô hình có thể học các mẫu từ tập dữ liệu thay vì yêu cầu con người mô tả từng trường hợp.
Do đó, khác biệt quan trọng nhất là:
Lập trình truyền thống mã hóa quy tắc; học máy mã hóa kết quả của quá trình học từ dữ liệu trong mô hình.
Vì sao học máy có thể xử lý những bài toán khó viết quy tắc?
Một quy tắc truyền thống hoạt động tốt khi con người có thể mô tả tương đối rõ mối quan hệ giữa điều kiện và hành động.
Nhưng nhiều bài toán thực tế không có một bộ quy tắc ngắn gọn như vậy. Dữ liệu có thể chứa rất nhiều biến số và mối quan hệ giữa chúng không dễ diễn đạt bằng ngôn ngữ lập trình.
Học máy giải quyết vấn đề này bằng cách tìm một hàm hoặc mô hình có khả năng ánh xạ đầu vào sang đầu ra dựa trên dữ liệu huấn luyện.
Chẳng hạn, để phân loại ảnh chó và mèo, không nhất thiết phải lập trình riêng các quy tắc như:
· Nếu tai có hình dạng này → chó
· Nếu mắt có đặc điểm kia → mèo
· Nếu lông có kiểu khác → chó
Thay vào đó, mô hình được huấn luyện trên nhiều ví dụ đã biết. Những ví dụ này cung cấp tín hiệu để mô hình điều chỉnh các tham số nhằm phân biệt các nhóm.
Tuy nhiên, cơ chế này tạo ra một điều kiện quan trọng: chất lượng hành vi phụ thuộc mạnh vào dữ liệu và cách huấn luyện. Dữ liệu thiếu đại diện, sai nhãn hoặc chứa thiên lệch có thể khiến mô hình học những mẫu không phù hợp.
Đây cũng là một khác biệt lớn so với chương trình quy tắc: lỗi của hệ thống học máy có thể không nằm ở một câu lệnh if cụ thể mà nằm trong dữ liệu, đặc trưng, mục tiêu huấn luyện, mô hình hoặc cách đánh giá.
Học máy không phải lúc nào cũng tốt hơn lập trình truyền thống
Khác biệt về cách tạo hành vi không có nghĩa học máy luôn là lựa chọn tốt hơn.
Lập trình theo quy tắc thường phù hợp khi:
· Logic nghiệp vụ rõ ràng
· Điều kiện có thể đặc tả trực tiếp
· Quy trình cần tính quyết định và khả năng kiểm tra cao
· Số lượng trường hợp cần xử lý không quá khó để mô hình hóa bằng quy tắc
Học máy phù hợp hơn khi:
· Quy tắc rất khó mô tả thủ công
· Có đủ dữ liệu để mô hình học
· Mối quan hệ giữa đầu vào và đầu ra phức tạp
· Bài toán cần nhận diện mẫu hoặc dự đoán
· Có thể đánh giá chất lượng mô hình bằng dữ liệu kiểm thử
Học máy cũng có trade-off riêng. Một mô hình có thể dự đoán tốt nhưng khó giải thích chính xác vì sao nó đưa ra một kết quả cụ thể. Ngoài ra, mô hình có thể hoạt động kém khi dữ liệu thực tế khác đáng kể so với dữ liệu mà nó đã học.
Vì vậy, câu hỏi đúng không phải là “học máy có thay thế lập trình truyền thống không?”, mà là “logic của bài toán này có phù hợp để được đặc tả trực tiếp hay phù hợp hơn với việc học từ dữ liệu?”
Có thể kết hợp học máy với lập trình theo quy tắc không?
Có. Trong hệ thống thực tế, hai cách tiếp cận thường không loại trừ nhau.
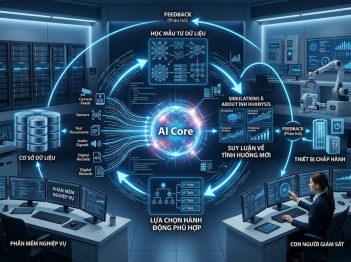
Một hệ thống có thể dùng mô hình học máy để thực hiện phần khó mô tả bằng quy tắc, sau đó dùng các quy tắc truyền thống để kiểm soát điều kiện hoặc hành động cuối cùng.
Ví dụ, một hệ thống có thể:
1. Dùng mô hình học máy để phân loại một yêu cầu
2. Kiểm tra kết quả phân loại bằng các điều kiện nghiệp vụ
3. Áp dụng quy tắc bảo vệ hoặc giới hạn vận hành
4. Trả về hành động cuối cùng
Cách kết hợp này tận dụng hai ưu điểm khác nhau: mô hình học máy xử lý các mẫu phức tạp, còn quy tắc truyền thống kiểm soát những điều kiện có thể xác định rõ.
Đây cũng là lý do không nên xem học máy và lập trình truyền thống là hai thế giới tách biệt. Học máy vẫn cần phần mềm để thu thập dữ liệu, huấn luyện, triển khai và kiểm soát mô hình; còn các hệ thống phần mềm truyền thống có thể gọi mô hình học máy như một thành phần bên trong.
Điểm phân biệt căn bản là nguồn tạo ra hành vi. Lập trình theo quy tắc truyền thống yêu cầu con người mô tả logic xử lý trước, sau đó máy thực thi logic đó. Học máy vẫn do con người thiết kế nhưng để mô hình điều chỉnh các tham số dựa trên dữ liệu, từ đó tạo ra khả năng dự đoán cho những trường hợp mới.
Vì thế, học máy đặc biệt hữu ích khi không thể hoặc không hiệu quả nếu cố viết thủ công toàn bộ quy tắc, còn lập trình truyền thống vẫn là lựa chọn tự nhiên khi logic của bài toán có thể đặc tả rõ ràng và cần kiểm soát trực tiếp.

GỬI Ý KIẾN BÌNH LUẬN

