
Mô hình học máy được tạo từ dữ liệu như thế nào?
Mục lục
Mô hình học máy học từ dữ liệu bằng cách tìm ra các mối quan hệ có ích cho nhiệm vụ dự đoán hoặc phân loại, điều chỉnh các tham số để giảm sai số rồi kiểm tra khả năng khái quát trên dữ liệu chưa từng thấy
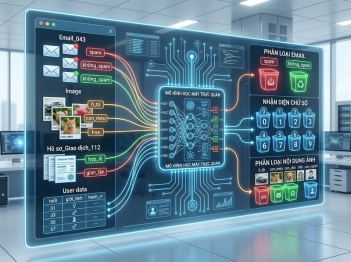
Một mô hình học máy có thể hiểu là một hệ thống toán học được điều chỉnh để tìm và sử dụng quy luật trong dữ liệu nhằm tạo ra dự đoán hoặc quyết định. Điểm quan trọng là mô hình không đơn giản “lưu lại” toàn bộ dữ liệu huấn luyện. Trong quá trình học, thuật toán tìm các tham số phù hợp với cấu trúc của dữ liệu để có thể áp dụng quy luật đã học lên những dữ liệu mới
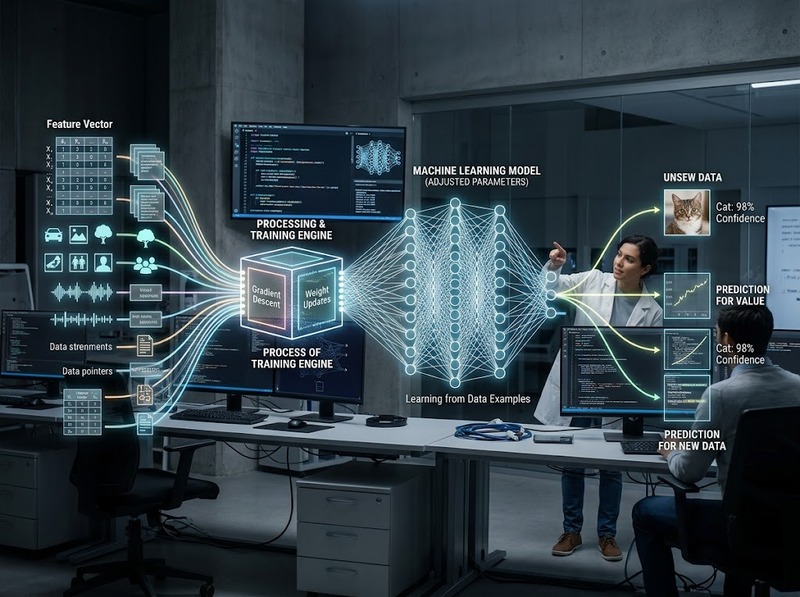
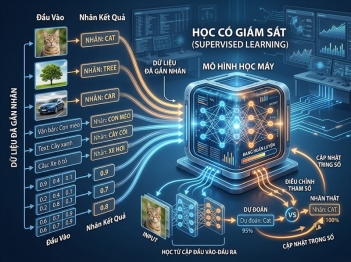
Với học có giám sát, dữ liệu thường gồm các đặc trưng đầu vào và nhãn hoặc giá trị mục tiêu. Thuật toán dùng các cặp dữ liệu này để tìm mối quan hệ giữa đầu vào và đầu ra, sau đó dùng mô hình đã huấn luyện để dự đoán trên dữ liệu mới
Dữ liệu huấn luyện cung cấp gì cho mô hình học máy?
Trước khi học, dữ liệu phải được biểu diễn theo dạng mà thuật toán có thể xử lý. Một mẫu dữ liệu có thể chứa nhiều đặc trưng, chẳng hạn diện tích nhà, số phòng và vị trí nếu nhiệm vụ là dự đoán giá nhà
Trong học có giám sát, mỗi mẫu thường có hai thành phần:
· Đặc trưng: Những thông tin được đưa vào mô hình
· Nhãn hoặc mục tiêu: Giá trị mà mô hình cần dự đoán
Ví dụ, với bài toán dự đoán giá nhà, diện tích và số phòng có thể là đặc trưng, còn giá bán là mục tiêu
Dữ liệu không chỉ quyết định mô hình có gì để học mà còn ảnh hưởng trực tiếp đến khả năng khái quát của mô hình. Dữ liệu cần được xử lý và biểu diễn phù hợp; với nhiều thuật toán, dữ liệu dạng phân loại hoặc văn bản phải được chuyển thành dạng số trước khi huấn luyện
Điều này dẫn đến một điểm dễ hiểu sai: mô hình không tự biến dữ liệu thô thành tri thức có ích chỉ nhờ có nhiều dữ liệu. Nếu dữ liệu thiếu, sai, thiên lệch hoặc không đại diện cho tình huống thực tế, quy luật mà mô hình học được cũng có thể không phù hợp
Mô hình học máy học quy luật từ dữ liệu bằng cách nào?
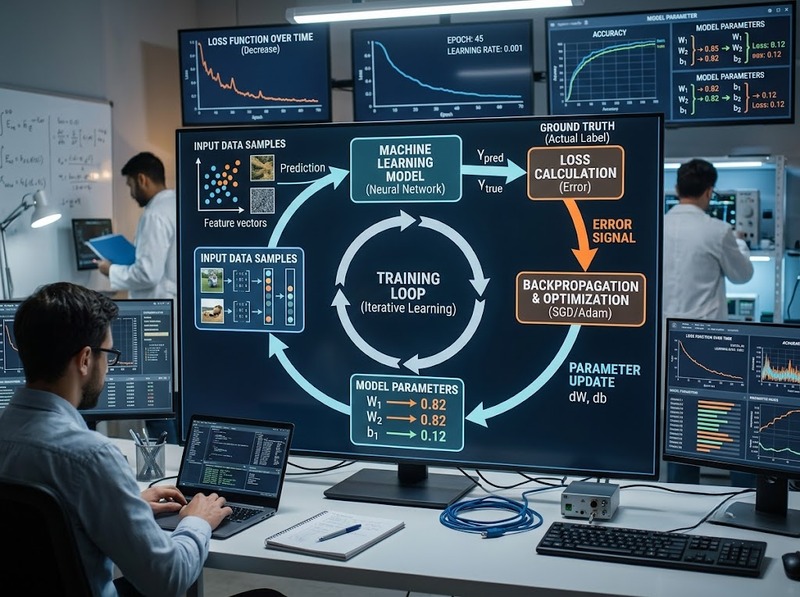
Cơ chế cốt lõi của quá trình huấn luyện là tạo dự đoán, đo mức sai lệch và điều chỉnh các tham số của mô hình
Có thể hình dung quá trình này theo chuỗi:
Dữ liệu đầu vào → Dự đoán → Tính sai số → Điều chỉnh tham số → Dự đoán lại
Các tham số là những giá trị bên trong mô hình quyết định cách mô hình biến đầu vào thành đầu ra. Khi huấn luyện, thuật toán tìm cách lựa chọn các tham số sao cho dự đoán phù hợp hơn với dữ liệu huấn luyện
Vai trò của hàm mất mát
Loss là một giá trị số biểu thị mức độ sai giữa dự đoán của mô hình và giá trị thực tế. Mục tiêu của quá trình huấn luyện thường là giảm giá trị loss
Ví dụ đơn giản, nếu mô hình dự đoán giá một căn nhà là 2,5 tỷ đồng nhưng giá thực tế là 3 tỷ đồng, sự chênh lệch này tạo ra sai số. Hàm mất mát biến sai số thành một đại lượng mà thuật toán có thể dùng để điều chỉnh mô hình
Vai trò của tối ưu hóa
Một phương pháp phổ biến là gradient descent. Thuật toán liên tục xác định hướng điều chỉnh các tham số để làm giảm loss, cập nhật chúng một lượng nhỏ rồi lặp lại quá trình này
Vì vậy, “học” trong học máy không có nghĩa là mô hình suy nghĩ như con người. Về bản chất, đó là quá trình ước lượng và điều chỉnh tham số dựa trên dữ liệu và một mục tiêu tối ưu đã xác định
Khi nào mô hình thực sự được xem là đã học?
Giảm sai số trên dữ liệu huấn luyện chưa đủ để chứng minh mô hình đã học được quy luật hữu ích
Nếu mô hình chỉ ghi nhớ những mẫu đã nhìn thấy, nó có thể đạt kết quả rất tốt trên dữ liệu huấn luyện nhưng hoạt động kém khi gặp dữ liệu mới. Hiện tượng này được gọi là overfitting
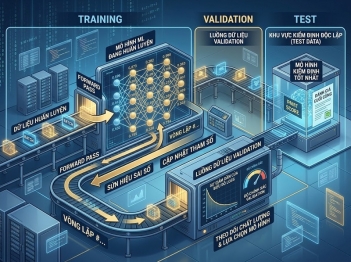
Để kiểm tra khả năng khái quát, dữ liệu thường được chia thành các phần phục vụ những mục đích khác nhau:
· Tập huấn luyện: Dùng để điều chỉnh tham số của mô hình
· Tập xác thực: Dùng để đánh giá và lựa chọn cấu hình trong quá trình phát triển
· Tập kiểm tra: Dùng để đánh giá cuối cùng trên dữ liệu chưa được sử dụng để huấn luyện
Việc đánh giá trên dữ liệu đã dùng để huấn luyện có thể tạo ra đánh giá quá lạc quan. Một mô hình có điểm số cao trên dữ liệu huấn luyện nhưng thấp trên dữ liệu mới là dấu hiệu cho thấy khả năng khái quát có vấn đề
Ngược lại, underfitting xảy ra khi mô hình quá đơn giản hoặc chưa học đủ cấu trúc cần thiết của dữ liệu. Khi đó, mô hình có thể hoạt động kém ngay cả trên dữ liệu huấn luyện
Chất lượng dữ liệu quyết định mô hình học được gì
Mô hình chỉ có thể học từ thông tin có trong dữ liệu. Vì vậy, chất lượng dữ liệu là một phần của chính quá trình xây dựng mô hình chứ không phải bước phụ sau khi đã chọn thuật toán
Một tập dữ liệu có thể gặp nhiều vấn đề:
· Thiếu dữ liệu
· Nhãn sai
· Dữ liệu nhiễu
· Đặc trưng không phù hợp
· Mẫu dữ liệu không đại diện cho thực tế
· Phân bố dữ liệu huấn luyện khác đáng kể so với dữ liệu thực tế
Nếu dữ liệu huấn luyện không phản ánh tốt môi trường mà mô hình sẽ được sử dụng, mô hình có thể học một quy luật đúng với tập dữ liệu nhưng không đúng với tình huống thực tế. Google cũng nhấn mạnh rằng chất lượng và đặc điểm của tập dữ liệu có vai trò rất lớn đối với khả năng khái quát của mô hình
Đây cũng là lý do không thể kết luận rằng nhiều dữ liệu luôn tạo ra mô hình tốt hơn. Dữ liệu phải đủ liên quan, có chất lượng và phù hợp với nhiệm vụ. Tăng số lượng dữ liệu không tự động sửa được một tập dữ liệu có nhãn sai hoặc phân bố sai
Từ dữ liệu đến mô hình hoàn chỉnh gồm những bước nào?
Ở mức khái quát, một quy trình học máy có thể được hiểu như sau:
1. Xác định nhiệm vụ: Xác định mô hình cần dự đoán hoặc phân loại điều gì
2. Thu thập dữ liệu: Tập hợp các mẫu phù hợp với nhiệm vụ
3. Chuẩn bị dữ liệu: Làm sạch, biến đổi và biểu diễn dữ liệu thành dạng phù hợp
4. Chia dữ liệu: Tạo các phần phục vụ huấn luyện và đánh giá
5. Chọn thuật toán: Chọn loại mô hình phù hợp với cấu trúc và mục tiêu của bài toán
6. Huấn luyện: Cho dữ liệu huấn luyện đi qua mô hình và điều chỉnh tham số để giảm sai số
7. Đánh giá: Kiểm tra mô hình trên dữ liệu chưa dùng để điều chỉnh tham số
8. Điều chỉnh: Thay đổi cấu hình hoặc dữ liệu nếu mô hình chưa đạt yêu cầu
9. Triển khai: Đưa mô hình đã đạt yêu cầu vào nhiệm vụ thực tế
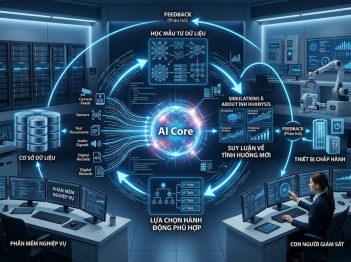
Trong thực tế, các bước này thường lặp lại thay vì diễn ra một lần duy nhất. Việc đánh giá giúp phát hiện underfitting, overfitting hoặc những vấn đề xuất phát từ dữ liệu, từ đó quay lại điều chỉnh quy trình
Điểm cốt lõi cần nhớ là: dữ liệu không được “đổ” trực tiếp vào mô hình để biến thành tri thức. Dữ liệu cung cấp các ví dụ; thuật toán sử dụng các ví dụ đó để tối ưu tham số theo một mục tiêu cụ thể; kết quả của quá trình tối ưu là mô hình có khả năng tạo đầu ra cho dữ liệu mới
Một mô hình học máy được tạo ra từ dữ liệu thông qua quá trình tìm quy luật và điều chỉnh tham số. Dữ liệu cung cấp các ví dụ, hàm mất mát đo mức sai lệch, thuật toán tối ưu điều chỉnh tham số, còn dữ liệu xác thực và kiểm tra giúp xác định liệu mô hình có thực sự khái quát được sang dữ liệu mới hay chỉ ghi nhớ dữ liệu huấn luyện
Vì vậy, khi hỏi mô hình học máy được tạo từ dữ liệu như thế nào, câu trả lời đầy đủ không chỉ là “cho dữ liệu vào để máy học”. Cần nhìn toàn bộ chuỗi: dữ liệu phù hợp → biểu diễn dữ liệu → huấn luyện → tối ưu tham số → đánh giá → kiểm tra khả năng khái quát
Hỏi đáp về mô hình học máy
Mô hình học máy có phải chỉ là dữ liệu đã được lưu lại không?
Không. Mô hình thường chứa các tham số hoặc cấu trúc được ước lượng từ dữ liệu, chứ không đơn giản là bản sao của toàn bộ tập dữ liệu huấn luyện
Dữ liệu càng nhiều thì mô hình càng tốt phải không?
Không nhất thiết. Số lượng dữ liệu có ích khi dữ liệu phù hợp và đại diện cho nhiệm vụ. Dữ liệu kém chất lượng, thiên lệch hoặc không đại diện vẫn có thể dẫn đến mô hình hoạt động kém
Làm thế nào biết mô hình đã học được quy luật thay vì ghi nhớ dữ liệu?
Cần đánh giá trên dữ liệu chưa được sử dụng để huấn luyện. Nếu mô hình hoạt động tốt trên dữ liệu mới, đó là bằng chứng quan trọng cho khả năng khái quát; nếu tốt trên tập huấn luyện nhưng kém trên dữ liệu mới, có thể đang xảy ra overfitting

GỬI Ý KIẾN BÌNH LUẬN

