
Suy luận học máy khác huấn luyện mô hình thế nào?
Mục lục
Hiểu suy luận học máy là gì, cách mô hình tạo dự đoán sau khi được huấn luyện và những khác biệt cốt lõi về mục tiêu, dữ liệu, tham số, tính toán giữa suy luận và huấn luyện
Suy luận học máy và huấn luyện mô hình là hai giai đoạn khác nhau trong vòng đời của một mô hình. Huấn luyện là quá trình mô hình học các tham số từ dữ liệu để giảm sai số, còn suy luận là quá trình dùng mô hình đã được huấn luyện để tạo dự đoán hoặc đầu ra cho dữ liệu mới.
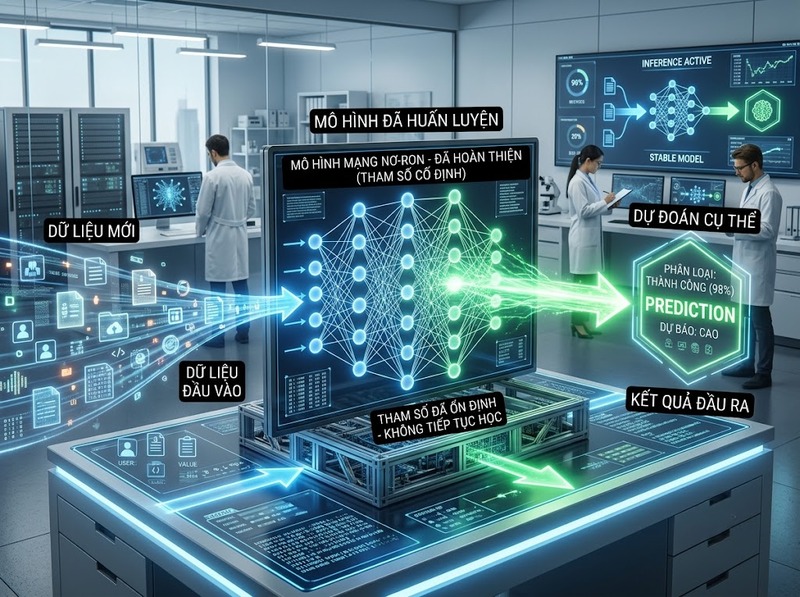
Điểm khác biệt quan trọng nhất nằm ở mục tiêu: huấn luyện nhằm thay đổi và tối ưu mô hình, trong khi suy luận nhằm sử dụng mô hình để tạo kết quả. Vì vậy, hai giai đoạn cũng có yêu cầu khác nhau về dữ liệu, phép tính, tài nguyên và hiệu năng.
Suy luận học máy là gì?
Suy luận học máy (machine learning inference) là quá trình đưa dữ liệu đầu vào qua một mô hình đã được huấn luyện để tạo ra dự đoán, xác suất, nhãn hoặc một đầu ra khác.
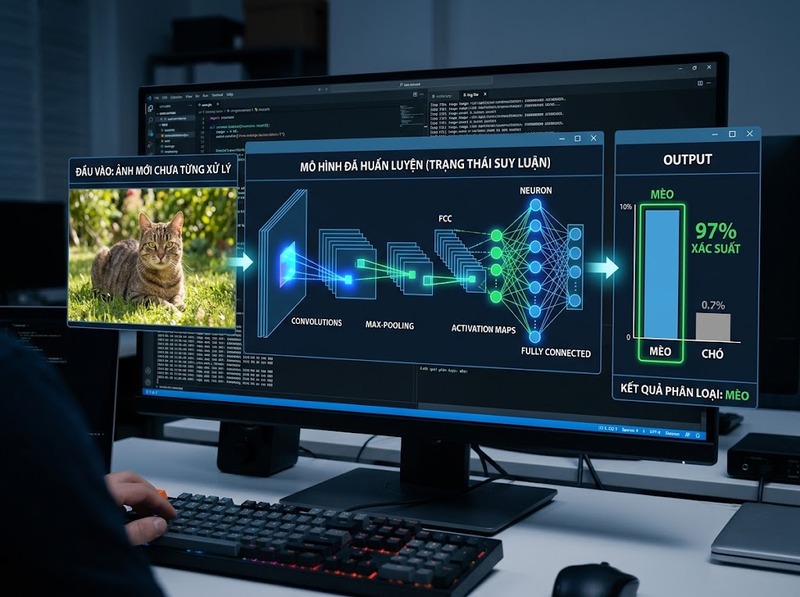
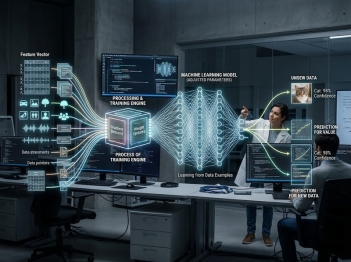
Ví dụ, một mô hình nhận diện ảnh đã được huấn luyện để phân biệt chó và mèo. Khi người dùng tải lên một ảnh mới, hệ thống đưa ảnh đó vào mô hình. Mô hình tính toán các lớp bên trong và trả về kết quả, chẳng hạn xác suất ảnh chứa chó cao hơn mèo. Quá trình tạo kết quả đó chính là suy luận.
Về cơ chế, suy luận thường có thể được hình dung như một lượt truyền tiến (forward pass):
Dữ liệu mới → mô hình → phép tính qua các lớp → đầu ra
Trong quá trình này, mô hình áp dụng các tham số đã học thay vì thực hiện quy trình tối ưu tham số như khi huấn luyện.
Điều đó cũng giải thích vì sao suy luận không đồng nghĩa với việc mô hình đang “học thêm”. Một lần dự đoán thông thường chỉ sử dụng kiến thức đã được mã hóa trong mô hình để xử lý đầu vào mới.
Huấn luyện mô hình là gì?
Huấn luyện (training) là quá trình tìm các tham số của mô hình sao cho mô hình thực hiện tốt nhiệm vụ trên dữ liệu mục tiêu.
Một quy trình huấn luyện điển hình có thể gồm:
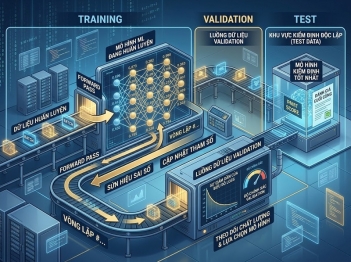
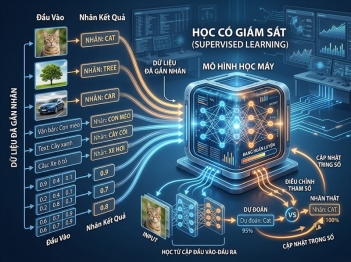
Dữ liệu → mô hình tạo dự đoán → tính sai số → cập nhật tham số → lặp lại
Ví dụ, trong bài toán phân loại ảnh có nhãn, mô hình dự đoán ảnh thuộc lớp nào rồi so sánh dự đoán với nhãn đúng. Sai số được dùng để điều chỉnh các tham số của mô hình. Với mạng nơ-ron, quá trình này thường liên quan đến lan truyền ngược và các thuật toán tối ưu như gradient descent.
Vì tham số được cập nhật qua nhiều vòng lặp, huấn luyện có tính học và tối ưu. Kết quả của quá trình này là một phiên bản mô hình có các tham số phù hợp hơn với nhiệm vụ.
Do đó, dữ liệu huấn luyện có vai trò khác dữ liệu dùng cho suy luận. Dữ liệu huấn luyện cung cấp các ví dụ để mô hình điều chỉnh tham số; dữ liệu suy luận cung cấp đầu vào để mô hình tạo kết quả.
Suy luận và huấn luyện khác nhau ở đâu?
Có thể phân biệt hai giai đoạn theo bốn tiêu chí chính:
|
Tiêu chí |
Huấn luyện |
Suy luận |
|
Mục tiêu |
Học và tối ưu mô hình |
Tạo dự đoán hoặc đầu ra |
|
Tham số mô hình |
Được cập nhật |
Thường được giữ cố định trong lần chạy |
|
Dữ liệu |
Dữ liệu dùng để học và tối ưu |
Dữ liệu mới cần dự đoán |
|
Tính toán chính |
Dự đoán, tính lỗi, cập nhật tham số và lặp lại |
Áp dụng mô hình để tạo đầu ra |
|
Hiệu năng cần chú ý |
Thời gian huấn luyện, khả năng hội tụ, độ chính xác |
Độ trễ, thông lượng, chi phí mỗi dự đoán |
|
Tần suất |
Thường chạy theo đợt |
Có thể diễn ra liên tục khi hệ thống hoạt động |
Khác nhau về mục tiêu
Huấn luyện trả lời câu hỏi:
“Làm thế nào để mô hình học được cách giải quyết nhiệm vụ?”
Suy luận trả lời:
“Với mô hình hiện tại, dữ liệu này cho kết quả gì?”
Đây là ranh giới quan trọng nhất giữa hai giai đoạn.
Khác nhau về tham số
Trong huấn luyện, tham số là đối tượng cần tối ưu. Mô hình liên tục điều chỉnh các giá trị này dựa trên sai số.
Trong một lần suy luận thông thường, các tham số đã được huấn luyện được sử dụng để tính đầu ra và không được cập nhật chỉ vì mô hình vừa xử lý một yêu cầu.
Điều này không có nghĩa mọi hệ thống học máy đều tuyệt đối không thay đổi mô hình khi đang phục vụ dữ liệu. Các kiến trúc có cơ chế học trực tuyến hoặc cập nhật mô hình có thể có thêm bước cập nhật riêng. Tuy nhiên, bản thân phép suy luận thông thường không phải là bước tối ưu tham số.
Khác nhau về dữ liệu
Huấn luyện sử dụng dữ liệu phục vụ việc học, thường được chuẩn bị thành các tập huấn luyện, xác thực và kiểm thử tùy quy trình.
Suy luận sử dụng dữ liệu mà hệ thống cần tạo dự đoán. Dữ liệu này có thể là một ảnh vừa tải lên, một yêu cầu của người dùng, một giao dịch mới hoặc một bản ghi cảm biến mới.
Một điểm cần chú ý là dữ liệu suy luận phải được xử lý phù hợp với cách dữ liệu được đưa vào lúc huấn luyện. Nếu cách tiền xử lý hoặc phân phối dữ liệu khác biệt đáng kể, hiệu quả suy luận có thể suy giảm.
Mối quan hệ giữa huấn luyện và suy luận
Hai giai đoạn không tách rời mà tạo thành chuỗi:
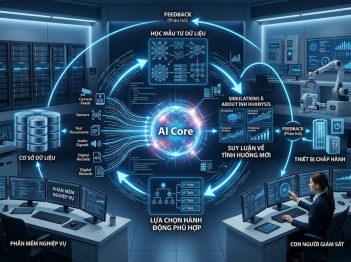
Dữ liệu huấn luyện → Huấn luyện → Mô hình đã học → Suy luận → Dự đoán
Huấn luyện tạo ra mô hình có khả năng thực hiện nhiệm vụ. Suy luận đưa khả năng đó vào sử dụng trên dữ liệu mới.
Ví dụ với mô hình dự đoán giá nhà:
1. Huấn luyện: mô hình học quan hệ giữa diện tích, vị trí, số phòng và giá từ dữ liệu lịch sử
2. Mô hình sau huấn luyện: các tham số được tối ưu để tạo dự đoán phù hợp hơn
3. Suy luận: người dùng nhập thông tin một căn nhà mới
4. Đầu ra: mô hình ước tính giá cho căn nhà đó
Nếu không có huấn luyện phù hợp, suy luận không có một mô hình đủ khả năng thực hiện nhiệm vụ. Ngược lại, nếu chỉ huấn luyện mà không đưa mô hình vào suy luận, mô hình chưa tạo ra giá trị ở bước ứng dụng.
Một cách nói ngắn gọn là: huấn luyện tạo ra năng lực của mô hình; suy luận sử dụng năng lực đó.
Suy luận có thể diễn ra theo những cách nào?
Suy luận không nhất thiết phải xảy ra từng yêu cầu một. Cách tổ chức suy luận phụ thuộc vào yêu cầu của ứng dụng.
Suy luận thời gian thực
Dữ liệu được gửi đến và hệ thống trả kết quả tương đối nhanh.
Ví dụ:
· Gợi ý sản phẩm khi người dùng đang duyệt trang
· Phát hiện giao dịch có dấu hiệu bất thường
· Nhận dạng giọng nói
· Phân loại một ảnh vừa được tải lên
Trong trường hợp này, độ trễ (latency) có ý nghĩa lớn vì người dùng hoặc hệ thống đang chờ kết quả.
Suy luận theo lô
Hệ thống thu thập nhiều dữ liệu rồi xử lý cùng lúc.
Ví dụ, doanh nghiệp có thể dùng mô hình để chấm điểm hàng triệu bản ghi vào ban đêm thay vì phải trả kết quả ngay cho từng bản ghi.
Cách này thường ưu tiên thông lượng (throughput) và hiệu quả sử dụng tài nguyên hơn phản hồi tức thời.
Suy luận tại thiết bị
Mô hình được chạy trực tiếp trên điện thoại, camera, máy tính biên hoặc thiết bị IoT thay vì gửi toàn bộ dữ liệu lên máy chủ.
Cách này có thể hữu ích khi cần giảm độ trễ, hoạt động khi kết nối mạng hạn chế hoặc muốn xử lý dữ liệu ngay tại nơi phát sinh.
Vì sao phải phân biệt suy luận với huấn luyện?
Sự khác biệt này đặc biệt quan trọng khi triển khai mô hình vào thực tế.
Huấn luyện thường quan tâm đến việc mô hình học tốt đến đâu và quá trình tối ưu cần bao nhiêu tài nguyên. Trong khi đó, suy luận thường phải giải quyết bài toán vận hành: mỗi yêu cầu mất bao lâu, hệ thống xử lý được bao nhiêu yêu cầu và chi phí cho mỗi lần dự đoán là bao nhiêu.
Một mô hình có thể đạt chất lượng dự đoán tốt nhưng vẫn khó triển khai nếu mỗi lần suy luận quá chậm hoặc cần quá nhiều tài nguyên.
Ngược lại, tối ưu suy luận để giảm độ trễ không tự động làm mô hình học tốt hơn. Đó là hai mục tiêu kỹ thuật khác nhau.
Vì vậy, khi thiết kế hệ thống học máy, cần tách ít nhất hai loại workload:
· Training workload: tối ưu và tạo mô hình
· Inference workload: sử dụng mô hình để tạo dự đoán
Việc tách này giúp lựa chọn kiến trúc, phần cứng và cách phân bổ tài nguyên phù hợp cho từng giai đoạn.
Tóm lại, suy luận học máy là bước sử dụng mô hình đã được huấn luyện để tạo dự đoán trên dữ liệu đầu vào. Huấn luyện làm thay đổi và tối ưu tham số để mô hình học nhiệm vụ; suy luận chủ yếu áp dụng các tham số đó để tạo đầu ra. Vì mục tiêu khác nhau nên dữ liệu, cách tính toán và tiêu chí hiệu năng của hai giai đoạn cũng khác nhau.
Hỏi đáp về Suy luận học máy
Suy luận học máy có phải là mô hình đang học không?
Không, trong suy luận thông thường mô hình sử dụng các tham số đã được huấn luyện để tạo đầu ra và không cập nhật tham số chỉ vì vừa xử lý một dữ liệu mới.
Dữ liệu suy luận có phải là dữ liệu huấn luyện không?
Không nhất thiết. Dữ liệu suy luận thường là dữ liệu mới mà hệ thống cần dự đoán. Quan trọng là cách tiền xử lý và đặc điểm dữ liệu suy luận phải tương thích với những gì mô hình đã được huấn luyện.
Huấn luyện hay suy luận cần nhiều tài nguyên hơn?
Thông thường huấn luyện cần lượng tính toán lớn hơn cho một lần chạy vì phải thực hiện nhiều vòng tối ưu và cập nhật tham số. Tuy nhiên, hệ thống suy luận ở quy mô lớn có thể tạo ra tải đáng kể do phải xử lý số lượng yêu cầu rất lớn.
Serving có giống inference không?
Không hoàn toàn. Inference là quá trình mô hình tạo dự đoán; serving là việc triển khai và vận hành mô hình để có thể tiếp nhận các yêu cầu suy luận trong hệ thống thực tế.

GỬI Ý KIẾN BÌNH LUẬN

