
Phân loại trong học máy giải quyết những bài toán nào?
Mục lục
Phân loại trong học máy học mối quan hệ giữa dữ liệu đầu vào và các nhãn đã biết để dự đoán nhãn cho dữ liệu mới. Cách tiếp cận này phù hợp với bài toán có đầu ra dạng lớp rời rạc như có/không, một trong nhiều nhóm hoặc nhiều nhãn cùng lúc.
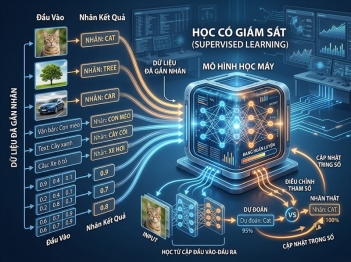
Phân loại trong học máy (classification) là một dạng học có giám sát, trong đó mô hình học từ các mẫu đã có nhãn để xác định dữ liệu mới thuộc lớp nào. Thay vì dự đoán một đại lượng liên tục như giá, nhiệt độ hay doanh thu, đầu ra của bài toán phân loại là nhãn rời rạc: chẳng hạn “spam” hoặc “không spam”, chữ số từ 0 đến 9, hay một tập nhãn mô tả nội dung của hình ảnh.
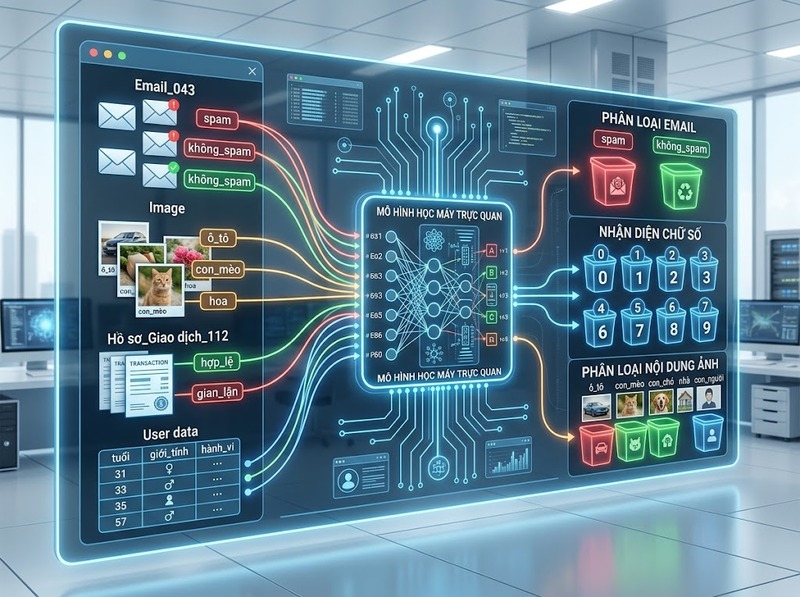
Điểm quyết định không nằm ở loại dữ liệu đầu vào. Văn bản, hình ảnh, giao dịch hay dữ liệu bảng đều có thể trở thành đầu vào của một hệ thống phân loại. Điều quan trọng là biến mục tiêu phải biểu diễn những lớp có ý nghĩa rõ ràng và dữ liệu huấn luyện phải cung cấp đủ thông tin để mô hình học cách phân biệt các lớp đó.
Mô hình phân loại dự đoán nhãn cho dữ liệu mới như thế nào?
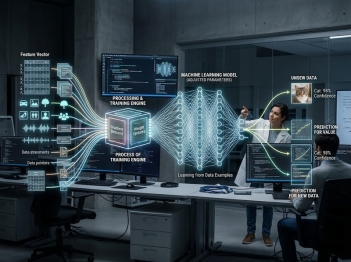
Trong dữ liệu huấn luyện, mỗi mẫu thường gồm hai phần: các đặc trưng đầu vào x và nhãn mục tiêu y. Mô hình quan sát nhiều cặp x,y để học mối quan hệ giữa đặc trưng và lớp. Khi nhận một mẫu mới chưa có nhãn, nó áp dụng mối quan hệ đã học để tạo điểm số, xác suất hoặc trực tiếp đưa ra lớp dự đoán.
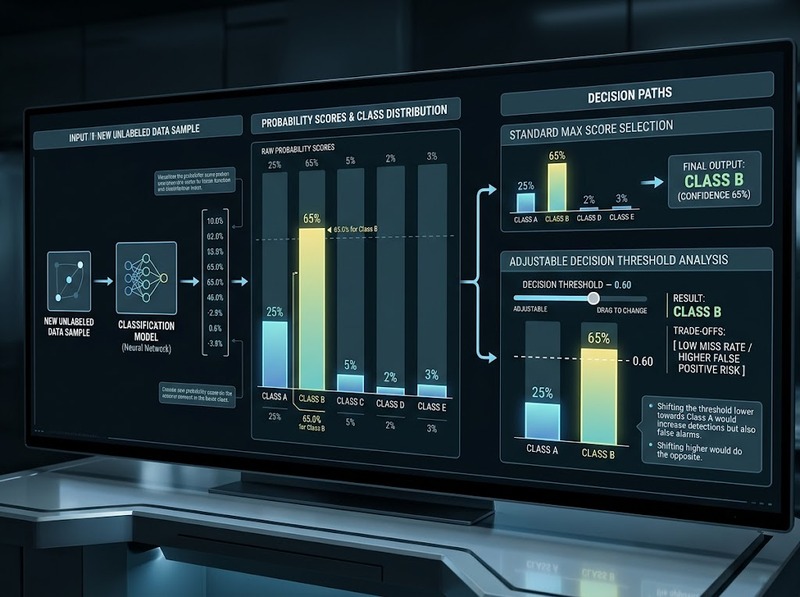
Với bài toán có nhiều lớp, mô hình có thể tạo một điểm cho từng lớp rồi chọn lớp có điểm cao nhất. Nếu đầu ra là xác suất, quyết định thường có dạng chọn lớp có xác suất dự đoán lớn nhất. Tuy nhiên, không phải mọi bộ phân loại đều xuất xác suất, và một điểm số lớn cũng không tự động có nghĩa là xác suất đã được hiệu chỉnh chính xác.
Trong bài toán hai lớp, ngưỡng quyết định còn có thể được điều chỉnh. Giả sử hệ thống xuất xác suất của lớp dương và sử dụng ngưỡng 0,5: mẫu có xác suất từ 0,5 trở lên sẽ được gán vào lớp dương. Ngưỡng 0,5 chỉ là một lựa chọn vận hành, không phải quy tắc bắt buộc. Nếu bỏ sót một trường hợp dương tính gây hậu quả lớn hơn báo động nhầm, ngưỡng có thể cần hạ xuống để ưu tiên phát hiện nhiều trường hợp hơn.
Vì vậy, “dự đoán nhãn” thực chất gồm hai lớp xử lý: mô hình ước lượng mức độ phù hợp của dữ liệu với từng lớp, sau đó một quy tắc quyết định chuyển kết quả đó thành nhãn cuối cùng.
Ba dạng bài toán phân loại phổ biến
Các bài toán classification thường được phân biệt theo số lượng lớp và số nhãn mà một mẫu có thể nhận. Cách phân chia binary, multiclass và multilabel cũng được sử dụng rộng rãi trong các thư viện học máy như scikit-learn.
|
Dạng bài toán |
Đầu ra của một mẫu |
Ví dụ |
|
Phân loại nhị phân |
Một trong 2 lớp |
Spam/không spam, rời bỏ/không rời bỏ |
|
Phân loại đa lớp |
Một trong 3 lớp trở lên |
Nhận dạng chữ số 0–9, phân loại tài liệu theo một chủ đề |
|
Phân loại đa nhãn |
Có thể nhận nhiều nhãn đồng thời |
Một ảnh vừa có “người”, “xe” và “đường phố” |
Phân loại nhị phân phù hợp khi câu hỏi có hai trạng thái loại trừ nhau. Một giao dịch có thể được đánh dấu “nghi vấn” hoặc “không nghi vấn”; một khách hàng có thể thuộc nhóm “rời bỏ” hoặc “không rời bỏ”.
Phân loại đa lớp xuất hiện khi mỗi mẫu vẫn chỉ nhận một nhãn, nhưng có nhiều hơn hai lựa chọn. Nhận dạng chữ số viết tay là ví dụ điển hình: một ảnh cần được gán vào đúng một trong 10 lớp từ 0 đến 9.
Phân loại đa nhãn khác ở chỗ các nhãn không loại trừ nhau. Một tài liệu có thể đồng thời thuộc các nhãn “trí tuệ nhân tạo”, “dữ liệu” và “phần mềm”. Nếu ép bài toán này thành đa lớp và chỉ cho phép chọn một nhãn, hệ thống sẽ làm mất một phần thông tin đúng về mẫu.
Sự khác biệt này phải được xác định trước khi xây dựng mô hình, vì nó thay đổi cách mã hóa biến mục tiêu, cách đưa ra dự đoán và cách đánh giá kết quả.
Những bài toán thực tế nào phù hợp với phân loại?
Phân loại phù hợp với những tình huống mà quyết định cuối cùng có thể biểu diễn thành một hoặc nhiều nhóm xác định trước. Vì thế, phạm vi sử dụng của nó rộng hơn một ngành cụ thể.
Trong lọc nội dung, mô hình có thể quyết định email thuộc lớp spam hay bình thường, hoặc tài liệu thuộc nhóm chủ đề nào. Với dữ liệu khách hàng, đầu ra có thể là nhóm “có khả năng rời bỏ” và “không có khả năng rời bỏ”. Trong xử lý giao dịch, hệ thống có thể gắn nhãn các mẫu cần được kiểm tra thêm. Với hình ảnh, nhãn có thể biểu diễn loại đối tượng hoặc nhiều đối tượng cùng xuất hiện.
Điểm chung của các trường hợp này không phải là dữ liệu giống nhau, mà là đầu ra có thể được mô tả bằng các lớp. Đây là dấu hiệu quan trọng hơn tên ngành hoặc định dạng dữ liệu.
Một câu hỏi thực tế có thể được kiểm tra bằng cách nhìn vào đầu ra mong muốn. Nếu câu trả lời cần là “thuộc lớp nào?”, “có hay không?”, “loại nào?” hoặc “những nhãn nào áp dụng cho mẫu này?”, classification thường là hướng mô hình hóa phù hợp. Nếu câu trả lời cần là một giá trị liên tục như “bao nhiêu?”, bài toán có thể thuộc nhóm khác.
Phân loại khác hồi quy và phân cụm ở đâu?
Ranh giới dễ nhầm nhất là giữa phân loại, hồi quy và phân cụm. Cả ba đều có thể xử lý cùng một tập đặc trưng đầu vào, nhưng chúng giải quyết các mục tiêu khác nhau.
Hồi quy dự đoán một đại lượng số liên tục. Dự đoán giá căn hộ là hồi quy nếu đầu ra cần là 2,8 tỷ đồng, 3,1 tỷ đồng hoặc một giá trị số khác. Nếu mục tiêu được định nghĩa lại thành “giá thấp”, “giá trung bình” và “giá cao”, bài toán mới trở thành phân loại. Việc chia một biến liên tục thành các lớp chỉ hợp lý khi các ngưỡng đó có ý nghĩa đối với quyết định thực tế; chia tùy ý có thể làm mất thông tin.
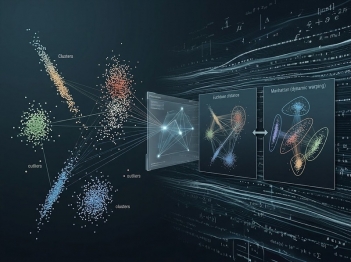
Phân cụm lại không yêu cầu các nhãn mục tiêu có sẵn theo cách của học có giám sát. Thuật toán tìm cấu trúc hoặc những nhóm tương đồng trong dữ liệu. Vì vậy, câu hỏi “khách hàng này thuộc một trong các nhóm đã được định nghĩa trước nào?” có thể là phân loại, còn “dữ liệu khách hàng tự nhiên tạo thành những nhóm nào?” gần với phân cụm hơn.
Ranh giới này ngăn một hiểu nhầm phổ biến: classification không có nghĩa là bất kỳ thao tác nào “chia dữ liệu thành nhóm”. Nó dự đoán những lớp mục tiêu đã được xác định, dựa trên quan hệ học được từ dữ liệu có nhãn.
Điều kiện để bài toán phù hợp với phân loại
Một mục tiêu dạng danh mục chưa đủ để bảo đảm mô hình phân loại sẽ hữu ích. Trước hết, các lớp phải được định nghĩa nhất quán. Nếu cùng một trường hợp có thể được người gán nhãn đưa vào nhiều lớp khác nhau chỉ vì tiêu chí không rõ, mô hình sẽ học từ một mục tiêu chứa nhiều nhiễu.
Dữ liệu huấn luyện cũng phải chứa các đặc trưng liên quan đến nhãn. Mô hình không thể suy ra một lớp ổn định nếu thông tin cần thiết để phân biệt các lớp không tồn tại trong đầu vào. Quan trọng hơn, các đặc trưng được dùng khi huấn luyện phải thực sự có sẵn tại thời điểm dự đoán. Nếu dữ liệu chứa thông tin chỉ xuất hiện sau khi kết quả đã xảy ra, mô hình có thể đạt kết quả rất tốt trong thử nghiệm nhưng không hoạt động tương tự khi triển khai; đây là một dạng rò rỉ dữ liệu.
Phân bố lớp cũng ảnh hưởng trực tiếp đến cách đánh giá. Giả sử 99% mẫu thuộc lớp âm và chỉ 1% thuộc lớp dương. Một mô hình luôn dự đoán “âm” vẫn đạt accuracy 99%, dù không phát hiện được bất kỳ mẫu dương nào. Trong trường hợp đó, accuracy đơn thuần không phản ánh mục tiêu thực tế; precision, recall hoặc các chỉ số phù hợp với chi phí của từng loại sai số cần được xem xét.
Không có một ngưỡng accuracy chung có thể xác nhận mọi bộ phân loại là “đủ tốt”. Yêu cầu chấp nhận được phụ thuộc vào bài toán, độ cân bằng lớp và hậu quả của false positive so với false negative.
Giới hạn cần hiểu trước khi dùng kết quả phân loại
Nhãn dự đoán không phải là sự thật chắc chắn. Nó là kết quả của mô hình dựa trên dữ liệu và quan hệ đã học. Nếu dữ liệu mới khác đáng kể so với dữ liệu huấn luyện, chất lượng dự đoán có thể giảm ngay cả khi mô hình từng hoạt động tốt trên tập kiểm thử.
Nhãn dữ liệu không chính xác cũng đặt ra một giới hạn khác. Khi các mẫu huấn luyện được gán sai hoặc tiêu chí giữa các lớp thay đổi theo thời gian, mô hình có thể học chính những sai lệch đó. Vấn đề không thể được khắc phục chỉ bằng cách chọn một thuật toán phức tạp hơn.
Cần phân biệt thêm giữa nhãn dự đoán, điểm số và xác suất đã hiệu chỉnh. Chẳng hạn, một mô hình trả về giá trị 0,8 không nhất thiết có nghĩa sự kiện sẽ xảy ra với xác suất 80%, trừ khi đầu ra đó thực sự là xác suất và đã có mức hiệu chỉnh phù hợp. Khi quyết định phụ thuộc vào mức độ chắc chắn chứ không chỉ vào nhãn, sự khác biệt này trở nên quan trọng.
Cuối cùng, lớp dự đoán chỉ có ý nghĩa khi cấu trúc của bài toán còn ổn định. Nếu định nghĩa lớp, hành vi người dùng hoặc phân bố dữ liệu thay đổi, quan hệ mà mô hình học trước đó có thể không còn phản ánh dữ liệu hiện tại. Vì vậy, classification phù hợp nhất khi bài toán có nhãn rõ ràng, dữ liệu đại diện và quy tắc đánh giá gắn với hậu quả thực tế của từng loại sai số.
Phân loại trong học máy giải quyết các bài toán mà đầu ra cần được gán vào những lớp rời rạc đã xác định trước. Mô hình học từ dữ liệu có nhãn, tạo điểm số hoặc xác suất cho dữ liệu mới rồi áp dụng quy tắc quyết định để đưa ra nhãn. Tùy cấu trúc đầu ra, bài toán có thể là nhị phân, đa lớp hoặc đa nhãn.
Việc nhận diện đúng classification không chỉ dựa vào việc dữ liệu “có nhiều nhóm”. Cần xem mục tiêu có phải nhãn rời rạc hay không, các lớp có được định nghĩa rõ ràng không, dữ liệu có chứa tín hiệu để phân biệt chúng không và loại sai số nào quan trọng nhất. Khi đầu ra là số liên tục, nên xem xét hồi quy; khi chưa có các lớp mục tiêu và mục tiêu là khám phá cấu trúc nhóm, phân cụm phù hợp hơn.

GỬI Ý KIẾN BÌNH LUẬN

