
Huấn luyện mô hình diễn ra theo quy trình nào?
Mục lục
Huấn luyện mô hình là quá trình dùng dữ liệu để điều chỉnh các tham số sao cho mô hình giảm sai số theo mục tiêu học. Quy trình đầy đủ không dừng ở việc chạy nhiều epoch mà còn gồm tách dữ liệu, tính loss, cập nhật tham số, theo dõi validation và đánh giá độc lập trên test set.
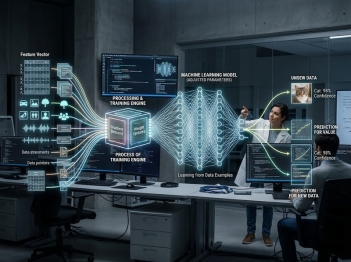
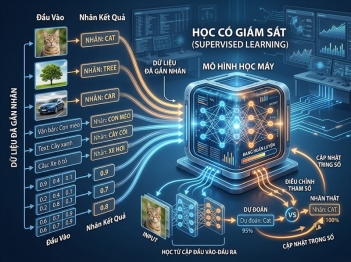
Huấn luyện mô hình là quá trình ước lượng hoặc điều chỉnh tham số của mô hình từ dữ liệu. Với các mô hình học bằng gradient, một vòng lặp điển hình diễn ra theo chuỗi: đưa một batch dữ liệu qua mô hình, tính dự đoán, đo sai số bằng hàm mất mát, tính gradient của sai số theo các tham số rồi để optimizer cập nhật các tham số. Chuỗi này lặp lại qua nhiều batch và nhiều epoch.
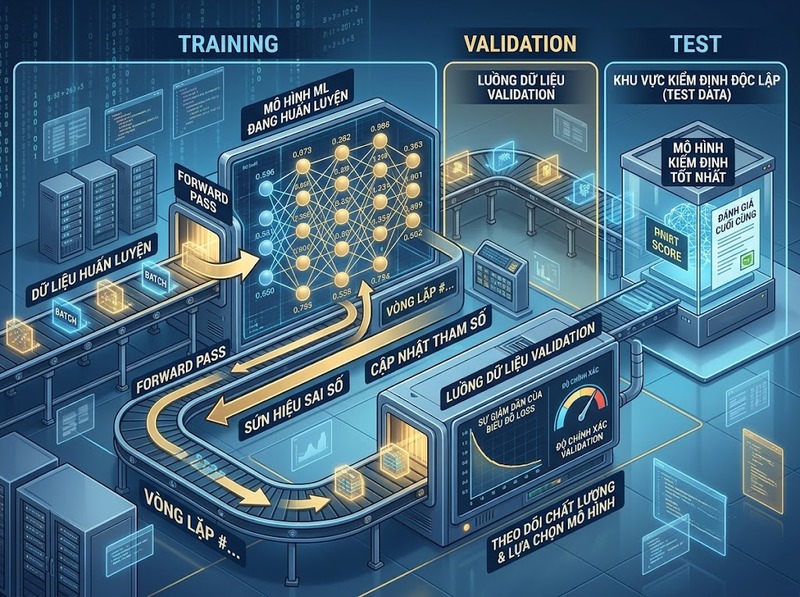
Loss thấp trên dữ liệu huấn luyện chưa đủ để kết luận mô hình tốt. Mô hình còn phải duy trì kết quả trên dữ liệu không được dùng trực tiếp để cập nhật tham số. Vì vậy, quy trình thường tách training set, validation set và test set, mỗi tập đảm nhiệm một vai trò khác nhau trong việc học, chọn mô hình và xác nhận khả năng tổng quát hóa.
Cơ chế cập nhật cụ thể phụ thuộc loại mô hình. Forward pass, backpropagation và gradient descent là cách giải thích phù hợp với mạng nơ-ron cùng các mô hình khả vi; những thuật toán khác vẫn có thể học tham số hoặc cấu trúc từ dữ liệu mà không dùng backpropagation.
Huấn luyện mô hình thực sự thay đổi điều gì?
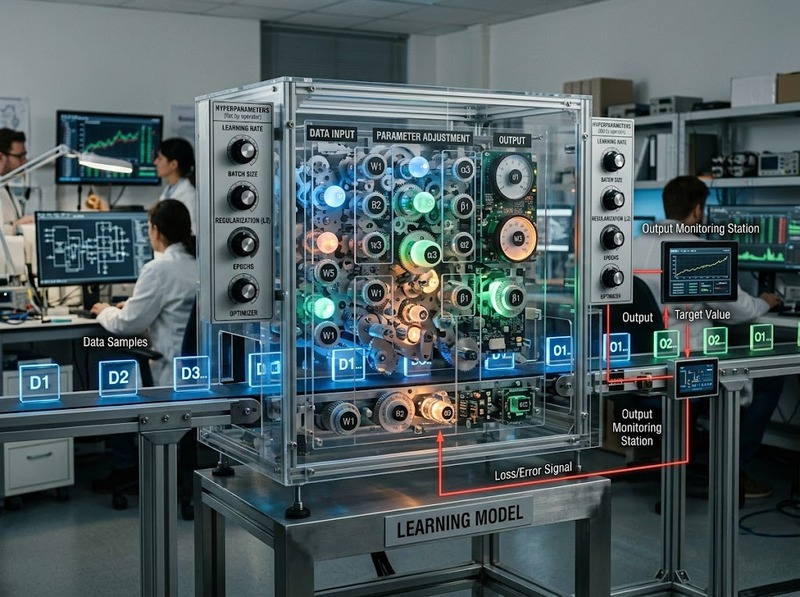
Trong quá trình huấn luyện, dữ liệu tạo ra các ví dụ đầu vào và mục tiêu; thuật toán học dùng chúng để thay đổi tham số của mô hình. Với mạng nơ-ron, tham số thường là trọng số và bias. Với hồi quy tuyến tính, chúng là các hệ số. Khi tham số thay đổi, cùng một đầu vào có thể tạo ra dự đoán khác.
Tham số được học từ dữ liệu trong quá trình tối ưu. Siêu tham số như learning rate, kích thước batch, số lớp hoặc mức regularization lại được đặt trước hoặc lựa chọn thông qua quá trình tuning; chúng không được cập nhật theo cùng cơ chế gradient tiêu chuẩn dùng cho trọng số.
Về mặt khái quát, huấn luyện liên kết ba hoạt động: tạo dự đoán từ trạng thái tham số hiện tại, đo mức sai lệch so với mục tiêu rồi thay đổi tham số theo quy tắc học. Nếu thuật toán không dùng gradient, bước thay đổi này có thể dựa trên tiêu chí chia nhánh, nghiệm đóng hoặc cơ chế tối ưu khác. Backpropagation vì thế là một phương pháp tính gradient cho mô hình khả vi, không phải định nghĩa của toàn bộ quá trình huấn luyện.
Bước 1: Chuẩn bị và chia dữ liệu đúng vai trò
Dữ liệu phải được chuyển về dạng mô hình có thể xử lý và được phân chia theo mục đích sử dụng. Trong thiết lập phổ biến, training set được dùng để cập nhật tham số; validation set dùng để theo dõi hiệu năng và hỗ trợ chọn cấu hình, checkpoint hoặc thời điểm dừng; test set được giữ độc lập để đánh giá cuối cùng.
Không có một tỷ lệ chia 70/15/15 hay 80/10/10 đúng cho mọi bài toán. Tỷ lệ phù hợp phụ thuộc quy mô dữ liệu, độ biến thiên của mẫu và cách dữ liệu được sinh ra. Với chuỗi thời gian, phép chia còn phải tôn trọng thứ tự thời gian. Nếu nhiều bản ghi đến từ cùng một người dùng hoặc thiết bị, việc chia theo nhóm có thể cần thiết để tránh cùng một thực thể xuất hiện ở cả train và test.
Rò rỉ dữ liệu vẫn có thể xảy ra dù ba tập đã nằm trong ba file riêng. Chẳng hạn, nếu chuẩn hóa một biến bằng trung bình và độ lệch chuẩn tính trên toàn bộ dữ liệu trước khi chia, thông tin từ validation và test đã ảnh hưởng đến dữ liệu huấn luyện. Các tham số tiền xử lý nên được ước lượng trên training set rồi dùng nguyên phép biến đổi đó cho validation và test.
Validation được phép ảnh hưởng đến quyết định chọn mô hình; test thì không. Nếu kết quả test liên tục được xem để chỉnh learning rate, kiến trúc hoặc ngưỡng phân loại, tập test đã tham gia gián tiếp vào quá trình tuning và không còn cung cấp một phép đo độc lập đúng nghĩa.
Bước 2: Xác định hàm mất mát và trạng thái ban đầu
Trước khi cập nhật tham số, quá trình học cần một đại lượng đo trạng thái hiện tại sai lệch đến đâu so với mục tiêu. Đại lượng này là hàm mất mát — loss function hoặc objective. Loss biến chênh lệch giữa dự đoán và mục tiêu thành giá trị mà thuật toán tối ưu có thể giảm.
Với hồi quy, mean squared error có dạng:
[
\mathrm{MSE}=\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat{y}_i)^2
]
Với phân loại xác suất, cross-entropy thường được dùng vì dự đoán sai với độ tự tin cao tạo loss lớn. Loại loss phải phù hợp với dạng đầu ra và mục tiêu học; một metric dễ hiểu với người dùng chưa chắc là hàm thích hợp để tối ưu trực tiếp.
Tham số khác siêu tham số ở đâu?
Mô hình bắt đầu từ một trạng thái tham số ban đầu. Với nhiều mạng nơ-ron, trọng số được khởi tạo theo một phân phối được thiết kế để tránh tín hiệu tăng hoặc giảm quá mạnh qua các lớp. Sau đó, từng training step mới thay đổi các trọng số này.
Learning rate, batch size hay hệ số regularization điều khiển cách việc học diễn ra. Learning rate quá lớn có thể khiến bước cập nhật vượt qua vùng có loss thấp; quá nhỏ có thể khiến quá trình hội tụ chậm hoặc mất nhiều bước cho mức cải thiện rất nhỏ. Không tồn tại một learning rate tối ưu chung cho mọi kiến trúc, optimizer và tập dữ liệu.
Loss khác metric đánh giá như thế nào?
Loss là tín hiệu thuật toán tối ưu trực tiếp hoặc gần trực tiếp. Metric là thước đo dùng để diễn giải chất lượng theo mục tiêu đánh giá. Hai đại lượng có thể giống nhau trong một số bài toán nhưng không bắt buộc.
Một mô hình phân loại có thể tối ưu cross-entropy nhưng được đánh giá bằng accuracy, precision, recall hoặc F1. Vì vậy, loss cần phù hợp với cơ chế học, còn metric phải phản ánh loại sai sót thực sự cần kiểm soát.
Bước 3: Tính loss, gradient và cập nhật tham số
Một training step của mô hình khả vi có thể mô tả bằng chuỗi nhân quả: forward pass → loss → gradient → optimizer update. Đây là bước trực tiếp biến thông tin từ một batch dữ liệu thành thay đổi trong tham số.
Forward pass và loss
Trong forward pass, batch đầu vào đi qua các phép biến đổi của mô hình để tạo dự đoán (\hat{y}). Dự đoán được so với nhãn hoặc mục tiêu (y) thông qua hàm mất mát. Loss tại thời điểm đó phản ánh mức độ phù hợp của trạng thái tham số hiện tại với batch theo objective đã chọn.
Loss của một batch không phải điểm chất lượng cuối cùng của mô hình. Hai batch có độ khó khác nhau có thể tạo loss khác nhau ngay cả khi tham số chưa thay đổi. Giá trị này chủ yếu cung cấp tín hiệu cho bước tối ưu tiếp theo.
Gradient, backpropagation và optimizer
Gradient (\nabla_\theta L(\theta)) mô tả loss thay đổi như thế nào theo từng tham số (\theta). Với mạng nơ-ron, backpropagation áp dụng quy tắc dây chuyền để tính các đạo hàm từ lớp đầu ra ngược về những lớp trước.
Backpropagation không tự cập nhật trọng số. Nó tạo gradient; optimizer mới sử dụng gradient để thay đổi tham số. Với gradient descent ở dạng đơn giản:
[
\theta_{t 1}=\theta_t-\eta\nabla_\theta L(\theta_t)
]
Trong đó (\eta) là learning rate. Các optimizer như SGD với momentum hoặc Adam còn duy trì trạng thái bổ sung để điều chỉnh hướng và độ lớn của bước cập nhật. Các vòng lặp huấn luyện trong những framework như PyTorch và TensorFlow cũng phân biệt việc tính gradient với optimizer step.
Sau optimizer step, mô hình có một trạng thái tham số mới. Batch tiếp theo tạo gradient tại trạng thái mới đó. Việc học hình thành từ chuỗi cập nhật liên tiếp chứ không phải từ một phép tính đơn lẻ.
Bước 4: Lặp qua batch, epoch và theo dõi validation
Training set thường được chia thành các mini-batch để mô hình tính toán và cập nhật tham số theo từng nhóm mẫu. Khi mô hình đã đi qua toàn bộ training set một lần, quá trình đó được gọi là một epoch. Nếu tập huấn luyện có (N) mẫu và batch size là (B), một epoch có xấp xỉ (\lceil N/B\rceil) bước cập nhật khi mỗi mẫu được sử dụng một lần.
Batch và epoch
Batch nhỏ tạo nhiều lần cập nhật hơn trong một epoch và gradient thường có phương sai lớn hơn vì mỗi bước chỉ dựa trên một phần nhỏ dữ liệu. Batch lớn sử dụng nhiều mẫu hơn cho mỗi ước lượng gradient nhưng tốn bộ nhớ hơn và không mặc nhiên tạo khả năng tổng quát hóa tốt hơn. Batch size vì thế cần được lựa chọn cùng learning rate, tài nguyên tính toán và đặc tính dữ liệu.
Số epoch cũng không phải thước đo chất lượng. 100 epoch không tự động tốt hơn 20 epoch. Nếu training loss tiếp tục giảm nhưng hiệu năng trên validation bắt đầu xấu đi, mô hình đang cải thiện mức độ khớp training set mà không cải thiện tương ứng trên dữ liệu chưa dùng để cập nhật trọng số.
Validation, overfitting và early stopping
Sau một số bước hoặc sau mỗi epoch, mô hình được chạy trên validation set ở chế độ không cập nhật tham số. Training loss phản ánh mức độ khớp với dữ liệu đã học; validation metric cho biết hiệu năng có được duy trì trên dữ liệu không tham gia cập nhật trọng số hay không.
Một biểu hiện điển hình của overfitting là training loss tiếp tục giảm trong khi validation loss tăng hoặc validation metric suy giảm. Early stopping dùng tín hiệu validation để dừng quá trình và thường giữ checkpoint đạt kết quả validation tốt nhất.
Validation metric vẫn có nhiễu. Một lần giảm điểm chưa đủ để kết luận mô hình đã overfit, nhất là khi validation set nhỏ hoặc metric có phương sai cao. Tiêu chí dừng vì vậy có thể dùng một khoảng patience, ngưỡng cải thiện tối thiểu hoặc nhiều lần đánh giá liên tiếp. Không có số epoch hay patience cố định phù hợp với mọi bài toán.
Bước 5: Đánh giá trên test set và xác nhận kết quả
Sau khi kiến trúc, siêu tham số, checkpoint và thời điểm dừng đã được chốt, mô hình mới được đánh giá trên test set. Tập này không tham gia cập nhật tham số và không nên tham gia chu trình chọn mô hình. Kết quả test nhằm ước lượng hiệu năng của mô hình đã chọn trên dữ liệu không tác động đến những quyết định trước đó.
Chọn metric theo bài toán
Metric phải phản ánh loại sai sót cần kiểm soát. Với phân loại cân bằng và chi phí các loại lỗi tương đối đồng đều, accuracy có thể dễ diễn giải. Nhưng nếu 95% mẫu thuộc lớp âm, một mô hình luôn dự đoán lớp âm vẫn đạt 95% accuracy trong khi recall của lớp dương bằng 0%. Khi lớp dương hiếm hoặc bỏ sót lớp dương gây hậu quả lớn, precision, recall hoặc F1 cung cấp thông tin phù hợp hơn.
Với hồi quy, MAE biểu diễn sai số tuyệt đối trung bình theo đơn vị gốc; RMSE nhạy hơn với sai số lớn vì phần sai lệch được bình phương trước khi lấy trung bình.
Không tồn tại một ngưỡng accuracy, F1 hay RMSE chung để kết luận một mô hình đã “tốt”. Con số phải được đặt cạnh baseline, yêu cầu kỹ thuật hoặc nghiệp vụ, độ khó của dữ liệu và chi phí của từng loại lỗi. 95% accuracy có thể rất mạnh ở một bài toán nhưng không mang thêm giá trị nếu baseline đơn giản cũng đã đạt 95%.
Giữ test set độc lập đến cuối
Nếu kết quả test không đạt yêu cầu và nhóm phát triển quay lại chỉnh mô hình dựa trực tiếp trên kết quả đó, test set đã bắt đầu ảnh hưởng đến quá trình lựa chọn. Sau nhiều vòng, điểm test có thể trở nên lạc quan vì các quyết định đã được điều chỉnh gián tiếp theo chính dữ liệu dùng để đánh giá.
Các vòng thử nghiệm và so sánh lựa chọn nên diễn ra trên validation set. Test set được giữ cho phép xác nhận cuối cùng; nếu tập test cũ đã bị khai thác quá nhiều trong quá trình phát triển, một tập holdout mới có thể cần thiết để khôi phục phép đánh giá độc lập.
Kết quả cuối cùng đáng tin cậy hơn khi mô hình không chỉ giảm loss trên training set mà còn duy trì metric phù hợp trên dữ liệu không tham gia cập nhật tham số hoặc lựa chọn mô hình.
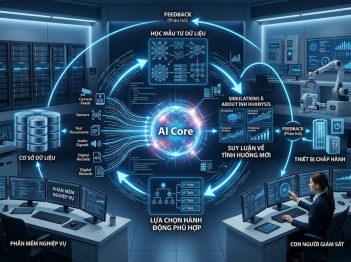
Huấn luyện mô hình có thể được nhìn như một chuỗi kiểm soát khép kín: dữ liệu huấn luyện tạo tín hiệu học, loss lượng hóa sai lệch, thuật toán tối ưu cập nhật tham số, validation giám sát khả năng tổng quát hóa và test set xác nhận kết quả cuối. Với mô hình dùng gradient, phần lõi của mỗi training step là forward pass, tính loss, tính gradient và optimizer step; với các thuật toán khác, cơ chế cập nhật có thể khác nhưng mục tiêu vẫn là học từ dữ liệu theo một tiêu chí xác định.
Chất lượng quy trình không được xác định bởi số epoch hay training loss riêng lẻ. Dữ liệu phải được tách đúng vai trò, loss và metric phải phù hợp với mục tiêu, validation phải đảm nhiệm việc tuning thay cho test, còn kết quả cuối cần được đọc trong ngữ cảnh của baseline và yêu cầu thực tế. Khi các ranh giới này được giữ đúng, phép đánh giá phản ánh khả năng tổng quát hóa thay vì chỉ phản ánh mức độ mô hình đã khớp tập huấn luyện.

GỬI Ý KIẾN BÌNH LUẬN

