
Đặc trưng ảnh hưởng khả năng dự đoán của mô hình thế nào?
Mục lục
Đặc trưng trong học máy là cách dữ liệu được biểu diễn để mô hình nhận biết quy luật và tạo dự đoán. Chất lượng đặc trưng có thể quyết định mức độ chính xác, khả năng tổng quát và độ ổn định của mô hình.
Trong học máy, mô hình không trực tiếp “hiểu” dữ liệu theo cách con người hiểu một đối tượng. Nó nhận đầu vào dưới dạng các giá trị được biểu diễn thành đặc trưng (feature) và dùng những giá trị đó để tìm mối quan hệ với biến mục tiêu. Vì vậy, cùng một thuật toán nhưng cách dữ liệu được biểu diễn bằng đặc trưng khác nhau có thể dẫn đến khả năng dự đoán rất khác nhau.
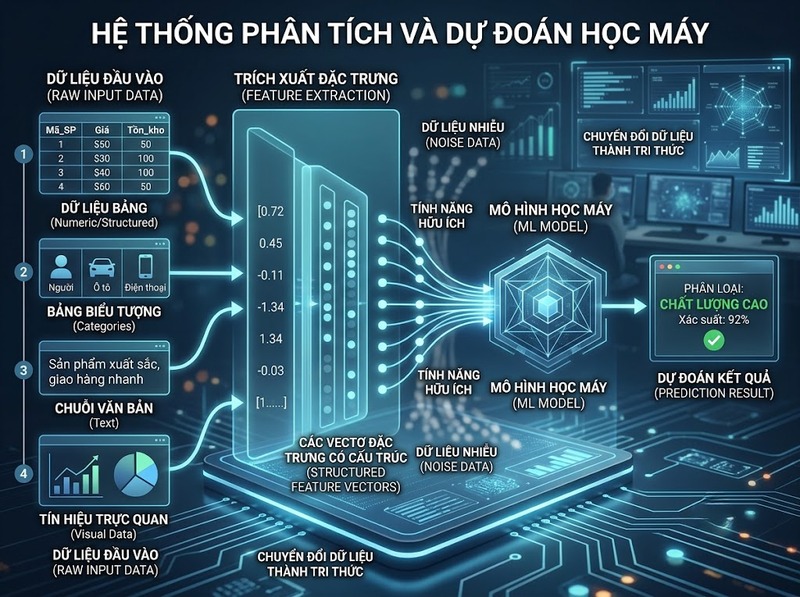
Nói đơn giản, đặc trưng là thông tin đầu vào mà mô hình sử dụng để suy ra kết quả. Một đặc trưng phù hợp giúp mô hình nhìn thấy tín hiệu liên quan đến mục tiêu; đặc trưng nhiễu, dư thừa hoặc được biểu diễn không phù hợp có thể khiến quá trình học trở nên khó khăn hơn.
Đặc trưng trong học máy là gì?
Đặc trưng là một thuộc tính hoặc biến được sử dụng để biểu diễn một quan sát trong dữ liệu. Với bài toán dự đoán giá nhà, chẳng hạn, diện tích, số phòng ngủ, vị trí hoặc tuổi của căn nhà có thể là các đặc trưng, còn giá bán là biến mục tiêu.
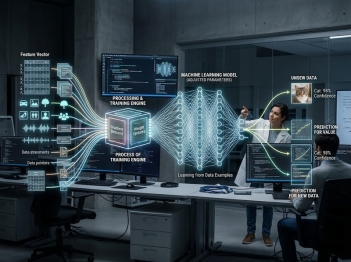
Nếu một quan sát được biểu diễn bởi nhiều đặc trưng, nó có thể được xem như một vector:
x = (x₁, x₂, ..., xₙ)
Trong đó mỗi thành phần đại diện cho một đặc trưng. Mô hình nhận vector này làm đầu vào và học một hàm để tạo ra dự đoán:
ŷ = f(x)
Điểm quan trọng là đặc trưng không chỉ là “cột dữ liệu”. Nó là cách thông tin của đối tượng được đưa vào không gian mà thuật toán có thể xử lý.
Đặc trưng có thể có nhiều dạng:
· Số: Tuổi, thu nhập, diện tích, số lần giao dịch
· Phân loại: Loại sản phẩm, khu vực, phương thức thanh toán
· Nhị phân: Có hoặc không có một thuộc tính
· Văn bản: Từ, cụm từ hoặc biểu diễn vector của nội dung
· Hình ảnh: Giá trị điểm ảnh hoặc các biểu diễn đặc trưng được trích xuất
· Thời gian: Ngày, tháng, giờ hoặc khoảng thời gian kể từ một sự kiện
Với đặc trưng phân loại hoặc dữ liệu phi số, dữ liệu thường cần được biến đổi sang dạng phù hợp với thuật toán trước khi huấn luyện.
Vì sao đặc trưng quyết định thông tin mà mô hình có thể học?
Một mô hình chỉ có thể khai thác những tín hiệu được phản ánh trong đầu vào. Nếu đặc trưng chứa thông tin liên quan đến biến mục tiêu, mô hình có cơ sở để học mối quan hệ; nếu thông tin quan trọng bị bỏ qua, mô hình khó có thể khôi phục đầy đủ từ đầu vào.
Có thể hình dung quá trình này theo chuỗi:
Dữ liệu thực tế → Biểu diễn bằng đặc trưng → Mô hình học quan hệ → Dự đoán
Chẳng hạn, muốn dự đoán khả năng một khách hàng tiếp tục sử dụng dịch vụ, các thông tin như thời gian sử dụng, tần suất tương tác hoặc lịch sử giao dịch có thể mang tín hiệu liên quan. Nếu chỉ đưa vào một đặc trưng ít liên quan, mô hình sẽ có ít cơ sở để phân biệt các trường hợp khác nhau.
Điều này giải thích vì sao chất lượng đặc trưng có thể ảnh hưởng trực tiếp đến không gian thông tin mà mô hình quan sát được. Một thuật toán mạnh không thể bù đắp hoàn toàn cho đầu vào không chứa tín hiệu cần thiết.
Đặc trưng tốt và đặc trưng nhiễu khác nhau thế nào?
Một đặc trưng có giá trị không nhất thiết phải có tương quan đơn giản với mục tiêu. Giá trị của nó nằm ở việc nó có giúp mô hình phân biệt, ước lượng hoặc giải thích biến mục tiêu trong bối cảnh bài toán hay không.
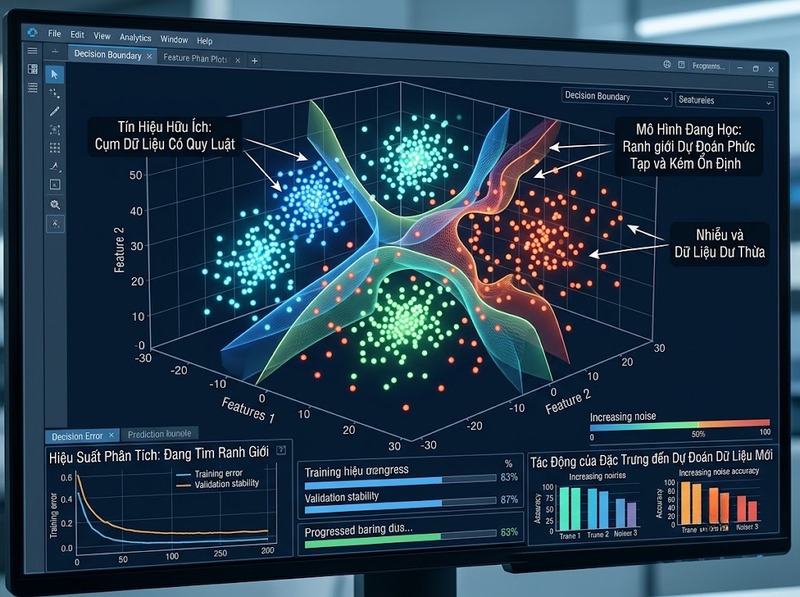
Ngược lại, đặc trưng nhiễu có thể đưa thêm biến động không liên quan vào quá trình học. Đặc trưng dư thừa cũng có thể cung cấp thông tin trùng lặp với những biến khác mà không tạo thêm nhiều giá trị.
Vì vậy, mục tiêu không phải là đưa càng nhiều đặc trưng càng tốt mà là xây dựng biểu diễn chứa đủ tín hiệu cần thiết với mức nhiễu và độ phức tạp phù hợp.
Chất lượng đặc trưng tác động đến khả năng dự đoán ra sao?
Ảnh hưởng của đặc trưng thể hiện qua nhiều cơ chế khác nhau, từ lượng thông tin hữu ích đến khả năng tổng quát hóa của mô hình.
Đặc trưng có tín hiệu phù hợp có thể giúp mô hình tìm được quy luật dễ hơn. Đặc trưng thiếu thông tin khiến bài toán trở nên khó hơn, trong khi đặc trưng nhiễu hoặc không ổn định có thể làm mô hình học những quan hệ không bền vững.
Một cách đánh giá thực tế là thực hiện ablation test: huấn luyện và đánh giá cùng một mô hình trên cùng quy trình, sau đó so sánh hiệu quả khi thêm hoặc loại bỏ một nhóm đặc trưng. Các chỉ số như Accuracy, F1, Precision, Recall đối với phân loại hoặc MAE, RMSE đối với hồi quy có thể được dùng để định lượng thay đổi.
Tuy nhiên, cải thiện trên tập huấn luyện chưa đủ để kết luận đặc trưng có giá trị. Đặc trưng chỉ thực sự hữu ích khi đóng góp vào khả năng dự đoán trên dữ liệu chưa từng thấy.
Đặc trưng có thể giúp hoặc làm giảm khả năng tổng quát hóa
Một đặc trưng có thể giúp mô hình dự đoán rất tốt trên dữ liệu huấn luyện nhưng lại kém hiệu quả trên dữ liệu mới nếu nó phản ánh những tín hiệu quá đặc thù của tập huấn luyện.
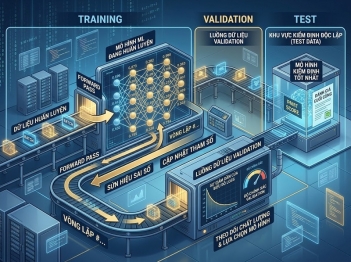
Đây là một trong những lý do cần đánh giá đặc trưng bằng validation hoặc cross-validation thay vì chỉ nhìn vào kết quả trên training set.
Đặc biệt, cần tránh data leakage: một đặc trưng vô tình chứa thông tin chỉ có thể biết sau thời điểm cần dự đoán có thể tạo ra kết quả đánh giá giả tạo. Khi đưa mô hình vào thực tế, thông tin đó không còn tồn tại tại thời điểm dự đoán và hiệu năng có thể giảm mạnh.
Feature engineering và feature selection có vai trò gì?
Feature engineering là quá trình biến đổi hoặc tạo biểu diễn đặc trưng phù hợp hơn từ dữ liệu có sẵn. Mục tiêu không đơn thuần là tạo thêm cột mà là làm cho thông tin hữu ích trở nên dễ khai thác hơn đối với mô hình.
Ví dụ, từ thời điểm giao dịch có thể tạo ra các đặc trưng như giờ trong ngày hoặc ngày trong tuần nếu những yếu tố này có ý nghĩa đối với bài toán. Từ hai biến số cũng có thể xây dựng một biến thể hiện tỷ lệ hoặc quan hệ giữa chúng khi biểu diễn đó phù hợp với vấn đề cần dự đoán.
Trong khi đó, feature selection tập trung vào việc chọn những đặc trưng cần thiết và loại bỏ những đặc trưng ít giá trị, dư thừa hoặc gây nhiễu.
Hai quá trình này giải quyết những vấn đề khác nhau:
· Feature engineering: Tìm cách biểu diễn thông tin hữu ích tốt hơn
· Feature selection: Giữ lại những đặc trưng có giá trị và loại bỏ phần không cần thiết
Hiệu quả của chúng cần được kiểm chứng bằng kết quả trên dữ liệu đánh giá phù hợp, thay vì giả định rằng mọi đặc trưng mới đều làm mô hình tốt hơn.
Không phải càng nhiều đặc trưng thì mô hình càng dự đoán tốt
Một hiểu lầm phổ biến là thêm nhiều đặc trưng sẽ luôn cung cấp thêm thông tin cho mô hình. Trên thực tế, số lượng đặc trưng tăng có thể đi kèm với nhiễu, thông tin trùng lặp và không gian đầu vào phức tạp hơn.
Khi số chiều tăng nhưng lượng dữ liệu hữu ích không tăng tương ứng, mô hình có thể gặp khó khăn trong việc tìm ra quy luật ổn định. Đây là một phần của vấn đề thường được gọi là curse of dimensionality.
Do đó, một tập đặc trưng nhỏ nhưng phù hợp có thể có giá trị hơn một tập đặc trưng rất lớn nhưng chứa nhiều thông tin dư thừa hoặc không liên quan.
Cũng cần phân biệt feature importance với chất lượng tuyệt đối của một đặc trưng. Một phương pháp có thể đánh giá một đặc trưng quan trọng trong một mô hình cụ thể, nhưng điều đó không có nghĩa đặc trưng ấy luôn quan trọng với mọi thuật toán, tập dữ liệu hoặc cách biểu diễn khác.
Làm thế nào để đánh giá đặc trưng trước khi đưa vào mô hình?
Đánh giá đặc trưng nên bắt đầu từ câu hỏi: đặc trưng này có giúp mô hình giải quyết đúng bài toán dự đoán hay không?
Có thể kiểm tra theo một chuỗi logic:
1. Xác định mối quan hệ với bài toán: Đặc trưng có cơ sở để liên quan đến biến mục tiêu hay không
2. Kiểm tra chất lượng dữ liệu: Xem xét giá trị thiếu, sai lệch, ngoại lệ và tính nhất quán
3. Kiểm tra cách biểu diễn: Đảm bảo kiểu dữ liệu được mã hóa hoặc biến đổi phù hợp với thuật toán
4. Kiểm tra thông tin dư thừa: Xem đặc trưng có trùng lặp đáng kể với những biến khác hay không
5. Kiểm tra data leakage: Đảm bảo đặc trưng chỉ sử dụng thông tin thực sự có sẵn tại thời điểm dự đoán
6. Đánh giá trên dữ liệu chưa dùng để huấn luyện: So sánh các chỉ số dự đoán bằng validation hoặc cross-validation
7. Kiểm tra độ ổn định: Xem đóng góp của đặc trưng có duy trì trên các tập dữ liệu hoặc phân chia dữ liệu khác nhau hay không
Cách tiếp cận này giúp chuyển câu hỏi “đặc trưng này có tốt không?” thành một câu hỏi có thể kiểm chứng bằng dữ liệu.
Đặc trưng trong học máy không chỉ là các biến đầu vào mà là cách thông tin được biểu diễn để mô hình có thể học và dự đoán. Đặc trưng phù hợp giúp mô hình tiếp cận đúng tín hiệu của bài toán; đặc trưng nhiễu, dư thừa, thiếu ổn định hoặc gây leakage có thể làm suy giảm khả năng tổng quát hóa. Vì vậy, hiệu quả dự đoán phụ thuộc không chỉ vào thuật toán mà còn vào chất lượng biểu diễn dữ liệu, cách lựa chọn đặc trưng và cách kiểm chứng đóng góp của chúng trên dữ liệu chưa từng thấy.
Hỏi đáp về đặc trưng trong học máy
Đặc trưng trong học máy có phải là biến đầu vào không?
Về cơ bản, đặc trưng là các biến hoặc thuộc tính được dùng làm đầu vào cho mô hình. Tuy nhiên, một đặc trưng có thể là dữ liệu nguyên bản hoặc được tạo ra thông qua quá trình biến đổi và feature engineering.
Nhiều đặc trưng có luôn giúp mô hình chính xác hơn không?
Không. Đặc trưng bổ sung chỉ có giá trị khi cung cấp thông tin hữu ích và phù hợp. Đặc trưng nhiễu, dư thừa hoặc gây leakage có thể làm kết quả đánh giá sai lệch hoặc làm giảm khả năng tổng quát hóa.
Làm sao biết một đặc trưng có thực sự cải thiện mô hình?
Có thể so sánh hiệu quả của mô hình trước và sau khi thêm hoặc loại bỏ đặc trưng, trong cùng điều kiện đánh giá. Với phân loại có thể xem Accuracy, Precision, Recall hoặc F1; với hồi quy có thể xem MAE hoặc RMSE.
Feature engineering khác feature selection ở điểm nào?
Feature engineering tập trung vào việc tạo hoặc biến đổi cách biểu diễn thông tin, còn feature selection tập trung vào việc chọn những đặc trưng có giá trị và loại bỏ những đặc trưng không cần thiết.

GỬI Ý KIẾN BÌNH LUẬN

