Thông tin khoa học và công nghệ cập nhật từ nhiều nguồn tin trong nước và quốc tế
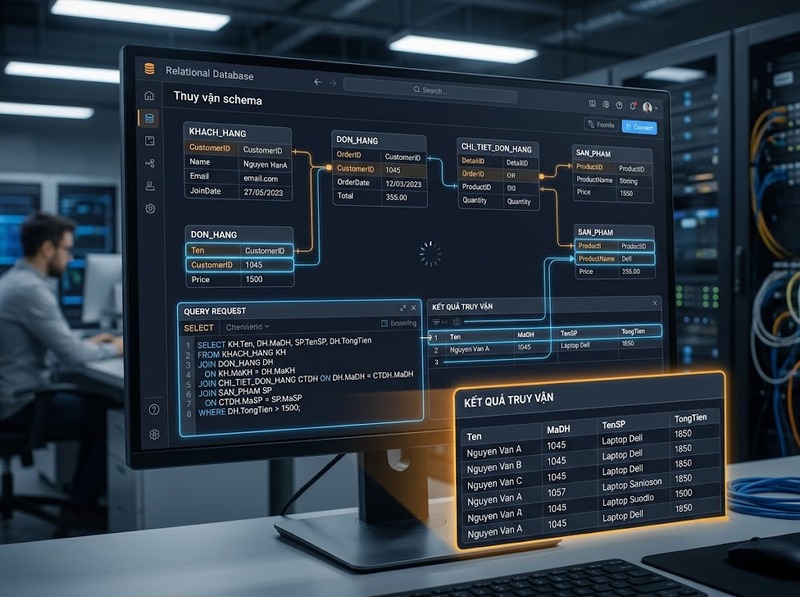
Truy vấn dữ liệu lấy thông tin từ cơ sở dữ liệu thế nào?
Truy vấn dữ liệu là cách đặt yêu cầu để hệ quản trị cơ sở dữ liệu tìm, lọc, sắp xếp hoặc tổng hợp những dữ liệu phù hợp với điều kiện được đưa ra. Thay vì đọc toàn bộ bảng, người dùng có thể xác định chính xác bản ghi và cột cần lấy, sau đó nhận về một tập kết quả phục vụ cho việc tra cứu hoặc phân tích.
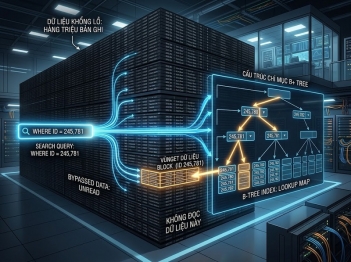
Chỉ mục dữ liệu tăng tốc truy vấn như thế nào?
Chỉ mục dữ liệu là gì và vì sao có thể tăng tốc truy vấn?
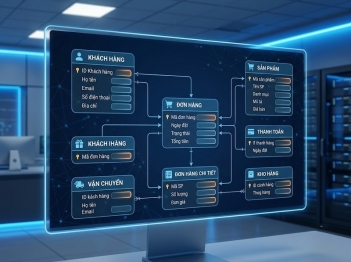
Schema dữ liệu tổ chức thông tin như thế nào?
Schema dữ liệu là cách mô tả có hệ thống một tập dữ liệu: dữ liệu gồm những thành phần nào, mỗi thành phần có trường gì, trường nhận kiểu giá trị nào và các thành phần liên kết với nhau ra sao. Nói đơn giản, nếu dữ liệu là nội dung cần lưu trữ thì schema là bản thiết kế cho biết nội dung đó được sắp xếp theo cấu trúc nào.
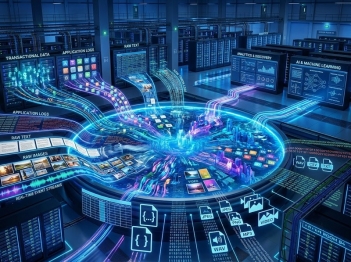
Data lake khác data warehouse như thế nào?
Data lake là gì?
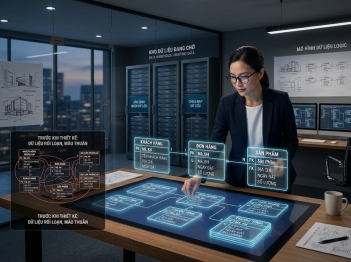
Vì sao cần thiết kế mô hình dữ liệu trước khi lưu trữ?
Trước khi một hệ thống lưu bản ghi đầu tiên, đã có một loạt câu hỏi cần được trả lời: dữ liệu đại diện cho đối tượng nào, thuộc tính nào mô tả đối tượng đó, các đối tượng liên hệ với nhau ra sao và những giá trị nào được phép tồn tại. Mô hình dữ liệu là bản thiết kế dùng để làm rõ những vấn đề này trước khi chúng được chuyển thành bảng, cột, trường dữ liệu, khóa hoặc cấu trúc lưu trữ cụ thể.
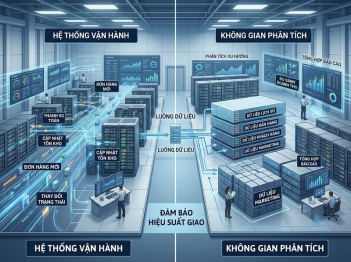
Data warehouse khác cơ sở dữ liệu vận hành như thế nào?
Data warehouse là hệ thống dữ liệu được thiết kế chủ yếu cho truy vấn, tổng hợp và phân tích; cơ sở dữ liệu vận hành chủ yếu phục vụ các giao dịch phát sinh hằng ngày của ứng dụng. Vì hai workload này có yêu cầu trái ngược nhau, chúng thường được tối ưu theo những cách khác nhau về mô hình dữ liệu, kiểu đọc/ghi, dữ liệu lịch sử và cách sử dụng tài nguyên.
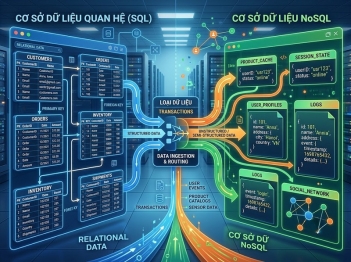
Cơ sở dữ liệu NoSQL khác cơ sở dữ liệu quan hệ thế nào?
Cơ sở dữ liệu NoSQL là nhóm hệ quản trị cơ sở dữ liệu không dựa chủ yếu trên mô hình bảng quan hệ truyền thống. Thay vì tổ chức dữ liệu thành các bảng gồm hàng và cột với schema chặt chẽ, NoSQL có thể sử dụng nhiều mô hình lưu trữ như document, key-value, column-family hoặc graph
Cơ sở dữ liệu quan hệ tổ chức dữ liệu như thế nào?
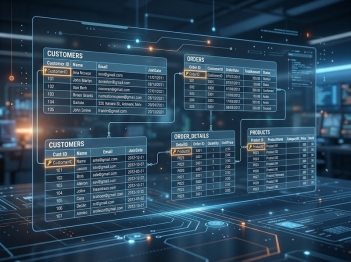
Cơ sở dữ liệu quan hệ là loại cơ sở dữ liệu tổ chức thông tin theo mô hình quan hệ (relational model). Dữ liệu được biểu diễn chủ yếu dưới dạng các bảng; mỗi bảng gồm các hàng và cột, trong đó hàng đại diện cho các bản ghi còn cột biểu diễn thuộc tính của đối tượng. Các bảng có thể liên kết với nhau thông qua khóa, đặc biệt là khóa chính và khóa ngoại.
Chuyển đổi dữ liệu được thực hiện như thế nào?
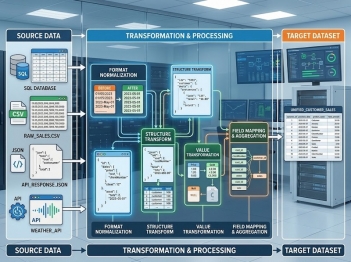
Chuyển đổi dữ liệu là quá trình biến dữ liệu từ trạng thái ban đầu sang một định dạng, cấu trúc hoặc tập giá trị phù hợp hơn với mục đích sử dụng. Thay đổi có thể chỉ nằm ở cách biểu diễn, chẳng hạn đổi ngày từ 12/08/2026 sang 2026-08-12, nhưng cũng có thể làm thay đổi cấu trúc bảng, kiểu dữ liệu, đơn vị đo hoặc cách các bản ghi được kết hợp.
Cơ sở dữ liệu giữ vai trò gì trong hệ thống thông tin?
Cơ sở dữ liệu là gì?
Có những mô hình lưu trữ dữ liệu phổ biến nào?
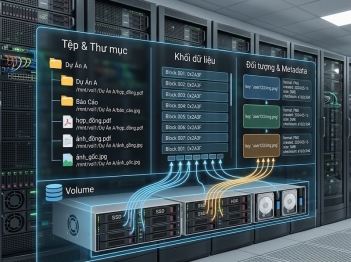
Lưu trữ dữ liệu (data storage) là quá trình ghi và duy trì thông tin số trên một phương tiện hoặc dịch vụ lưu trữ để dữ liệu vẫn có thể được đọc, cập nhật và sử dụng về sau. Trong bối cảnh hệ thống CNTT, thuật ngữ này thường nói đến persistent storage — dữ liệu tồn tại độc lập với vòng đời của một tiến trình hoặc phiên làm việc — thay vì bộ nhớ tạm như RAM.
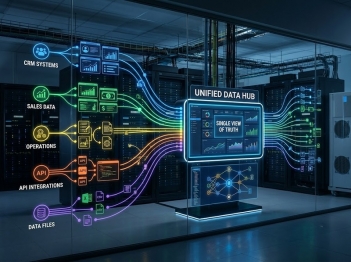
Vì sao cần tích hợp dữ liệu từ nhiều nguồn?
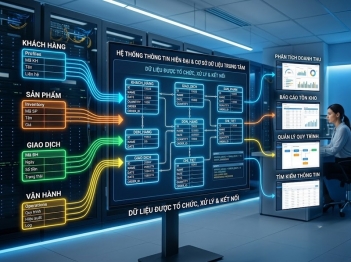
Trong thực tế, dữ liệu hiếm khi nằm trong một hệ thống duy nhất. Thông tin khách hàng có thể nằm ở CRM, giao dịch nằm trong hệ thống bán hàng, dữ liệu vận hành nằm ở phần mềm nội bộ, còn dữ liệu bên ngoài đến từ API hoặc các nền tảng đối tác. Mỗi nguồn có thể sử dụng cấu trúc, định dạng và quy ước riêng.
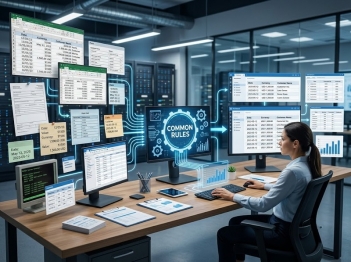
Chuẩn hóa dữ liệu tạo tính nhất quán như thế nào?
Chuẩn hóa dữ liệu là quá trình đưa dữ liệu về cùng một quy tắc biểu diễn và xử lý để những giá trị có cùng ý nghĩa được ghi nhận theo cách thống nhất. Quy tắc có thể bao gồm định dạng ngày tháng, cách viết tên, mã hóa giá trị, đơn vị đo, chữ hoa – chữ thường, giá trị rỗng và các điều kiện kiểm tra hợp lệ.
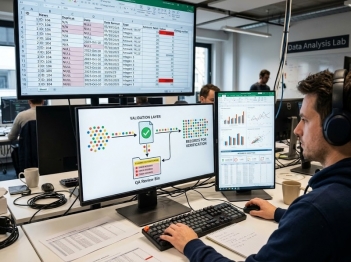
Vì sao cần làm sạch dữ liệu trước khi phân tích?
Làm sạch dữ liệu (data cleaning hoặc data cleansing) là quá trình phát hiện, đánh giá và xử lý các vấn đề chất lượng trong dữ liệu trước khi đưa dữ liệu vào tính toán. Các vấn đề thường gặp gồm giá trị thiếu, bản ghi trùng, sai kiểu dữ liệu, định dạng không nhất quán, giá trị ngoài miền hợp lệ và các điểm bất thường cần xác minh.
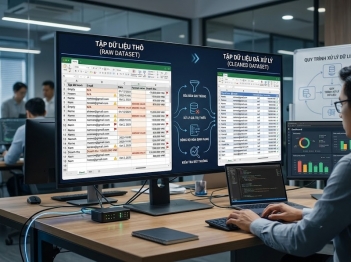
Tiền xử lý dữ liệu gồm những bước cơ bản nào?
Dữ liệu thu thập từ nhiều nguồn thường chứa giá trị thiếu, bản ghi trùng, sai định dạng, nhiễu hoặc các biến có thang đo khác nhau. Tiền xử lý dữ liệu là quá trình xử lý những vấn đề đó trước khi đưa dữ liệu vào phân tích, trực quan hóa hoặc mô hình học máy.
Dữ liệu bán cấu trúc phù hợp với những trường hợp nào?
Dữ liệu bán cấu trúc phù hợp khi thông tin vẫn cần có tổ chức, nhưng cấu trúc giữa các bản ghi có thể khác nhau hoặc thay đổi theo thời gian. Đây là điểm nằm giữa dữ liệu có cấu trúc chặt chẽ và dữ liệu hoàn toàn không có cấu trúc: dữ liệu vẫn chứa các dấu hiệu mô tả như trường, khóa, thẻ hoặc quan hệ phân cấp, nhưng không nhất thiết mọi bản ghi phải tuân theo cùng một schema.
Dữ liệu có cấu trúc và phi cấu trúc khác nhau thế nào?
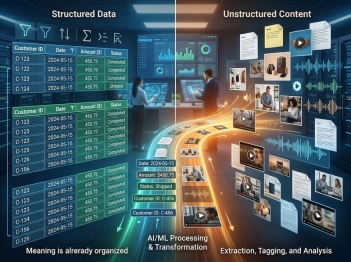
Điểm phân biệt quan trọng nhất không nằm ở việc dữ liệu là số, chữ hay tệp đa phương tiện, mà ở cách thông tin được tổ chức. Dữ liệu có cấu trúc tuân theo một schema xác định trước: các trường, kiểu dữ liệu và quan hệ được quy định đủ rõ để hệ thống biết mỗi giá trị nằm ở đâu và mang ý nghĩa gì. Dữ liệu phi cấu trúc không tuân theo một mô hình trường cố định như vậy; phần mang ý nghĩa thường nằm trong nội dung tự do như văn bản, hình ảnh, âm thanh hoặc video.
Vì sao quản lý cấu hình cần đảm bảo tính nhất quán?
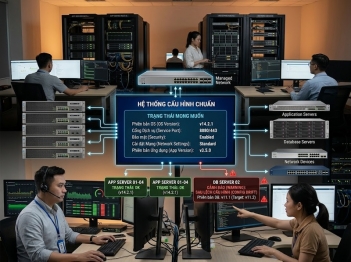
Trong một hệ thống hạ tầng, máy chủ, ứng dụng, cơ sở dữ liệu, mạng và các thành phần phụ thuộc không hoạt động độc lập. Chúng cùng dựa trên một tập hợp cấu hình về phiên bản, tham số vận hành, quyền truy cập, kết nối và các chính sách liên quan. Quản lý cấu hình là cách tổ chức và kiểm soát những trạng thái đó để hệ thống biết thành phần nào đang được cấu hình như thế nào, thay đổi nào đã được thực hiện và trạng thái nào được xem là chuẩn.
Dữ liệu khác thông tin như thế nào?
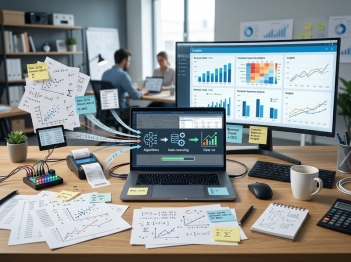
Dữ liệu và thông tin có quan hệ chặt chẽ nhưng không đồng nghĩa. Dữ liệu là những giá trị, ký hiệu hoặc quan sát được thu thập ở dạng chưa hoặc ít được diễn giải. Thông tin hình thành khi dữ liệu được xử lý, đặt vào ngữ cảnh và diễn giải để tạo ra ý nghĩa có thể sử dụng.
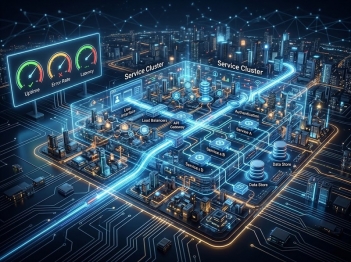
Observability khác giám sát hệ thống như thế nào?
Monitoring và observability đều xuất hiện trong vận hành hệ thống, nhưng chúng không phải hai cách gọi khác nhau cho cùng một hoạt động. Điểm phân biệt quan trọng nhất nằm ở khả năng hiểu trạng thái bên trong của hệ thống từ những gì có thể quan sát được bên ngoài.
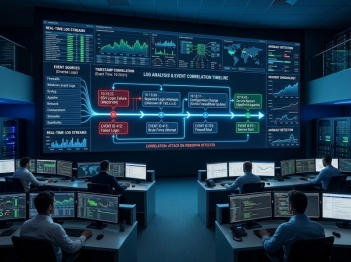
Log hệ thống được dùng để theo dõi hoạt động thế nào?
Log hệ thống, hay system log, là tập hợp các bản ghi sự kiện được tạo ra trong quá trình một hệ điều hành, ứng dụng, dịch vụ hoặc thiết bị hoạt động. Mỗi bản ghi thường mô tả một việc đã xảy ra tại một thời điểm xác định, chẳng hạn dịch vụ được khởi động, yêu cầu đăng nhập thất bại, tiến trình gặp lỗi hoặc cấu hình bị thay đổi.
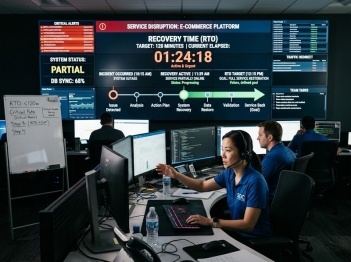
RTO phản ánh thời gian khôi phục dịch vụ như thế nào?
RTO là gì và phản ánh điều gì?
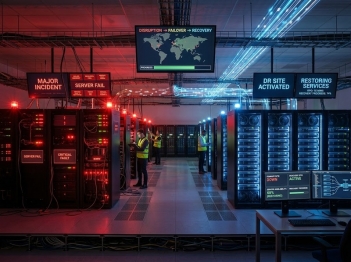
Disaster recovery khác khả năng chịu lỗi như thế nào?
Disaster recovery và fault tolerance đều nhằm giảm tác động của sự cố lên hệ thống, nhưng chúng giải quyết hai bài toán khác nhau. Fault tolerance tập trung vào việc hệ thống tiếp tục hoạt động khi lỗi xảy ra; disaster recovery tập trung vào việc khôi phục hệ thống và dữ liệu sau khi một sự cố nghiêm trọng đã làm gián đoạn dịch vụ.
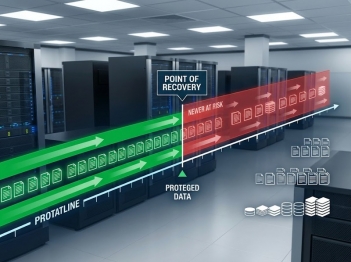
RPO phản ánh mức mất dữ liệu chấp nhận được thế nào?
RPO là viết tắt của Recovery Point Objective, tức mục tiêu điểm khôi phục dữ liệu. Nói đơn giản, RPO trả lời câu hỏi: nếu hệ thống gặp sự cố, dữ liệu được phục hồi có thể lùi về quá khứ tối đa bao lâu mà doanh nghiệp vẫn chấp nhận được?

