
Dữ liệu có cấu trúc và phi cấu trúc khác nhau thế nào?
Mục lục
- Dữ liệu có cấu trúc và phi cấu trúc là gì?
- Khác biệt cốt lõi nằm ở schema và cách tổ chức dữ liệu
- So sánh dữ liệu có cấu trúc và phi cấu trúc theo từng tiêu chí
- Ví dụ thực tế: một đối tượng có thể chứa cả hai loại dữ liệu
- Cách tổ chức dữ liệu ảnh hưởng thế nào đến lưu trữ và phân tích?
- Cách nhận biết dữ liệu có cấu trúc hay phi cấu trúc
Dữ liệu có cấu trúc và phi cấu trúc khác nhau chủ yếu ở việc có tuân theo một schema xác định trước hay không. Bài viết giải thích cách nhận biết hai loại dữ liệu, vì sao cách tổ chức ảnh hưởng đến truy vấn và phân tích, cùng những trường hợp dễ phân loại nhầm.
Điểm phân biệt quan trọng nhất không nằm ở việc dữ liệu là số, chữ hay tệp đa phương tiện, mà ở cách thông tin được tổ chức. Dữ liệu có cấu trúc tuân theo một schema xác định trước: các trường, kiểu dữ liệu và quan hệ được quy định đủ rõ để hệ thống biết mỗi giá trị nằm ở đâu và mang ý nghĩa gì. Dữ liệu phi cấu trúc không tuân theo một mô hình trường cố định như vậy; phần mang ý nghĩa thường nằm trong nội dung tự do như văn bản, hình ảnh, âm thanh hoặc video.
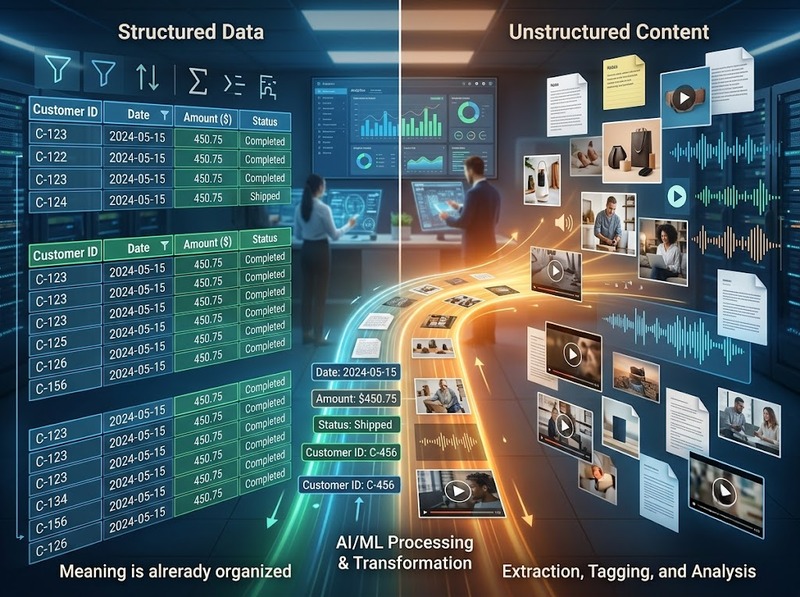
Khác biệt này dẫn đến cách xử lý khác nhau. Với dữ liệu có cấu trúc, hệ thống có thể lọc, sắp xếp, tính toán hoặc đối chiếu trực tiếp trên các trường đã biết. Với dữ liệu phi cấu trúc, muốn truy vấn theo ý nghĩa thường phải có thêm bước lập chỉ mục, trích xuất thuộc tính hoặc diễn giải nội dung. “Phi cấu trúc” vì thế không có nghĩa là dữ liệu hoàn toàn hỗn loạn; nó chỉ không được tổ chức theo một schema cố định phù hợp cho việc truy vấn trực tiếp theo trường.
Dữ liệu có cấu trúc và phi cấu trúc là gì?
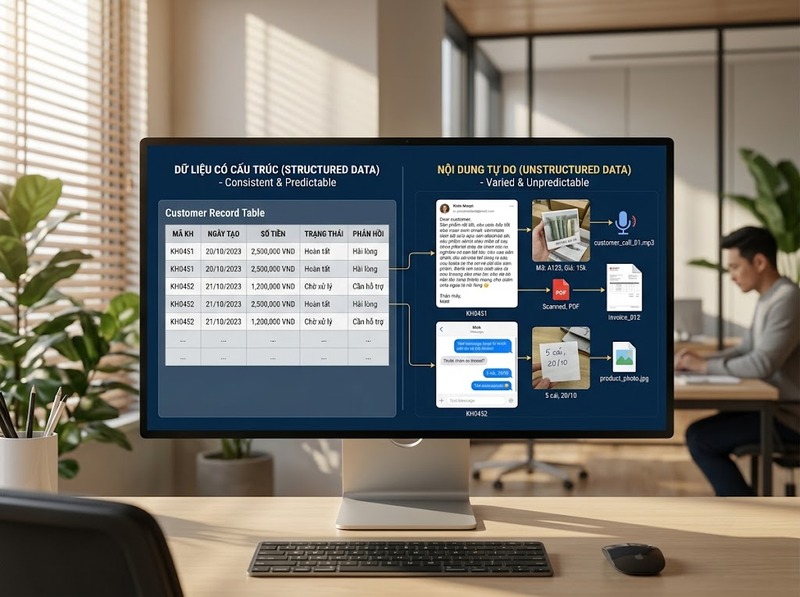
Dữ liệu có cấu trúc là dữ liệu được tổ chức theo một mô hình xác định trước. Mỗi bản ghi thường có các trường nhất quán, chẳng hạn mã khách hàng, ngày tạo, số tiền và trạng thái. Hệ thống có thể áp dụng kiểu dữ liệu, quy tắc bắt buộc, khóa hoặc quan hệ để giữ cho các bản ghi tuân theo cùng một cấu trúc. Bảng trong cơ sở dữ liệu quan hệ là ví dụ điển hình, nhưng một tệp dạng bảng cũng có thể là dữ liệu có cấu trúc nếu các cột thực sự đại diện cho những trường ổn định.
Dữ liệu phi cấu trúc là dữ liệu mà nội dung chính không tuân theo một tập trường cố định để mô tả đầy đủ ý nghĩa. Một đoạn phản hồi của khách hàng có thể dài một câu hoặc nhiều trang; một ảnh có thể chứa sản phẩm, con người hoặc văn bản; một bản ghi âm có thể chứa nhiều chủ đề khác nhau. Những nội dung đó vẫn có định dạng tệp và có thể kèm metadata, nhưng phần ý nghĩa không tự động xuất hiện thành các cột như “chủ đề”, “cảm xúc” hay “đối tượng xuất hiện”.
“Có cấu trúc” không đồng nghĩa với dữ liệu số, còn “phi cấu trúc” cũng không đồng nghĩa với dữ liệu chữ. Tên khách hàng là văn bản nhưng hoàn toàn có thể là một trường có cấu trúc. Ngược lại, một con số nằm trong ảnh chụp hóa đơn vẫn thuộc nội dung phi cấu trúc cho đến khi hệ thống nhận diện và đưa nó vào một trường xác định.
Khác biệt cốt lõi nằm ở schema và cách tổ chức dữ liệu
Schema mô tả những gì hệ thống kỳ vọng ở dữ liệu: có những trường nào, mỗi trường biểu diễn thuộc tính gì, kiểu dữ liệu ra sao và trong nhiều hệ thống còn có các ràng buộc hoặc quan hệ giữa các trường. Khi schema được xác định đủ rõ, một giá trị không chỉ tồn tại dưới dạng ký tự hoặc con số; nó có vị trí và ngữ nghĩa vận hành cụ thể.
Ví dụ, trong bảng đơn hàng có các cột order_id, customer_id, order_date và total_amount, hệ thống biết chính xác cột nào cần dùng để lọc đơn hàng theo ngày hoặc tính tổng doanh thu. Cấu trúc đó cho phép truy vấn trực tiếp vì thuộc tính đã được tách thành trường trước khi phân tích.
Một email khiếu nại lại khác. Cụm “giao chậm ba ngày” có thể xuất hiện ở bất kỳ vị trí nào trong phần nội dung, được diễn đạt bằng nhiều cách và thậm chí nằm trong tệp đính kèm. Hệ thống không thể giả định sẵn rằng ký tự thứ bao nhiêu hoặc đoạn thứ mấy chính là “số ngày giao chậm”. Muốn biến thông tin này thành thuộc tính để thống kê, cần một bước nhận diện hoặc trích xuất trước.
Cốt lõi là khác biệt giữa ý nghĩa đã được gắn với trường và ý nghĩa còn nằm trong nội dung. Cách nhìn này chính xác hơn việc phân loại dựa trên phần mở rộng tệp hay công nghệ lưu trữ, vì cùng một định dạng hoặc cùng một hệ thống có thể chứa các thành phần có mức cấu trúc khác nhau.
So sánh dữ liệu có cấu trúc và phi cấu trúc theo từng tiêu chí
|
Tiêu chí |
Dữ liệu có cấu trúc |
Dữ liệu phi cấu trúc |
|
Cách tổ chức |
Theo trường, bản ghi và schema xác định trước |
Nội dung không tuân theo tập trường cố định để biểu diễn đầy đủ ý nghĩa |
|
Tính nhất quán |
Các bản ghi thường có cùng nhóm thuộc tính và quy tắc |
Hình thức và nội dung có thể thay đổi mạnh giữa các mục dữ liệu |
|
Cách truy vấn |
Có thể lọc, nối, tổng hợp hoặc tính toán trực tiếp trên trường |
Thường cần tìm kiếm, lập chỉ mục hoặc trích xuất thông tin trước khi truy vấn theo thuộc tính |
|
Lưu trữ điển hình |
Cơ sở dữ liệu quan hệ, kho dữ liệu, bảng dữ liệu |
Hệ thống tệp, object storage, kho nội dung hoặc data lake |
|
Ví dụ |
Bảng khách hàng, giao dịch, tồn kho, lịch sử đơn hàng |
Tài liệu tự do, ảnh, âm thanh, video, nội dung cuộc trò chuyện |
|
Kiểm tra dữ liệu |
Có thể áp dụng kiểu dữ liệu và ràng buộc ngay trên trường |
Việc kiểm tra thường phụ thuộc loại nội dung và thông tin cần trích xuất |
|
Phân tích |
Nhiều phép tính và báo cáo có thể chạy trực tiếp trên trường |
Thường cần biến nội dung thành metadata, đặc trưng hoặc trường có thể phân tích |
Bảng trên mô tả xu hướng điển hình, không phải ranh giới tuyệt đối của mọi hệ thống. Một nền tảng hiện đại có thể lưu cả hai loại dữ liệu và cung cấp nhiều cách truy vấn khác nhau. Điều quyết định vẫn là mức độ mà thông tin cần phân tích đã được biểu diễn thành cấu trúc ổn định hay còn nằm trong nội dung tự do.
Ví dụ thực tế: một đối tượng có thể chứa cả hai loại dữ liệu
Một phiếu hỗ trợ khách hàng cho thấy hai loại dữ liệu có thể cùng tồn tại trong một đối tượng nghiệp vụ. Mã phiếu, mã khách hàng, thời điểm tạo, mức ưu tiên và trạng thái có thể được lưu thành các trường cố định. Đây là phần dữ liệu có cấu trúc vì hệ thống biết trước từng thuộc tính và có thể truy vấn trực tiếp, chẳng hạn tìm tất cả phiếu mức ưu tiên cao được tạo trong tuần này.
Phần mô tả vấn đề lại có thể là văn bản tự do. Khách hàng có thể viết “không đăng nhập được”, mô tả một chuỗi sự kiện dài hoặc đính kèm ảnh chụp màn hình. Nội dung này không có một tập trường cố định đủ để phản ánh toàn bộ ý nghĩa, nên được xử lý như dữ liệu phi cấu trúc. Nếu doanh nghiệp muốn thống kê “nguyên nhân đăng nhập thất bại”, hệ thống cần gán nhãn hoặc trích xuất chủ đề từ phần nội dung trước.
Một bức ảnh cũng có tính chất hỗn hợp tương tự. Tên tệp, thời gian tạo, kích thước ảnh hoặc một số metadata có thể được lưu theo trường; nhưng việc ảnh có chứa người, biển số hay sản phẩm nào lại nằm trong nội dung hình ảnh. Do đó, việc phân loại nên dựa trên thành phần dữ liệu và mục đích truy vấn, thay vì gắn nhãn cho toàn bộ tệp chỉ theo định dạng.
Cách tổ chức dữ liệu ảnh hưởng thế nào đến lưu trữ và phân tích?
Khi thuộc tính đã được tổ chức thành trường, hệ thống có thể xây dựng chỉ mục, kiểm tra kiểu dữ liệu và thực hiện phép lọc hoặc tổng hợp trên những vị trí đã biết. Các tác vụ như tính tổng doanh thu theo tháng, đếm số đơn theo trạng thái hoặc nối bảng khách hàng với bảng giao dịch vì thế có thể thực hiện trực tiếp. Đổi lại, hệ thống phải xác định và duy trì mô hình dữ liệu đủ ổn định; khi nghiệp vụ thay đổi, schema và các quy tắc liên quan có thể phải điều chỉnh.
Dữ liệu phi cấu trúc linh hoạt hơn ở chỗ có thể giữ nội dung gần với dạng gốc mà không ép mọi ý nghĩa vào các cột có sẵn. Một cuộc gọi hỗ trợ, hợp đồng dài hoặc video giám sát có thể chứa nhiều thông tin mà một schema đơn giản khó mô tả trước. Sự linh hoạt này chuyển phần việc sang giai đoạn khai thác: hệ thống phải xác định phần nào trong nội dung có giá trị, tạo chỉ mục hoặc trích xuất thành thuộc tính trước khi phân tích theo tiêu chí cụ thể.
Không loại dữ liệu nào tốt hơn trong mọi trường hợp. Dữ liệu có cấu trúc phù hợp khi các thuộc tính cần quản lý đã rõ và cần được truy vấn nhất quán. Dữ liệu phi cấu trúc phù hợp khi cần giữ nội dung phong phú hoặc biến đổi mà việc ép vào schema cố định có thể làm mất ngữ cảnh. Trong thực tế, nhiều quy trình giữ nội dung gốc rồi tạo thêm metadata hoặc trường có cấu trúc cho những thuộc tính cần tìm kiếm và báo cáo.
Cách nhận biết dữ liệu có cấu trúc hay phi cấu trúc
Ba câu hỏi sau giúp xác định cách dữ liệu đang được tổ chức:
1. Các thuộc tính quan trọng có được định nghĩa thành những trường ổn định hay không?
2. Cùng một thuộc tính có xuất hiện ở vị trí và kiểu dữ liệu có thể dự đoán giữa các bản ghi hay không?
3. Hệ thống có thể lọc hoặc tính toán trực tiếp trên thuộc tính đó mà không cần hiểu nội dung tự do trước hay không?
Nếu phần lớn câu trả lời là có, dữ liệu đang được tổ chức theo hướng có cấu trúc. Nếu ý nghĩa chủ yếu nằm trong văn bản tự do, hình ảnh, âm thanh hoặc video và phải được nhận diện trước khi trở thành thuộc tính có thể truy vấn, đó là dấu hiệu của dữ liệu phi cấu trúc.
Phần mở rộng tệp không quyết định dữ liệu thuộc loại nào. Một tệp CSV với các cột ổn định có thể chứa dữ liệu có cấu trúc; một tệp PDF có thể vừa có các trường metadata vừa chứa văn bản hoặc hình ảnh cần diễn giải. Phân loại đúng phải dựa vào cách thông tin được mô hình hóa và cách hệ thống truy cập ý nghĩa của nó.
Trường hợp ở giữa: dữ liệu bán cấu trúc
Không phải dữ liệu nào cũng rơi hoàn toàn vào một trong hai cực. Dữ liệu bán cấu trúc có các dấu hiệu tổ chức như khóa, thẻ hoặc metadata nhưng không nhất thiết tuân theo một schema cứng giống bảng quan hệ. JSON và XML thường được dùng làm ví dụ vì mỗi bản ghi có thể mang các thuộc tính khác nhau trong khi vẫn giữ những nhãn giúp máy nhận diện nội dung.
Dữ liệu bán cấu trúc cho thấy “có schema cố định” và “không có schema cố định” không phải lúc nào cũng tạo thành một ranh giới nhị phân tuyệt đối. Với trường hợp khó phân loại, mức độ ổn định của trường, quy tắc dữ liệu và khả năng truy vấn trực tiếp có giá trị hơn việc gắn nhãn chỉ dựa trên định dạng.
Dữ liệu có cấu trúc và phi cấu trúc khác nhau trước hết ở cách tổ chức thông tin. Loại có cấu trúc đưa các thuộc tính vào schema và trường xác định, nhờ đó có thể truy vấn trực tiếp và áp dụng các quy tắc nhất quán. Loại phi cấu trúc giữ phần lớn ý nghĩa trong nội dung tự do, nên thường cần thêm bước tìm kiếm, trích xuất hoặc diễn giải trước khi phân tích theo thuộc tính.
Khi cần phân biệt, hãy hỏi: “Ý nghĩa đã nằm trong trường hay vẫn nằm trong nội dung?” Câu hỏi này chính xác hơn việc dựa vào dữ liệu là số hay chữ hoặc nhìn vào phần mở rộng tệp. Nó cũng giải thích vì sao một đối tượng thực tế có thể đồng thời chứa dữ liệu có cấu trúc, phi cấu trúc và cả thành phần bán cấu trúc.

GỬI Ý KIẾN BÌNH LUẬN

