
Tiền xử lý dữ liệu gồm những bước cơ bản nào?
Mục lục
Tiền xử lý dữ liệu là quá trình biến dữ liệu thô thành dữ liệu sạch, nhất quán và phù hợp để phân tích hoặc xây dựng mô hình. Bài viết giải thích các bước cơ bản từ làm sạch, tích hợp, biến đổi đến chuẩn hóa dữ liệu
Dữ liệu thu thập từ nhiều nguồn thường chứa giá trị thiếu, bản ghi trùng, sai định dạng, nhiễu hoặc các biến có thang đo khác nhau. Tiền xử lý dữ liệu là quá trình xử lý những vấn đề đó trước khi đưa dữ liệu vào phân tích, trực quan hóa hoặc mô hình học máy.
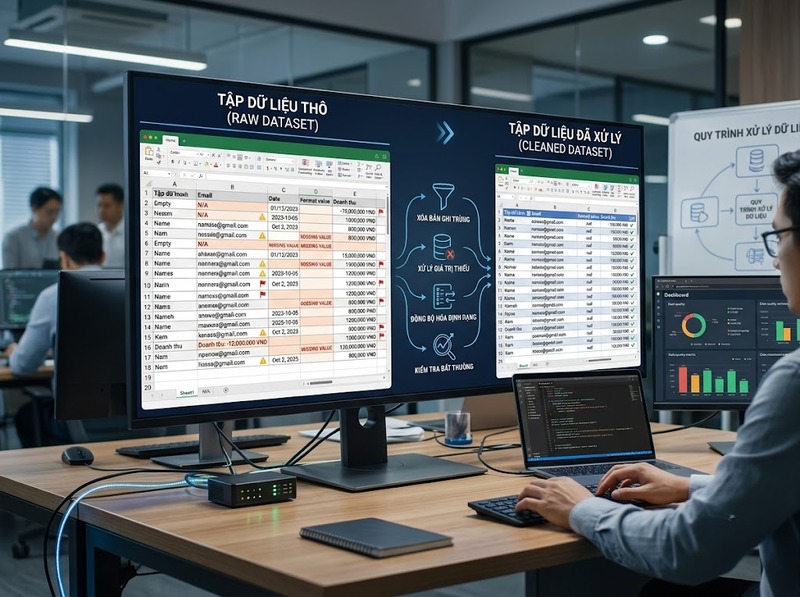
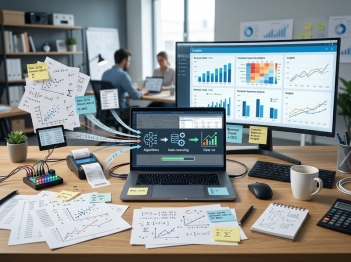
Về cơ bản, quy trình thường gồm làm sạch dữ liệu, tích hợp dữ liệu, biến đổi dữ liệu, chuẩn hóa hoặc chuẩn hóa theo thang đo phù hợp, mã hóa dữ liệu phân loại và chuẩn bị tập dữ liệu cho bước phân tích hoặc huấn luyện. Không phải mọi bài toán đều cần tất cả các bước; lựa chọn phụ thuộc vào đặc điểm dữ liệu và mục đích sử dụng.
Tiền xử lý dữ liệu là gì?
Tiền xử lý dữ liệu là tập hợp các thao tác biến dữ liệu thô thành dữ liệu có cấu trúc, nhất quán và phù hợp với nhiệm vụ tiếp theo. Mục tiêu không chỉ là “làm sạch” dữ liệu mà còn bảo đảm dữ liệu có thể được sử dụng đúng cách.
Ví dụ, một tập dữ liệu khách hàng có thể chứa tuổi bị bỏ trống, giới tính được ghi dưới nhiều dạng như Nam, M, Male, ngày tháng có nhiều định dạng và thu nhập được biểu diễn ở các đơn vị khác nhau. Nếu đưa trực tiếp dữ liệu này vào phân tích, kết quả có thể bị sai hoặc mô hình khó học được quy luật thực tế.
Do đó, tiền xử lý thường tập trung vào ba yêu cầu chính:
· Tính chính xác: Giảm lỗi, nhiễu và giá trị bất hợp lệ
· Tính nhất quán: Đưa các cách biểu diễn khác nhau về cùng một quy ước
· Tính phù hợp: Chuyển dữ liệu về dạng mà phương pháp phân tích hoặc mô hình có thể sử dụng
Điểm quan trọng là tiền xử lý không có một công thức cố định cho mọi tập dữ liệu. Một bước chỉ nên thực hiện khi đặc điểm dữ liệu và mục tiêu phân tích thực sự yêu cầu.
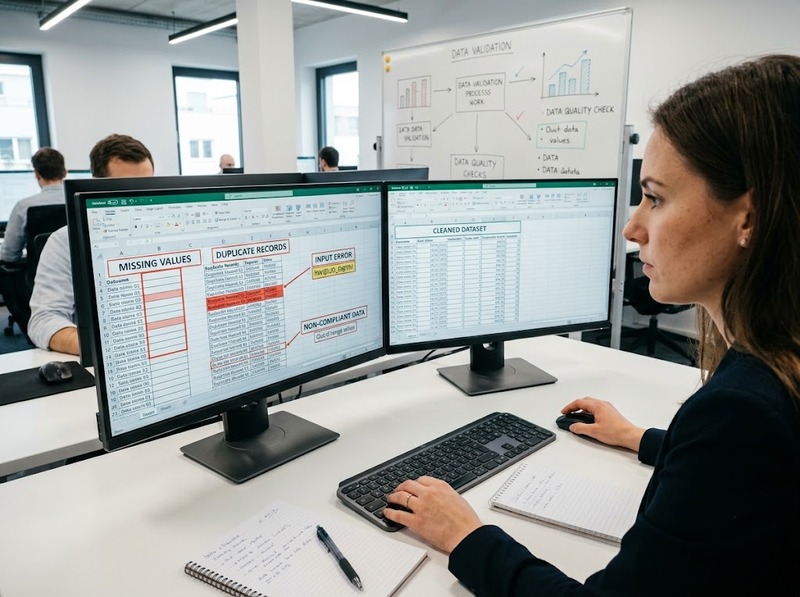
Các bước cơ bản trong tiền xử lý dữ liệu
Một quy trình tiền xử lý điển hình có thể được tổ chức theo trình tự từ kiểm tra dữ liệu đến biến đổi và chuẩn bị đầu vào.
1. Khám phá và kiểm tra dữ liệu
Trước khi thay đổi dữ liệu, cần xác định dữ liệu đang có vấn đề gì. Có thể kiểm tra số lượng bản ghi, kiểu dữ liệu, giá trị thiếu, giá trị bất thường, bản ghi trùng và phạm vi của từng biến.
Bước này giúp tránh xử lý theo phỏng đoán. Chẳng hạn, không nên tự động thay mọi giá trị thiếu bằng giá trị trung bình nếu chưa biết nguyên nhân thiếu dữ liệu và ý nghĩa của biến đó.
2. Làm sạch dữ liệu
Làm sạch dữ liệu xử lý các vấn đề như:
· Giá trị thiếu
· Bản ghi trùng lặp
· Giá trị không hợp lệ
· Lỗi nhập liệu
· Dữ liệu nhiễu hoặc ngoại lệ cần được xem xét
Với giá trị thiếu, tùy trường hợp có thể loại bỏ bản ghi, thay thế bằng một giá trị phù hợp hoặc giữ trạng thái thiếu để xử lý ở bước sau. Với dữ liệu trùng, cần xác định tiêu chí nào thực sự đại diện cho cùng một bản ghi trước khi loại bỏ.
3. Tích hợp dữ liệu
Khi dữ liệu đến từ nhiều bảng hoặc nhiều nguồn, cần đưa chúng về một cấu trúc thống nhất. Công việc có thể bao gồm ghép bảng, thống nhất tên trường, đơn vị đo và cách định danh đối tượng.
Đây là bước quan trọng vì hai nguồn có thể cùng mô tả một thuộc tính nhưng sử dụng cách biểu diễn khác nhau. Nếu không xử lý, việc kết hợp dữ liệu có thể tạo ra bản ghi sai hoặc làm mất thông tin.
4. Biến đổi dữ liệu
Biến đổi dữ liệu nhằm đưa dữ liệu về dạng phù hợp hơn với phương pháp phân tích hoặc mô hình. Các thao tác thường gặp gồm chuyển kiểu dữ liệu, biến đổi phân phối, tạo biến mới hoặc chuyển đổi cách biểu diễn một thuộc tính.
Ví dụ, một biến ngày tháng có thể được tách thành năm, tháng và ngày; một biến văn bản phân loại có thể được chuyển sang dạng số thông qua kỹ thuật mã hóa phù hợp.
5. Chuẩn hóa hoặc đưa dữ liệu về cùng thang đo
Các biến số có thể có phạm vi rất khác nhau. Chẳng hạn, tuổi có thể nằm trong khoảng vài chục trong khi thu nhập có thể lên tới hàng chục triệu. Một số thuật toán nhạy với sự khác biệt về thang đo có thể bị ảnh hưởng nếu dữ liệu không được xử lý phù hợp.
Hai cách thường gặp là Min-Max scaling, đưa giá trị về một khoảng xác định như 0 đến 1, và standardization, thường đưa biến về trung bình 0 và độ lệch chuẩn 1.
Không nên đồng nhất “chuẩn hóa dữ liệu” với một phép biến đổi duy nhất. Cách chọn phụ thuộc vào thuật toán, phân phối dữ liệu và mục tiêu xử lý.
6. Mã hóa dữ liệu phân loại
Nhiều thuật toán yêu cầu đầu vào dạng số trong khi dữ liệu thực tế có thể chứa các giá trị như Nam/Nữ, Đỏ/Xanh/Vàng hoặc tên nhóm sản phẩm.
Các giá trị này có thể được chuyển thành biểu diễn số bằng phương pháp phù hợp. Với biến phân loại không có thứ tự tự nhiên, one-hot encoding thường được sử dụng để tránh tạo ra quan hệ thứ bậc giả giữa các nhóm.
Chuẩn hóa dữ liệu có phải lúc nào cũng cần không?
Không. Đây là một trong những điểm dễ bị hiểu sai khi tiền xử lý dữ liệu.
Nếu thuật toán không nhạy với thang đo của biến, việc chuẩn hóa có thể không mang lại lợi ích đáng kể. Ngược lại, với các phương pháp dựa trên khoảng cách hoặc tối ưu bằng gradient, sự khác biệt lớn giữa thang đo các biến có thể ảnh hưởng đến quá trình học.
Ngoài ra, cần phân biệt standardization với normalization theo Min-Max. Standardization tập trung vào việc điều chỉnh trung bình và độ phân tán, trong khi Min-Max scaling đưa dữ liệu về một khoảng xác định. Hai cách này không mang cùng ý nghĩa và không nên sử dụng tùy tiện.
Thứ tự tiền xử lý dữ liệu nên được thực hiện như thế nào?
Một quy trình có thể đi theo hướng:
Kiểm tra dữ liệu → Làm sạch → Tích hợp → Biến đổi → Mã hóa → Chuẩn hóa/thay đổi thang đo → Chia dữ liệu cho các bước tiếp theo
Tuy nhiên, thứ tự cụ thể có thể thay đổi theo bài toán. Một nguyên tắc đặc biệt quan trọng trong học máy là không để thông tin từ tập kiểm tra hoặc tập đánh giá “rò rỉ” vào quá trình huấn luyện.
Chẳng hạn, nếu tính giá trị trung bình để chuẩn hóa toàn bộ dữ liệu trước khi chia tập, thông tin của tập kiểm tra đã được sử dụng để xây dựng phép biến đổi. Cách an toàn hơn là xác định các tham số cần thiết từ tập huấn luyện, sau đó áp dụng cùng phép biến đổi cho dữ liệu kiểm tra hoặc dữ liệu mới.
Tiền xử lý dữ liệu cần lưu ý những gì?
Tiền xử lý không đơn thuần là càng xử lý nhiều càng tốt. Một thao tác không phù hợp có thể làm mất thông tin hoặc tạo ra sai lệch mới.
Một số nguyên tắc cần chú ý:
· Không xóa dữ liệu thiếu một cách máy móc: Cần xem xét tỷ lệ thiếu và ý nghĩa của việc thiếu dữ liệu
· Không loại bỏ mọi ngoại lệ: Ngoại lệ có thể là lỗi nhưng cũng có thể phản ánh một trường hợp thực tế quan trọng
· Không chuẩn hóa mọi biến: Chỉ nên áp dụng khi phương pháp sử dụng dữ liệu cần hoặc hưởng lợi từ việc thay đổi thang đo
· Không mã hóa phân loại theo thứ tự giả: Không nên biến các nhóm không có thứ tự thành các con số khiến mô hình hiểu nhầm rằng chúng có quan hệ lớn nhỏ
· Không để rò rỉ dữ liệu: Các tham số được học từ dữ liệu phải được xác định đúng trên tập huấn luyện khi xây dựng mô hình
Vì vậy, chất lượng tiền xử lý nên được đánh giá dựa trên việc dữ liệu sau xử lý có chính xác, nhất quán, phù hợp với phương pháp và vẫn bảo toàn thông tin cần thiết hay không.
Tiền xử lý dữ liệu là cầu nối giữa dữ liệu thô và dữ liệu sẵn sàng cho phân tích hoặc mô hình hóa. Các bước cơ bản thường xoay quanh kiểm tra, làm sạch, tích hợp, biến đổi, mã hóa và điều chỉnh thang đo. Quan trọng nhất không phải áp dụng tất cả các bước, mà là lựa chọn đúng thao tác dựa trên đặc điểm dữ liệu, mục tiêu phân tích và yêu cầu của phương pháp sử dụng dữ liệu.

GỬI Ý KIẾN BÌNH LUẬN

