
Log hệ thống được dùng để theo dõi hoạt động thế nào?
Mục lục
- Log hệ thống ghi lại một sự kiện ra sao?
- Log biến sự kiện thành tín hiệu theo dõi như thế nào?
- Từ các dòng log rời rạc đến chuỗi hoạt động của hệ thống
- Những hoạt động nào có thể được nhận biết qua log?
- Vì sao một dòng log riêng lẻ thường chưa đủ để kết luận?
- Cách đọc log để biến sự kiện thành thông tin vận hành
Log hệ thống ghi lại các sự kiện do hệ điều hành, ứng dụng, dịch vụ và thiết bị phát sinh. Khi được thu thập theo thời gian và đặt trong đúng ngữ cảnh, các bản ghi này cho phép tái dựng chuỗi hoạt động, phát hiện bất thường và tìm nguyên nhân của sự cố công nghệ.
Log hệ thống, hay system log, là tập hợp các bản ghi sự kiện được tạo ra trong quá trình một hệ điều hành, ứng dụng, dịch vụ hoặc thiết bị hoạt động. Mỗi bản ghi thường mô tả một việc đã xảy ra tại một thời điểm xác định, chẳng hạn dịch vụ được khởi động, yêu cầu đăng nhập thất bại, tiến trình gặp lỗi hoặc cấu hình bị thay đổi.
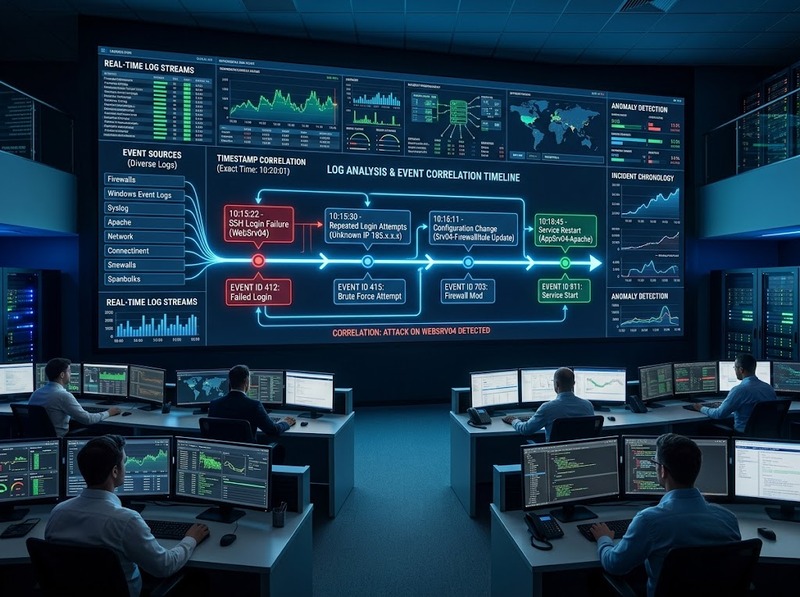
Giá trị của log không nằm ở một dòng thông báo riêng lẻ mà ở khả năng ghép nhiều sự kiện thành một trình tự. Khi biết sự kiện nào xảy ra, nguồn nào tạo ra nó, xảy ra lúc nào và trước hoặc sau sự kiện nào khác, người vận hành có thể theo dõi trạng thái của hệ thống và tái dựng diễn biến đã xảy ra. Vì vậy, log đặc biệt hữu ích khi cần trả lời các câu hỏi như “điều gì vừa xảy ra?”, “thành phần nào liên quan?” và “chuỗi hoạt động nào dẫn đến trạng thái hiện tại?”.
Log hệ thống ghi lại một sự kiện ra sao?
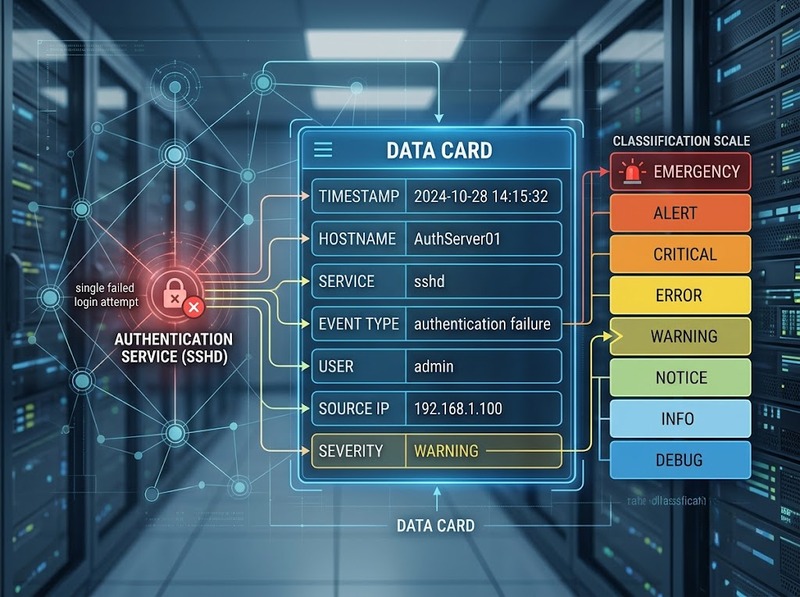
Một bản ghi log thường chứa nhiều trường thông tin thay vì chỉ có một câu thông báo. Tùy hệ thống, các trường có thể gồm thời gian, máy hoặc dịch vụ phát sinh sự kiện, loại sự kiện, mức severity, mã định danh, tài khoản liên quan, địa chỉ nguồn và phần mô tả chi tiết.
Ví dụ minh họa:
time=2026-08-27T14:32:10Z host=web-02 service=auth event=login_failed user=admin src=192.0.2.10 severity=warning
Từ bản ghi này có thể xác định thời điểm sự kiện, máy phát sinh, dịch vụ liên quan, hành động thất bại, tài khoản được sử dụng và địa chỉ nguồn. Tuy nhiên, chỉ riêng dòng log chưa chứng minh được nguyên nhân đăng nhập thất bại hay cho biết đó có phải hành vi tấn công hay không. Những kết luận như vậy cần thêm sự kiện trước và sau nó.
Cấu trúc log cũng không đồng nhất giữa mọi công nghệ. Một số hệ thống sử dụng thông điệp dạng văn bản, trong khi hệ thống khác ghi dữ liệu có cấu trúc thành các trường riêng. Syslog do IETF chuẩn hóa trong RFC 5424 là một ví dụ về cách truyền thông điệp sự kiện theo cấu trúc xác định.
RFC 5424 sử dụng tám mức severity, đánh số từ 0 đến 7: Emergency, Alert, Critical, Error, Warning, Notice, Informational và Debug. Mức này giúp hệ thống phân loại thông điệp, nhưng không nên được hiểu máy móc là mức ảnh hưởng thực tế của sự cố. Một sự kiện được ghi là Error có thể ít quan trọng trong một ngữ cảnh nhưng lại là mắt xích quan trọng khi xuất hiện cùng nhiều sự kiện khác.
Log biến sự kiện thành tín hiệu theo dõi như thế nào?
Hệ thống không “quan sát” hoạt động bằng log theo nghĩa liên tục đo mọi trạng thái. Log chỉ tồn tại khi một thành phần được lập trình hoặc cấu hình để phát sinh bản ghi tại một điểm nhất định trong quá trình hoạt động.
Chẳng hạn, một dịch vụ xác thực có thể tạo log khi nhận yêu cầu đăng nhập, khi xác thực thành công, khi mật khẩu sai hoặc khi tài khoản bị khóa. Khi các sự kiện đó được ghi theo thời gian, người vận hành có thể thấy một chuỗi như:
Yêu cầu đăng nhập → nhiều lần xác thực thất bại → đăng nhập thành công → thay đổi cấu hình.
Từng sự kiện riêng lẻ chỉ phản ánh một thời điểm. Khi đặt chúng cạnh nhau, trình tự lại cho thấy cách hoạt động phát triển theo thời gian. Đây là cơ chế quan trọng giúp log chuyển từ dữ liệu ghi chép thành nguồn thông tin để theo dõi hệ thống.
Cơ chế này cũng tạo ra một giới hạn quan trọng: một hoạt động không được ghi log sẽ gần như vô hình đối với phương pháp phân tích dựa trên log. Vì thế, “không tìm thấy log” không đồng nghĩa với “sự kiện chắc chắn không xảy ra”. Có thể thành phần đó không ghi nhận sự kiện, bản ghi bị mất trên đường truyền, dữ liệu đã bị xóa hoặc phạm vi thu thập không bao gồm nguồn cần kiểm tra.
Từ các dòng log rời rạc đến chuỗi hoạt động của hệ thống
Trong môi trường thực tế, bản ghi có thể được tạo đồng thời bởi hệ điều hành, ứng dụng, cơ sở dữ liệu, máy chủ web, thiết bị mạng và nhiều dịch vụ khác. Muốn theo dõi toàn bộ diễn biến, dữ liệu thường phải đi qua nhiều bước: phát sinh, truyền hoặc thu thập, lưu trữ, chuẩn hóa, tìm kiếm và phân tích.
NIST SP 800-92 mô tả quản lý log theo một vòng đời gồm các hoạt động như tạo dữ liệu, truyền, lưu trữ, phân tích và xử lý dữ liệu log. Cách nhìn theo vòng đời cho thấy việc “có log” mới chỉ là điểm bắt đầu; log phải đến được nơi phân tích với đủ thông tin cần thiết thì mới phát huy giá trị.
Việc chuẩn hóa giúp các bản ghi từ nhiều nguồn có thể được đọc theo những thuộc tính chung như thời gian, nguồn phát sinh, loại sự kiện và mức severity. Sau đó, công cụ phân tích có thể tìm các bản ghi liên quan và sắp chúng thành một timeline.
Thời gian đặc biệt quan trọng. Nếu đồng hồ giữa các máy lệch nhau, hai sự kiện có thể xuất hiện theo thứ tự sai dù trong thực tế chúng xảy ra ngược lại. Khi cần tái dựng nguyên nhân, sai lệch timestamp có thể khiến mối quan hệ giữa nguyên nhân và hệ quả bị hiểu sai.
Tương tự, việc chỉ lưu phần thông báo nhưng làm mất trường nguồn, mã sự kiện hoặc định danh phiên có thể khiến quá trình đối chiếu khó hơn đáng kể. Chất lượng theo dõi vì vậy phụ thuộc không chỉ vào số lượng log mà còn vào việc giữ đúng dữ liệu cần thiết để liên kết các sự kiện.
Những hoạt động nào có thể được nhận biết qua log?
Log đặc biệt phù hợp với các hoạt động có điểm bắt đầu, kết thúc hoặc thay đổi trạng thái rõ ràng. Chẳng hạn, log có thể cho biết một dịch vụ vừa khởi động lại, một tác vụ xử lý dữ liệu thất bại, một tài khoản vừa đăng nhập, một file cấu hình bị thay đổi hoặc một ứng dụng vừa trả về lỗi.
Đối với tình trạng vận hành, một chuỗi lỗi lặp lại trước khi dịch vụ ngừng hoạt động có thể giúp xác định thành phần gặp vấn đề. Nếu dịch vụ được khởi động lại ngay sau đó, các timestamp cho phép xây dựng timeline thay vì chỉ biết trạng thái cuối cùng.
Đối với hoạt động truy cập, nhiều lần đăng nhập thất bại từ cùng một nguồn có thể tạo ra tín hiệu đáng chú ý. Nhưng bản thân tần suất thất bại chưa đủ để xác định động cơ. Người phân tích còn phải xem tài khoản nào bị tác động, sau đó có đăng nhập thành công hay không và những hoạt động nào diễn ra tiếp theo.
Log cũng có thể ghi nhận thay đổi cấu hình hoặc trạng thái của tiến trình. Khi một lỗi xuất hiện ngay sau một thay đổi, mối quan hệ thời gian là dữ kiện quan trọng để điều tra. Tuy vậy, “xảy ra sau” chưa tự động có nghĩa là “do thay đổi đó gây ra”; cần thêm bằng chứng từ các bản ghi và trạng thái liên quan.
Không phải loại hoạt động công nghệ nào cũng nên được quan sát chủ yếu bằng log. Những đại lượng biến đổi liên tục như CPU, bộ nhớ, độ trễ hoặc lưu lượng thường được thể hiện hiệu quả hơn bằng metric. Trace phù hợp hơn khi cần theo dõi đường đi của một giao dịch qua nhiều dịch vụ. Log mạnh nhất khi cần biết một sự kiện cụ thể đã xảy ra và cần đọc ngữ cảnh chi tiết của sự kiện đó.
Vì sao một dòng log riêng lẻ thường chưa đủ để kết luận?
Log là bằng chứng về điều mà một thành phần đã ghi nhận, không phải bản sao hoàn chỉnh của mọi thứ đã xảy ra trong hệ thống. Thành phần tạo log quyết định sự kiện nào được ghi, dữ liệu nào được đưa vào và mức severity nào được gán.
Vì vậy, cùng một hiện tượng có thể xuất hiện rất khác nhau ở các nguồn. Ứng dụng có thể ghi lỗi kết nối, cơ sở dữ liệu ghi yêu cầu bị từ chối và hệ điều hành không ghi gì đáng chú ý. Nếu chỉ xem một nguồn, người phân tích có thể thấy hậu quả nhưng bỏ qua nguyên nhân.
Severity cũng cần được đọc cùng ngữ cảnh. Tám mức severity của syslog tạo ra một thang phân loại nhất quán cho thông điệp, nhưng chúng không phải thang đo tuyệt đối về thiệt hại kinh doanh hoặc mức độ ưu tiên xử lý. Một thông báo Debug có thể chứa chi tiết quan trọng cho việc tìm nguyên nhân, trong khi một Error lặp lại nhưng đã được ứng dụng xử lý tự động có thể không ảnh hưởng đến người dùng.
Một giới hạn khác là tính đầy đủ của dữ liệu. Log có thể bị xoay vòng, hết thời gian lưu trữ, thất lạc khi truyền hoặc bị giới hạn bởi cấu hình thu thập. Khi timeline xuất hiện khoảng trống, nên xem khoảng trống đó là thiếu bằng chứng chứ không phải bằng chứng rằng không có hoạt động.
Do đó, kết luận đáng tin cậy thường xuất hiện khi nhiều yếu tố cùng khớp: timestamp, nguồn phát sinh, định danh phiên hoặc yêu cầu, loại sự kiện và các bản ghi liên quan từ những thành phần khác.
Cách đọc log để biến sự kiện thành thông tin vận hành
Phân tích log hiệu quả bắt đầu bằng một câu hỏi cụ thể thay vì đọc toàn bộ dữ liệu từ đầu đến cuối. Nếu cần biết tại sao một dịch vụ ngừng hoạt động, trước hết nên xác định khoảng thời gian xảy ra vấn đề và nguồn log trực tiếp liên quan đến dịch vụ đó.
Tiếp theo, tìm sự kiện gần thời điểm thay đổi trạng thái nhất. Một lỗi xuất hiện sát thời điểm dịch vụ dừng là đầu mối, chưa phải kết luận. Từ đầu mối đó, mở rộng sang các bản ghi xảy ra trước và sau để tìm nguyên nhân tiềm năng, hành động khôi phục và các thành phần liên quan.
Khi nhiều hệ thống cùng tham gia một giao dịch, các định danh như request ID, session ID, process ID hoặc correlation ID có thể giúp nối những bản ghi thuộc cùng một luồng hoạt động. Nếu không có định danh chung, timestamp, tài khoản, địa chỉ nguồn và tên dịch vụ có thể được dùng để thu hẹp phạm vi đối chiếu.
Một trình tự đọc thực tế có thể đi theo logic:
1. Xác định câu hỏi cần trả lời và khoảng thời gian liên quan
2. Xác định nguồn tạo ra sự kiện chính
3. Đọc loại sự kiện, timestamp, severity và các trường định danh
4. Tìm các sự kiện xảy ra ngay trước và sau
5. Đối chiếu với log từ thành phần có quan hệ trực tiếp
6. Phân biệt dữ kiện đã được log xác nhận với suy luận chưa có bằng chứng
Cách làm này giúp tránh hai lỗi thường gặp: coi một thông báo lỗi là nguyên nhân cuối cùng và coi việc không có bản ghi là bằng chứng rằng hoạt động không xảy ra.
Log hệ thống vì thế không chỉ là nơi lưu các thông báo kỹ thuật. Khi dữ liệu được ghi đủ ngữ cảnh, thu thập đúng nguồn và sắp xếp theo thời gian, log trở thành dấu vết để tái dựng hoạt động của hệ thống. Giá trị lớn nhất của log nằm ở khả năng liên kết nhiều sự kiện thành một diễn biến có thể kiểm tra; còn độ tin cậy của kết luận phụ thuộc vào chất lượng bản ghi, mức độ đầy đủ của dữ liệu và cách đối chiếu giữa các nguồn.

GỬI Ý KIẾN BÌNH LUẬN

