
RPO phản ánh mức mất dữ liệu chấp nhận được thế nào?
Mục lục
- RPO là gì và vì sao nó đại diện cho mức mất dữ liệu chấp nhận được?
- Từ RPO có thể tính lượng dữ liệu tối đa có nguy cơ mất như thế nào?
- Tần suất backup hoặc replication liên quan đến RPO ra sao?
- RPO có phải lượng dữ liệu chắc chắn sẽ mất sau sự cố không?
- RPO càng thấp thì yêu cầu bảo vệ dữ liệu thay đổi thế nào?
- RPO khác RTO ở điểm nào khi đánh giá hậu quả của sự cố?
RPO xác định mức độ “cũ” tối đa của dữ liệu mà tổ chức chấp nhận khi phải khôi phục hệ thống sau sự cố. Hiểu đúng RPO giúp quy đổi một mục tiêu thời gian, chẳng hạn 15 phút, thành lượng giao dịch, bản ghi hoặc dung lượng dữ liệu có nguy cơ mất.
RPO là viết tắt của Recovery Point Objective, tức mục tiêu điểm khôi phục dữ liệu. Nói đơn giản, RPO trả lời câu hỏi: nếu hệ thống gặp sự cố, dữ liệu được phục hồi có thể lùi về quá khứ tối đa bao lâu mà doanh nghiệp vẫn chấp nhận được?
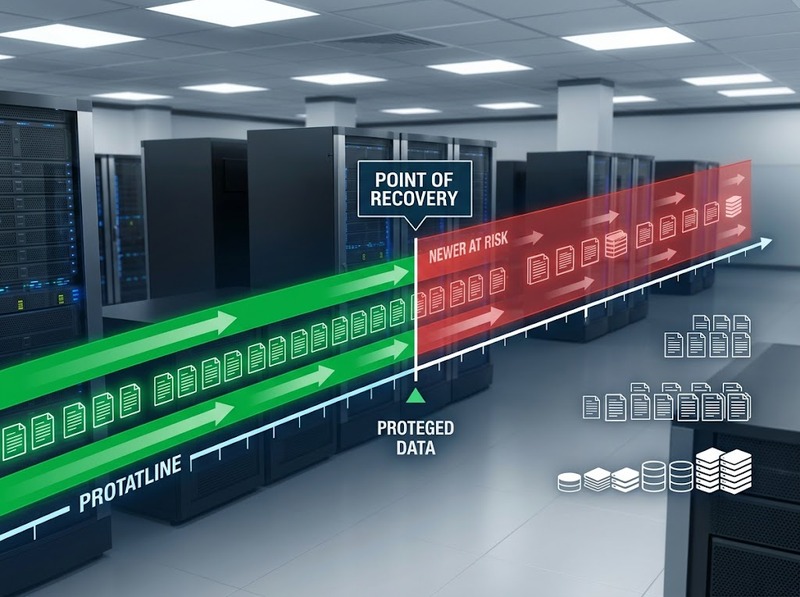
Vì vậy, RPO phản ánh mức mất dữ liệu chấp nhận được theo thời gian, không trực tiếp theo số GB, số bản ghi hay số giao dịch. Chẳng hạn, RPO 15 phút có nghĩa hệ thống cần có khả năng khôi phục về một điểm dữ liệu không cũ quá 15 phút so với thời điểm xảy ra sự cố. Lượng dữ liệu thực sự tương ứng với 15 phút đó phụ thuộc vào tốc độ dữ liệu phát sinh hoặc thay đổi.
RPO là gì và vì sao nó đại diện cho mức mất dữ liệu chấp nhận được?
Trong disaster recovery, RPO xác định điểm thời gian mà dữ liệu cần được khôi phục về sau một sự cố. NIST SP 800-34 Rev.1 cũng mô tả Recovery Point Objective theo logic này: đó là điểm thời gian mà dữ liệu phải được phục hồi về sau khi xảy ra gián đoạn.
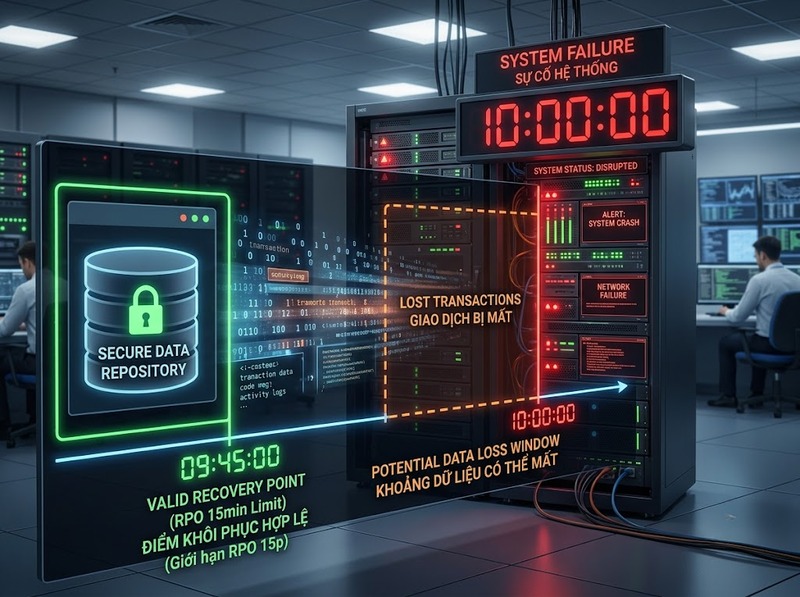
Giả sử hệ thống gặp sự cố lúc 10:00 và có RPO là 15 phút. Để đáp ứng RPO, điểm khôi phục hợp lệ gần nhất phải ở 9:45 hoặc muộn hơn. Trong trường hợp phải phục hồi đúng về mốc 9:45, các thay đổi phát sinh từ 9:45 đến 10:00 có thể không còn trong bản dữ liệu được khôi phục.
Do đó:
RPO 15 phút → tối đa 15 phút dữ liệu gần nhất có thể nằm trong vùng mất dữ liệu chấp nhận được theo thiết kế.
Tương tự, RPO 1 giờ cho phép điểm khôi phục lùi tối đa khoảng một giờ; RPO 24 giờ cho phép lùi tối đa khoảng một ngày.
Điểm quan trọng là RPO mô tả mức tổn thất dữ liệu mà hệ thống được thiết kế để không vượt quá, chứ không khẳng định rằng mỗi sự cố chắc chắn sẽ làm mất đúng lượng dữ liệu đó.
Từ RPO có thể tính lượng dữ liệu tối đa có nguy cơ mất như thế nào?
RPO được biểu diễn bằng thời gian. Muốn chuyển nó thành lượng dữ liệu cụ thể, cần biết tốc độ phát sinh hoặc thay đổi dữ liệu trong khoảng thời gian tương ứng.
Có thể ước tính:
Lượng dữ liệu có nguy cơ mất ≈ RPO × tốc độ thay đổi dữ liệu
Ví dụ, một hệ thống xử lý trung bình 200 giao dịch/phút và có RPO 15 phút. Nếu tải giao dịch phân bố tương đối đều:
200 × 15 = 3.000 giao dịch
Như vậy, 15 phút RPO có thể tương ứng với khoảng 3.000 giao dịch nằm trong vùng dữ liệu có nguy cơ không xuất hiện sau khi khôi phục.
Nếu một hệ thống tạo hoặc thay đổi khoảng 2 GB dữ liệu/giờ, RPO 15 phút tương ứng với:
2 GB/giờ × 0,25 giờ = 0,5 GB
Trong trường hợp này, RPO 15 phút có thể đại diện cho khoảng 0,5 GB dữ liệu thay đổi.
Đây chỉ là phép quy đổi. Với hệ thống có lưu lượng biến động mạnh, lấy tốc độ trung bình có thể đánh giá thấp hậu quả. Nếu mục tiêu là xác định giới hạn bảo vệ an toàn, tốc độ ghi hoặc giao dịch trong giai đoạn cao điểm thường có ý nghĩa hơn.
Tần suất backup hoặc replication liên quan đến RPO ra sao?
Muốn đáp ứng một RPO, hệ thống phải tạo được các điểm khôi phục thực sự sử dụng được với khoảng cách phù hợp.
Ví dụ, doanh nghiệp đặt RPO là 15 phút nhưng chỉ tạo một bản backup mỗi 24 giờ. Chỉ riêng cơ chế backup đó không thể bảo đảm mục tiêu 15 phút. Hệ thống cần thêm cơ chế có tần suất cao hơn, chẳng hạn snapshot, log shipping hoặc replication, để duy trì một điểm dữ liệu có thể khôi phục đủ gần thời điểm xảy ra sự cố.
Tuy nhiên, tần suất tạo bản sao bằng RPO chưa tự động có nghĩa RPO đã được đáp ứng. Cần phân biệt “đã chạy tác vụ sao lưu” với “đã có một recovery point hợp lệ”.
Chẳng hạn, snapshot được tạo mỗi 15 phút nhưng quá trình sao chép sang vùng bảo vệ bị chậm 20 phút. Nếu hệ thống nguồn và bản sao chưa hoàn tất cùng gặp vấn đề, điểm có thể phục hồi thực tế có thể cũ hơn mục tiêu 15 phút.
Vì vậy, khi đánh giá khả năng đáp ứng RPO cần nhìn vào tuổi của điểm khôi phục cuối cùng còn nguyên vẹn và phục hồi được, không chỉ nhìn vào lịch chạy backup.
RPO có phải lượng dữ liệu chắc chắn sẽ mất sau sự cố không?
Không. Đây là một trong những cách hiểu sai phổ biến nhất về RPO.
RPO là mục tiêu giới hạn, còn actual data loss là kết quả thực tế của từng sự cố. Nếu RPO là 15 phút và hệ thống gặp lỗi chỉ hai phút sau khi vừa tạo một recovery point hợp lệ, dữ liệu thực tế có nguy cơ mất có thể chỉ tương ứng với hai phút.
Ngược lại, dữ liệu thực tế cũng có thể mất nhiều hơn RPO nếu cơ chế bảo vệ không hoạt động như thiết kế. Một bản backup thất bại, replication bị lag, recovery point bị hỏng hoặc bản sao không thể phục hồi đều có thể khiến điểm dữ liệu khả dụng cuối cùng cũ hơn mức RPO yêu cầu.
Khi đó, không phải định nghĩa RPO thay đổi; hệ thống đã vi phạm mục tiêu RPO.
Có thể phân biệt như sau:
· RPO là mức mất dữ liệu tối đa được chấp nhận theo mục tiêu thiết kế
· Actual data loss là dữ liệu thực sự mất trong một sự cố cụ thể
· RPO breach xảy ra khi điểm khôi phục thực tế cũ hơn giới hạn RPO đã đặt
Ranh giới này đặc biệt quan trọng khi đánh giá một hệ thống disaster recovery: RPO thấp trên tài liệu không có nhiều giá trị nếu kiến trúc bảo vệ dữ liệu không tạo được recovery point tương ứng.
RPO càng thấp thì yêu cầu bảo vệ dữ liệu thay đổi thế nào?
RPO càng thấp, khoảng thời gian dữ liệu được phép mất càng nhỏ. Điều đó thường đòi hỏi quá trình bảo vệ dữ liệu diễn ra thường xuyên hoặc liên tục hơn.
Một RPO 24 giờ có thể phù hợp với dữ liệu mà việc mất các thay đổi trong một ngày vẫn nằm trong ngưỡng chấp nhận. RPO 1 giờ yêu cầu điểm khôi phục gần hơn đáng kể. RPO 15 phút thu hẹp thêm cửa sổ mất dữ liệu, còn RPO gần bằng 0 thể hiện yêu cầu hầu như không chấp nhận mất dữ liệu và thường cần cơ chế replication liên tục hoặc đồng bộ phù hợp.
RPO thấp hơn không mặc nhiên tốt hơn. Nó thường đi kèm yêu cầu cao hơn về hạ tầng, băng thông, lưu trữ, replication, kiểm soát tính nhất quán và khả năng kiểm chứng recovery point.
Do đó, giá trị RPO nên xuất phát từ lượng dữ liệu mà hoạt động kinh doanh thực sự có thể chịu mất.
Ví dụ, nếu một quy trình có thể chấp nhận mất tối đa khoảng 3.000 giao dịch và lưu lượng cao điểm là 200 giao dịch/phút, phép tính đơn giản cho thấy cửa sổ mất dữ liệu không nên vượt:
3.000 / 200 = 15 phút
RPO 15 phút khi đó có ý nghĩa nghiệp vụ cụ thể hơn nhiều so với việc chọn 15 phút chỉ vì đây là một con số kỹ thuật thuận tiện.
RPO khác RTO ở điểm nào khi đánh giá hậu quả của sự cố?
RPO và RTO đều được dùng trong phục hồi sau sự cố nhưng kiểm soát hai loại hậu quả khác nhau.
RPO kiểm soát độ lùi của dữ liệu. Nó trả lời dữ liệu có thể phải quay lại quá khứ bao xa.
RTO — Recovery Time Objective — kiểm soát thời gian gián đoạn. Nó trả lời hệ thống cần được đưa trở lại hoạt động trong bao lâu.
Ví dụ, hệ thống dừng lúc 10:00, được khôi phục hoạt động lúc 12:00 và có RPO 15 phút. Hai giờ từ 10:00 đến 12:00 liên quan đến thời gian phục hồi; còn RPO yêu cầu dữ liệu được đưa trở lại phải có điểm khôi phục khoảng 9:45 hoặc mới hơn.
Một hệ thống vì thế có thể phục hồi khá chậm nhưng mất rất ít dữ liệu, hoặc hoạt động trở lại nhanh nhưng phải khôi phục từ một bản dữ liệu tương đối cũ. RPO không đo downtime và RTO không cho biết bao nhiêu dữ liệu có thể mất.
RPO nên được hiểu là giới hạn về độ cũ của dữ liệu được chấp nhận sau khi khôi phục, được biểu diễn bằng thời gian. RPO 15 phút nghĩa là kiến trúc phục hồi phải hướng tới một recovery point không cũ quá 15 phút so với thời điểm sự cố; nếu đáp ứng đúng mục tiêu, tối đa khoảng 15 phút thay đổi dữ liệu nằm trong vùng có thể mất.
Muốn biết con số đó tương đương bao nhiêu dữ liệu, cần kết hợp RPO với tốc độ phát sinh dữ liệu: số giao dịch/phút, số bản ghi/giờ hoặc GB dữ liệu thay đổi. Và quan trọng nhất, RPO là mục tiêu thiết kế chứ không phải bảo đảm về tổn thất thực tế: nếu recovery point cuối cùng cũ hơn RPO, hệ thống đã không đạt mục tiêu bảo vệ dữ liệu đã đặt ra.

GỬI Ý KIẾN BÌNH LUẬN

