
High availability được xây dựng theo những nguyên tắc nào?
Mục lục
- High availability là gì và được đo như thế nào?
- Redundancy phải loại bỏ single point of failure
- Failure domain phải được tách để giới hạn blast radius
- Health check và failover phải tự động nhưng có kiểm soát
- Replication phải bảo toàn trạng thái, không chỉ nhân bản máy chủ
- Capacity và load balancing phải chịu được lúc mất node
- Observability và kiểm thử biến thiết kế HA thành khả năng thực
High availability là khả năng duy trì dịch vụ trong giới hạn gián đoạn đã đặt ra. Bài viết giải thích cách đo và 6 nguyên tắc giúp hệ thống duy trì tính sẵn sàng khi có sự cố.
High availability (HA) là khả năng một hệ thống hoặc dịch vụ tiếp tục phục vụ người dùng trong phạm vi gián đoạn đã được chấp nhận, kể cả khi một phần hạ tầng gặp lỗi, được bảo trì hoặc phải thay thế. Vì vậy, HA không đồng nghĩa với “hệ thống không bao giờ hỏng”. Điều cần đạt được là lỗi cục bộ không dễ biến thành gián đoạn toàn bộ dịch vụ.
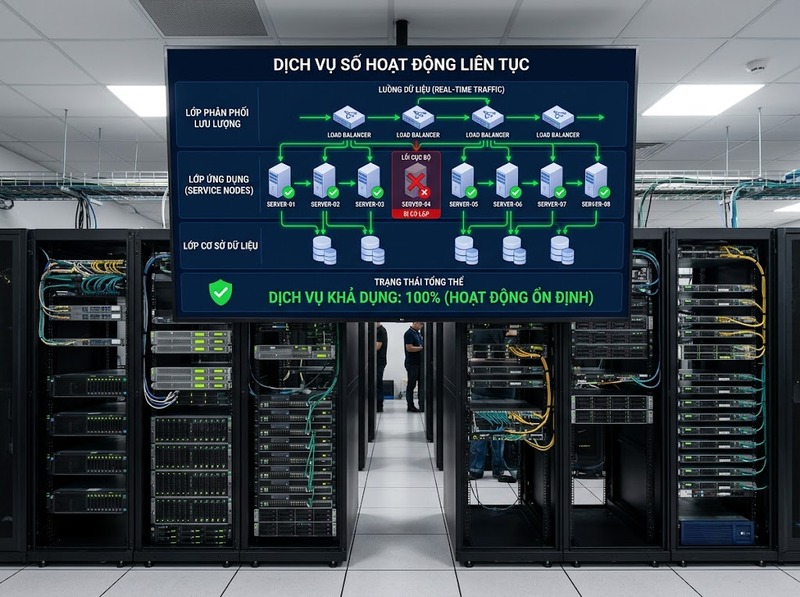
Một kiến trúc HA thường được hình thành từ nhiều lớp bảo vệ: loại bỏ điểm lỗi đơn bằng redundancy, cô lập failure domain, phát hiện lỗi và chuyển đổi tự động, bảo toàn trạng thái bằng replication, duy trì đủ capacity khi mất thành phần và liên tục kiểm chứng khả năng phục hồi. Chỉ nhân đôi máy chủ chưa đủ; toàn bộ chuỗi phụ thuộc phải được xem xét như một hệ thống.
High availability là gì và được đo như thế nào?
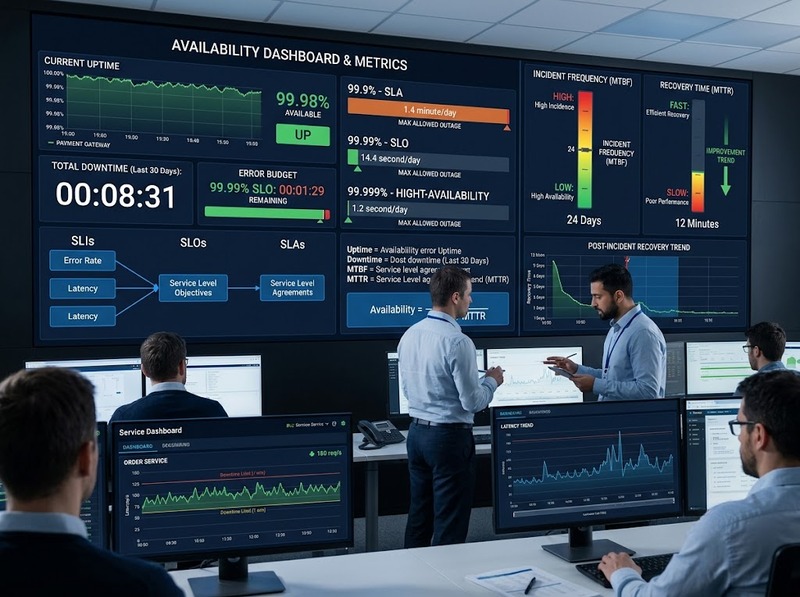
Ở mô hình đơn giản dựa trên thời gian, availability có thể được biểu diễn bằng:
Availability = Uptime / (Uptime Downtime) × 100%
Tỷ lệ này chỉ có ý nghĩa khi đi kèm một khoảng đo và quy tắc xác định thế nào là “dịch vụ khả dụng”. Với một năm 365 ngày, các mức availability tương ứng với ngân sách downtime lý thuyết như sau:
|
Availability |
Downtime tối đa xấp xỉ mỗi năm |
|
99,9% |
8 giờ 45 phút 36 giây |
|
99,99% |
52 phút 34 giây |
|
99,999% |
5 phút 15 giây |
Bảng trên minh họa vì sao thêm một số 9 làm yêu cầu kiến trúc khắt khe hơn rất nhanh. Từ 99,9% lên 99,99%, ngân sách gián đoạn giảm từ gần 9 giờ xuống chưa đầy một giờ mỗi năm.
Trong hệ thống thực tế, availability không nhất thiết chỉ đo bằng thời gian. Một dịch vụ web chẳng hạn có thể dùng tỷ lệ request thành công làm Service Level Indicator (SLI), sau đó đặt Service Level Objective (SLO) cho SLI đó. Thời gian bảo trì có được tính vào downtime hay không cũng phải được quy định trước; nếu thay đổi cách tính, cùng một hệ thống có thể cho ra con số availability khác nhau.
Với hệ thống có thể sửa chữa, một mô hình đơn giản khác cho thấy availability phụ thuộc vào cả tần suất lỗi và thời gian phục hồi:
A ≈ MTBF / (MTBF MTTR)
Điều đó giải thích hai hướng cơ bản để tăng tính sẵn sàng: làm cho lỗi xảy ra ít hơn và giảm thời gian cần để khôi phục dịch vụ khi lỗi đã xảy ra.
HA cũng cần được phân biệt với hai khái niệm gần nó. Fault tolerance thường đặt yêu cầu cao hơn về việc tiếp tục hoạt động mà người dùng gần như không nhận thấy quá trình chuyển đổi. Disaster recovery tập trung vào khả năng phục hồi sau sự cố lớn hơn và có thể chấp nhận khoảng gián đoạn dài hơn. HA nằm ở bài toán duy trì dịch vụ thường xuyên trước các lỗi có thể dự kiến trong quá trình vận hành.
Redundancy phải loại bỏ single point of failure
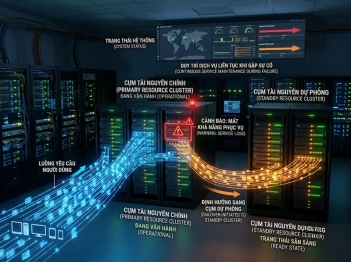
Nguyên tắc đầu tiên của high availability là không để một thành phần duy nhất có quyền quyết định toàn bộ dịch vụ còn hoạt động hay không. Thành phần như vậy được gọi là single point of failure (SPOF).
Nếu một ứng dụng có ba application server nhưng tất cả đều phụ thuộc vào một database duy nhất, database đó vẫn là SPOF. Tương tự, nhiều máy chủ phía sau một load balancer duy nhất cũng chưa tạo thành kiến trúc HA nếu load balancer có thể ngừng hoạt động mà không có đường thay thế.
Redundancy vì thế phải được xem xét xuyên suốt chuỗi phụ thuộc: compute, network path, load balancer, storage, database, hệ thống định danh, DNS hoặc các dịch vụ nền tảng khác có vai trò thiết yếu. Có thể sử dụng active-active, nơi nhiều instance cùng phục vụ traffic, hoặc active-passive, nơi một thành phần dự phòng tiếp quản khi thành phần chính lỗi. Hai mô hình tạo ra trade-off khác nhau về chi phí, độ phức tạp và thời gian failover.
Một phép tính đơn giản cho thấy vì sao phải đánh giá availability theo toàn dịch vụ. Nếu một request bắt buộc đi qua năm thành phần độc lập và mỗi thành phần có availability 99,9%, mô hình lý tưởng cho availability của toàn chuỗi là:
0,999⁵ ≈ 99,501%
Ngược lại, nếu hai thành phần 99,9% có thể thay thế hoàn toàn cho nhau, độc lập về nguyên nhân lỗi và cơ chế failover hoạt động hoàn hảo, availability lý thuyết của cặp có thể đạt:
1 − (1 − 0,999)² = 99,9999%
Trong thực tế, mức cải thiện thường thấp hơn vì hai bản sao có thể dùng chung nguồn điện, network, storage, cấu hình hoặc control plane. Redundancy chỉ có giá trị khi bản sao dự phòng không cùng thất bại bởi một nguyên nhân chung.
Failure domain phải được tách để giới hạn blast radius
Nhân bản tài nguyên vẫn chưa đủ nếu mọi bản sao nằm trong cùng một failure domain. Failure domain là phạm vi mà một lỗi có khả năng làm hỏng đồng thời nhiều thành phần, chẳng hạn một process, host, rack, network segment hoặc availability zone.
Thiết kế HA cần đặt các replica vào những failure domain phù hợp với loại sự cố muốn chịu được. Hai instance trên cùng một host giúp chống lỗi process nhưng không giúp khi host tắt. Hai host dùng chung một network path vẫn có thể mất kết nối cùng lúc. Vì vậy, mức độ phân tách phải tương ứng với failure mode mà hệ thống cần xử lý.
Ở tầng phần mềm, cùng nguyên tắc này xuất hiện dưới các mô hình như bulkhead, cell hoặc shard. Thay vì để một dependency chậm chiếm toàn bộ thread, connection hoặc request capacity, tài nguyên được chia thành các vùng giới hạn. Circuit breaker và rate limit cũng có thể ngăn một dependency đang lỗi kéo theo hàng loạt dịch vụ phía sau.
Isolation còn tạo điều kiện cho graceful degradation. Khi một chức năng không thiết yếu gặp sự cố, hệ thống có thể tạm dừng chức năng đó nhưng tiếp tục cung cấp luồng nghiệp vụ cốt lõi. Kết quả tốt hơn so với việc để một dependency phụ khiến toàn bộ dịch vụ trả lỗi.
Tách failure domain càng mạnh lại càng tốn tài nguyên và làm quản trị trạng thái phức tạp hơn. Mục tiêu vì thế không phải phân tách mọi thứ tối đa, mà là kiểm soát blast radius ở mức phù hợp với SLO và các failure mode thực tế.
Health check và failover phải tự động nhưng có kiểm soát
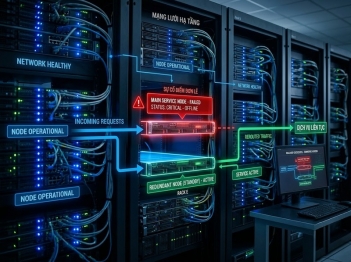
Redundancy chỉ giúp ích khi hệ thống biết bản sao nào đang gặp lỗi và có thể đưa traffic sang thành phần còn khỏe. Chuỗi này gồm ít nhất ba bước: phát hiện lỗi, quyết định failover và chuyển traffic.
Health check phải kiểm tra khả năng thực sự cần để instance phục vụ request, không chỉ kiểm tra process còn chạy. Một service có thể trả HTTP từ health endpoint nhưng không truy cập được database; nếu vẫn được đánh dấu healthy, load balancer sẽ tiếp tục gửi traffic vào một instance không thể hoàn thành công việc.
Ngưỡng phát hiện cũng cần cân bằng. Failover quá chậm làm tăng downtime. Ngược lại, chỉ một lần timeout đã loại node khỏi cluster có thể tạo false positive, khiến hệ thống liên tục chuyển trạng thái hoặc làm quá tải các node còn lại. Thực tế thường cần nhiều lần kiểm tra, timeout hợp lý và cơ chế chống flapping.
Với hệ thống có state, failover còn khó hơn chuyển địa chỉ traffic. Thành phần dự phòng phải có dữ liệu đủ mới, capacity đủ lớn và quyền đảm nhận vai trò chính. Nếu hai node đồng thời tin rằng mình là leader, hệ thống có thể rơi vào trạng thái split-brain. Leader election, quorum, lease hoặc fencing được dùng để bảo đảm chỉ thực thể hợp lệ được phép thực hiện các thao tác cần tính duy nhất, chẳng hạn ghi dữ liệu.
Một failover path chưa từng được sử dụng không nên được xem là bằng chứng rằng HA đã hoạt động. DNS, connection pool, credential, cache, routing rule hoặc capacity của standby đều có thể khiến quá trình chuyển đổi thất bại dù kiến trúc trên sơ đồ trông hợp lý.
Replication phải bảo toàn trạng thái, không chỉ nhân bản máy chủ
Application stateless tương đối dễ thay thế vì request mới có thể được chuyển sang instance khác. Với database, queue, session store hoặc hệ thống lưu trạng thái, khả năng tiếp tục phục vụ phụ thuộc vào việc replica có dữ liệu phù hợp tại thời điểm failover hay không.
Synchronous replication yêu cầu dữ liệu được xác nhận ở nhiều replica trước khi thao tác hoàn tất. Cách này có thể giảm nguy cơ mất những thay đổi vừa ghi khi node chính lỗi, nhưng latency tăng và write availability có thể giảm nếu số replica cần thiết không liên lạc được.
Asynchronous replication cho phép node chính xác nhận trước khi replica nhận đầy đủ dữ liệu. Đổi lại, khi failover diễn ra quá sớm, một phần cập nhật gần nhất có thể chưa xuất hiện trên replica mới. Kiến trúc phải quyết định rõ trade-off giữa availability, latency, consistency và lượng dữ liệu có thể chấp nhận mất trong một tình huống phục hồi.
Với hệ thống dùng quorum, một phân vùng mạng còn tạo ra lựa chọn khó hơn. Cho phép mọi phía tiếp tục ghi có thể gây xung đột hoặc tạo nhiều nguồn dữ liệu khác nhau. Từ chối một số thao tác để bảo vệ consistency lại làm giảm availability trong khoảng thời gian đó. Vì vậy, “có nhiều bản sao” không tự động giải quyết bài toán state.
Backup cũng không thay thế replication trong HA. Backup giúp khôi phục dữ liệu, nhưng quá trình restore thường không đủ nhanh để duy trì dịch vụ gần như liên tục. Ngược lại, replication có thể sao chép cả thao tác xóa nhầm hoặc dữ liệu lỗi sang replica. Hai cơ chế giải quyết hai failure mode khác nhau và không nên bị xem là một.
Capacity và load balancing phải chịu được lúc mất node
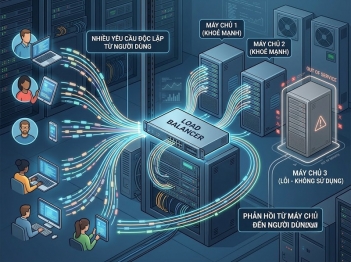
Một cluster có nhiều node nhưng chỉ đủ capacity khi tất cả đều khỏe vẫn có thể sập sau một lỗi nhỏ. Khi một node biến mất, traffic được dồn sang phần còn lại; nếu các node này đã gần giới hạn, chúng có thể trở nên chậm, timeout và lần lượt bị health check loại bỏ.
Capacity của hệ thống HA vì thế phải được tính cho trạng thái suy giảm, không chỉ trạng thái bình thường. Giả sử ba node đều xử lý tối đa 100 đơn vị tải. Với workload 180, khi mất một node, hai node còn lại vẫn có tổng capacity 200. Nếu workload bình thường đã là 250, cùng một sự cố khiến phần còn lại phải nhận tải vượt khả năng ngay lập tức.
Đây là lý do các mô hình như N 1 hoặc lượng headroom xác định trước thường quan trọng hơn việc nhìn vào mức sử dụng trung bình. Autoscaling có thể bổ sung tài nguyên, nhưng không nên được giả định là tức thời: instance cần thời gian khởi động, load balancer cần cập nhật target và dependency phía sau cũng phải chịu được lượng traffic mới.
Load balancing phải phân phối traffic dựa trên trạng thái của backend và bản thân lớp cân bằng tải cũng không được trở thành SPOF. Với ứng dụng sử dụng session affinity, failover còn phải tính đến vị trí lưu session. Nếu session chỉ tồn tại trên một instance, chuyển request sang node khác có thể khiến người dùng mất trạng thái dù service về mặt kỹ thuật vẫn đang chạy.
Khi capacity không đủ để giữ mọi chức năng, load shedding hoặc ưu tiên request quan trọng có thể bảo vệ phần dịch vụ cốt lõi. Đây là một dạng graceful degradation: chấp nhận giảm một phần chức năng để tránh sự cố phát triển thành outage toàn hệ thống.
Observability và kiểm thử biến thiết kế HA thành khả năng thực
High availability không thể được xác nhận chỉ bằng sơ đồ kiến trúc. Hệ thống phải chứng minh rằng các cơ chế dự phòng hoạt động đúng trong môi trường vận hành.
Trong cách tiếp cận SRE, một phương pháp hữu ích là biến mục tiêu “luôn sẵn sàng” thành SLI, SLO và error budget có thể đo được. Các chỉ số như tỷ lệ request thành công, latency, saturation, replication lag, số lần failover thất bại hoặc thời gian phục hồi giúp nhận biết liệu hệ thống có đang tiêu thụ ngân sách lỗi nhanh hơn dự kiến hay không.
Observability cũng cần bao phủ dependency chứ không chỉ application chính. Một service có CPU bình thường vẫn có thể không phục vụ được vì certificate hết hạn, DNS lỗi, connection pool cạn, database lag hoặc upstream trả lỗi. Việc nhìn xuyên suốt request path giúp tìm ra failure mode mà monitoring từng máy chủ riêng lẻ không phát hiện.
Kiểm thử HA cần đi xa hơn việc xác nhận replica tồn tại. Failover drill, fault injection có kiểm soát và các bài thử mất node hoặc mất dependency giúp kiểm tra cả đường chuyển đổi. Điều quan trọng là quan sát xem traffic có thực sự được chuyển, state có hợp lệ và phần capacity còn lại có giữ được SLO hay không.
Deployment và maintenance cũng phải tôn trọng cùng các nguyên tắc. Rolling deployment chỉ an toàn khi số instance bị rút khỏi traffic không làm capacity giảm dưới mức cần thiết. Một thay đổi cấu hình được phát đồng thời tới mọi replica có thể tạo common-mode failure dù phần cứng được phân tán hoàn hảo.
Do đó, HA là một thuộc tính phải được duy trì liên tục. Mỗi thay đổi về dependency, traffic, topology hoặc state model có thể làm giả định ban đầu không còn đúng. Kiến trúc chỉ đáng tin khi failure mode được quan sát, cơ chế phục hồi được thử nghiệm và availability thực tế được đối chiếu với mục tiêu đã đặt.
High availability được xây dựng bằng cách kiểm soát toàn bộ đường đi từ lỗi cục bộ đến ảnh hưởng mà người dùng nhìn thấy. Redundancy loại bỏ điểm lỗi đơn; failure isolation giới hạn phạm vi sự cố; health check và failover rút ngắn thời gian gián đoạn; replication bảo vệ state; capacity cùng load balancing giúp phần còn lại chịu được tải; còn observability và kiểm thử xác nhận các cơ chế đó thực sự hoạt động.
Vì vậy, không có một thành phần riêng lẻ nào có thể “bật” high availability cho hệ thống. Mức HA đạt được phụ thuộc vào mục tiêu availability đã xác định, các failure mode được thiết kế để chịu đựng và khả năng chứng minh rằng hệ thống vẫn đáp ứng mục tiêu đó khi một phần kiến trúc gặp lỗi.

GỬI Ý KIẾN BÌNH LUẬN

