
Disaster recovery khác khả năng chịu lỗi như thế nào?
Mục lục
- Khả năng phục hồi sau sự cố (disaster recovery) là gì?
- Fault tolerance là gì và cơ chế hoạt động ra sao?
- Disaster recovery khác fault tolerance ở điểm nào?
- Vì sao fault tolerance không thể thay thế disaster recovery?
- Khi nào nên dùng disaster recovery, fault tolerance hoặc kết hợp cả hai?
- Những hiểu lầm thường gặp về disaster recovery và khả năng chịu lỗi
Hiểu rõ disaster recovery là gì, cách phục hồi hệ thống sau sự cố và điểm khác biệt cốt lõi với fault tolerance về mục tiêu, cơ chế, thời gian gián đoạn và khả năng khôi phục dữ liệu
Disaster recovery và fault tolerance đều nhằm giảm tác động của sự cố lên hệ thống, nhưng chúng giải quyết hai bài toán khác nhau. Fault tolerance tập trung vào việc hệ thống tiếp tục hoạt động khi lỗi xảy ra; disaster recovery tập trung vào việc khôi phục hệ thống và dữ liệu sau khi một sự cố nghiêm trọng đã làm gián đoạn dịch vụ.
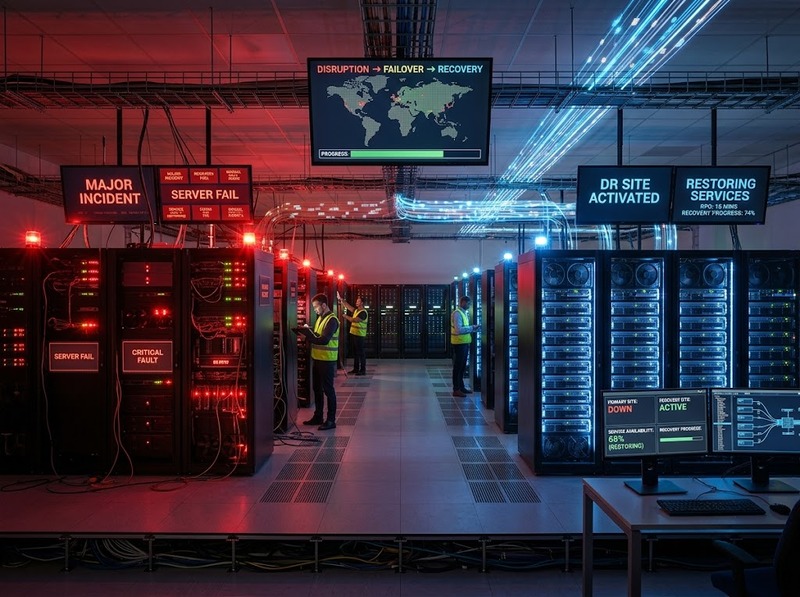
Điểm khác biệt này quyết định cách doanh nghiệp thiết kế dự phòng, sao lưu, chuyển đổi hệ thống, đặt mục tiêu thời gian phục hồi và kiểm thử khả năng ứng phó.
Khả năng phục hồi sau sự cố (disaster recovery) là gì?
Disaster recovery (DR) là tập hợp các chính sách, quy trình và công nghệ nhằm khôi phục các hệ thống công nghệ thông tin, dữ liệu và dịch vụ quan trọng sau một sự cố gây gián đoạn.
Sự cố có thể đến từ nhiều nguyên nhân như hỏng phần cứng, lỗi phần mềm, mất điện, lỗi vận hành, tấn công mạng hoặc thiên tai. Mục tiêu của DR không nhất thiết là giữ hệ thống hoạt động liên tục trong thời điểm lỗi xảy ra, mà là đưa dịch vụ trở lại trạng thái có thể vận hành trong phạm vi thời gian và mức mất dữ liệu đã được xác định.
Hai chỉ số thường dùng để lượng hóa yêu cầu DR là:
· RTO (Recovery Time Objective): khoảng thời gian mục tiêu để khôi phục một dịch vụ sau khi xảy ra gián đoạn
· RPO (Recovery Point Objective): mức dữ liệu tối đa có thể chấp nhận bị mất, tính theo thời điểm phục hồi dữ liệu
Ví dụ, nếu một hệ thống có RTO là 2 giờ và RPO là 15 phút, kế hoạch DR phải hướng tới việc đưa hệ thống trở lại hoạt động trong vòng 2 giờ và giới hạn dữ liệu bị mất ở mức tương đương tối đa 15 phút giao dịch gần nhất.
Vì vậy, disaster recovery không chỉ là sao lưu dữ liệu. Một kế hoạch DR hoàn chỉnh còn phải xác định hệ thống nào quan trọng, thứ tự phục hồi, môi trường dự phòng, dữ liệu cần khôi phục, trách nhiệm vận hành và cách kiểm thử.
Ở góc độ rộng hơn, resilience là khái niệm bao trùm khả năng chuẩn bị, chống chịu, thích nghi và phục hồi trước các sự cố. Disaster recovery là một thành phần quan trọng của khả năng phục hồi đó, không phải toàn bộ khái niệm.
Fault tolerance là gì và cơ chế hoạt động ra sao?
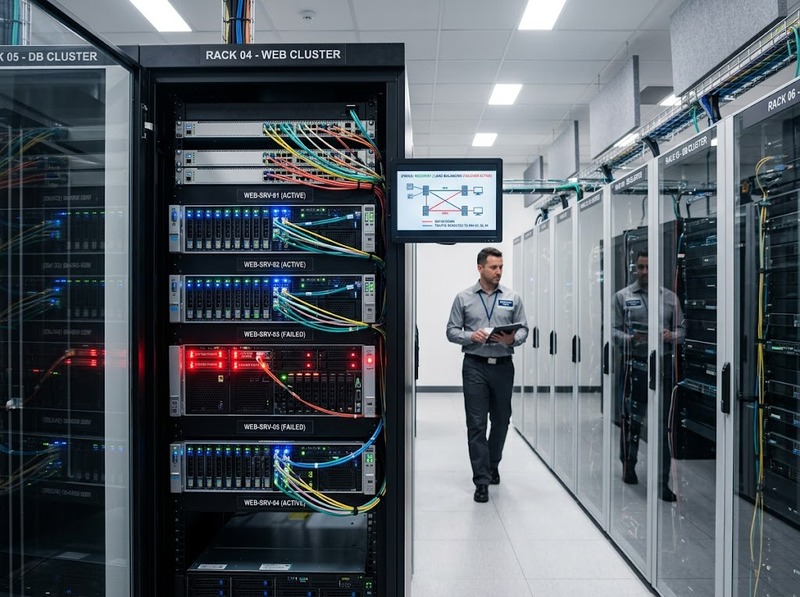
Fault tolerance, hay khả năng chịu lỗi, là khả năng của một hệ thống tiếp tục cung cấp chức năng cần thiết dù một hoặc một số thành phần bên trong đã xảy ra lỗi.
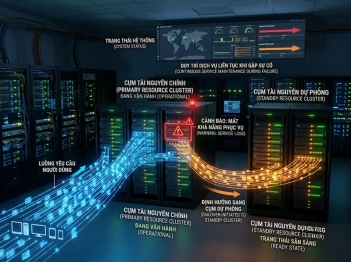
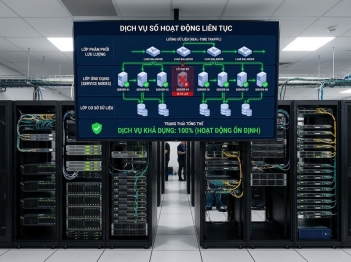
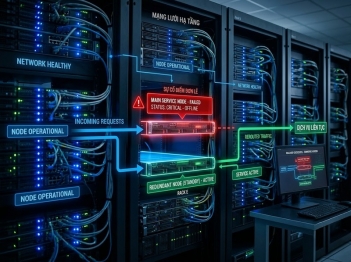
Cách tiếp cận này thường dựa vào dự phòng và chuyển đổi tự động. Thay vì chờ hệ thống hỏng rồi mới phục hồi, kiến trúc chịu lỗi được thiết kế để lỗi của một thành phần không nhất thiết biến thành sự gián đoạn của toàn bộ dịch vụ.
Một số cơ chế thường gặp gồm:
· Redundancy: duy trì các thành phần dự phòng để thay thế khi thành phần chính lỗi
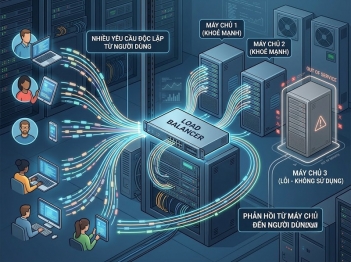
· Failover: chuyển tải sang thành phần hoặc hệ thống dự phòng
· Replication: duy trì nhiều bản sao của dữ liệu hoặc dịch vụ
· N 1: có thêm ít nhất một thành phần dự phòng ngoài số lượng cần thiết để vận hành bình thường
· Health check và automatic recovery: phát hiện thành phần lỗi và thực hiện chuyển đổi hoặc khởi động lại theo thiết kế
Ví dụ, một dịch vụ chạy trên hai máy chủ có cơ chế chuyển đổi tự động có thể tiếp tục nhận yêu cầu khi một máy chủ ngừng hoạt động. Trong trường hợp này, hệ thống đang chịu lỗi, thay vì phải dừng toàn bộ dịch vụ rồi khôi phục từ bản sao lưu.
Tuy nhiên, fault tolerance không có nghĩa là hệ thống miễn nhiễm với mọi sự cố. Nếu lỗi ảnh hưởng đồng thời đến nhiều lớp, chẳng hạn toàn bộ trung tâm dữ liệu, dữ liệu bị phá hủy hoặc cấu hình bị xâm phạm, cơ chế dự phòng cục bộ có thể không đủ.
Disaster recovery khác fault tolerance ở điểm nào?
Khác biệt cốt lõi nằm ở thời điểm và cách hệ thống phản ứng với sự cố.
|
Tiêu chí |
Disaster recovery |
Fault tolerance |
|
Mục tiêu chính |
Khôi phục dịch vụ sau gián đoạn |
Duy trì dịch vụ khi lỗi xảy ra |
|
Phản ứng với lỗi |
Chấp nhận khả năng có thời gian phục hồi |
Hạn chế hoặc tránh gián đoạn |
|
Cơ chế điển hình |
Backup, replication, môi trường DR, restore, failover giữa site |
Redundancy, replication, failover, thành phần dự phòng |
|
Chỉ số quan trọng |
RTO, RPO |
Availability, thời gian chuyển đổi, khả năng duy trì chức năng |
|
Phạm vi sự cố |
Có thể bao gồm sự cố lớn ở cấp hệ thống hoặc địa điểm |
Thường tập trung vào lỗi mà kiến trúc có thể cô lập hoặc chuyển đổi |
|
Dữ liệu |
Có thể cần khôi phục đến một recovery point |
Thường duy trì bản sao hoặc trạng thái hoạt động để tiếp tục dịch vụ |
|
Trạng thái dịch vụ |
Có thể bị gián đoạn trước khi phục hồi |
Mục tiêu là tiếp tục hoạt động trong hoặc ngay sau lỗi |
Có thể hình dung đơn giản:
Fault tolerance:
Lỗi xảy ra → thành phần dự phòng tiếp quản → dịch vụ tiếp tục chạy
Disaster recovery:
Sự cố nghiêm trọng → dịch vụ bị gián đoạn → kích hoạt kế hoạch phục hồi → khôi phục dịch vụ và dữ liệu
Do đó, một hệ thống có fault tolerance tốt vẫn cần disaster recovery. Hai cơ chế này không loại trừ nhau.
Vì sao fault tolerance không thể thay thế disaster recovery?
Fault tolerance chủ yếu xử lý những lỗi mà kiến trúc hệ thống có thể cô lập, dự phòng hoặc chuyển đổi. Disaster recovery phải chuẩn bị cho những tình huống có phạm vi ảnh hưởng lớn hơn.
Chẳng hạn, một cụm máy chủ có thể chịu được việc một máy chủ bị hỏng. Nhưng nếu toàn bộ khu vực triển khai mất điện hoặc trung tâm dữ liệu không thể truy cập, các máy chủ dự phòng trong cùng địa điểm có thể cũng không còn khả dụng.
Tương tự, replication giúp duy trì nhiều bản sao dữ liệu nhưng không tự động bảo vệ dữ liệu khỏi mọi dạng hư hỏng logic. Nếu dữ liệu sai hoặc bị xóa và thay đổi đó được nhân bản sang các bản sao khác, việc có nhiều bản sao không đồng nghĩa với việc có thể quay lại một trạng thái dữ liệu hợp lệ trước đó.
Đây là lý do DR thường cần những thành phần mà fault tolerance không tự cung cấp, chẳng hạn:
· Bản sao lưu có thể phục hồi
· Recovery point được xác định rõ
· Môi trường hoặc địa điểm phục hồi độc lập khi cần
· Quy trình phục hồi dịch vụ
· Quy trình phục hồi dữ liệu
· Kịch bản xử lý sự cố lớn
· Kiểm thử khả năng phục hồi định kỳ
Nói cách khác, fault tolerance giảm xác suất hoặc mức độ gián đoạn; disaster recovery chuẩn bị cho trường hợp gián đoạn vẫn xảy ra.
Khi nào nên dùng disaster recovery, fault tolerance hoặc kết hợp cả hai?
Với hệ thống quan trọng, hai phương pháp thường nên được xem là các lớp bảo vệ bổ sung thay vì lựa chọn một trong hai.
Fault tolerance phù hợp khi chi phí của việc gián đoạn tức thời rất cao. Các hệ thống giao dịch, dịch vụ trực tuyến hoặc thành phần hạ tầng quan trọng có thể cần dự phòng và chuyển đổi để giảm downtime.
Disaster recovery trở nên đặc biệt quan trọng khi doanh nghiệp phải xử lý khả năng xảy ra sự cố vượt quá phạm vi mà kiến trúc dự phòng thông thường có thể chịu được.
Một kiến trúc có thể được phân lớp như sau:
Lớp 1 — Fault tolerance
Giảm gián đoạn do lỗi thành phần
↓
Lớp 2 — High availability / failover
Duy trì dịch vụ thông qua các thành phần hoặc hệ thống dự phòng
↓
Lớp 3 — Disaster recovery
Khôi phục khi sự cố vượt quá khả năng duy trì của kiến trúc đang hoạt động
↓
Lớp 4 — Backup và data recovery
Đảm bảo có thể đưa dữ liệu về một trạng thái phục hồi phù hợp
Cách thiết kế cụ thể phải dựa trên mức độ quan trọng của dịch vụ, RTO, RPO, phạm vi sự cố có thể chấp nhận và chi phí của kiến trúc dự phòng.
Những hiểu lầm thường gặp về disaster recovery và khả năng chịu lỗi
Có backup là đã có disaster recovery là một hiểu lầm phổ biến. Backup chỉ giải quyết một phần bài toán dữ liệu. Nếu chưa xác định cách khôi phục hệ thống, thứ tự phục hồi và thời gian mục tiêu, doanh nghiệp chưa có một năng lực DR hoàn chỉnh.
Có fault tolerance thì không cần DR cũng không đúng. Fault tolerance thường được thiết kế cho những lỗi mà hệ thống có thể xử lý bằng dự phòng hoặc chuyển đổi. Nó không bảo đảm hệ thống có thể phục hồi trước một sự cố diện rộng.
Replication đồng nghĩa với backup cũng cần phân biệt. Replication giúp duy trì bản sao gần với hệ thống đang hoạt động, còn backup phục vụ mục tiêu khôi phục về một trạng thái dữ liệu phù hợp. Hai cơ chế có thể bổ trợ nhưng không có cùng chức năng.
DR luôn phải phục hồi trong vài phút cũng không chính xác. RTO là một yêu cầu được xác định theo mức độ quan trọng của dịch vụ và nhu cầu kinh doanh. Hệ thống khác nhau có thể có RTO rất khác nhau.
Cuối cùng, khả năng phục hồi không chỉ là vấn đề công nghệ. Một kế hoạch có thể thất bại nếu không xác định rõ người chịu trách nhiệm, quy trình kích hoạt, quyền truy cập, phụ thuộc giữa các dịch vụ và cách kiểm thử. DR chỉ có giá trị thực tế khi kế hoạch phục hồi đã được kiểm chứng.
Disaster recovery và fault tolerance vì thế nên được nhìn như hai lớp bảo vệ có mục tiêu khác nhau. Fault tolerance giúp hệ thống tiếp tục hoạt động khi có lỗi; disaster recovery giúp hệ thống trở lại hoạt động khi sự cố đủ nghiêm trọng để gây gián đoạn. Một kiến trúc đáng tin cậy thường kết hợp cả hai, đồng thời dùng RTO và RPO để biến yêu cầu phục hồi thành các mục tiêu có thể kiểm chứng.
Hỏi đáp về disaster recovery
Disaster recovery có phải là fault tolerance không?
Không. Fault tolerance hướng tới việc duy trì hoạt động khi lỗi xảy ra, còn disaster recovery hướng tới khôi phục dịch vụ và dữ liệu sau một sự cố gây gián đoạn.
Backup có thay thế được disaster recovery không?
Không. Backup là một thành phần của chiến lược phục hồi dữ liệu. Disaster recovery còn bao gồm quy trình, hạ tầng, thứ tự phục hồi và mục tiêu như RTO, RPO.
Một hệ thống có fault tolerance có cần disaster recovery không?
Có, nếu hệ thống phải được bảo vệ trước các sự cố vượt quá phạm vi mà cơ chế chịu lỗi có thể xử lý. Fault tolerance và disaster recovery thường bổ sung cho nhau.

GỬI Ý KIẾN BÌNH LUẬN

