
Load balancer phân phối lưu lượng giữa các máy chủ thế nào?
Mục lục
- Load balancer là gì và đứng ở đâu trong luồng truy cập?
- Một request được phân phối đến backend theo quy trình nào?
- Các thuật toán chọn máy chủ phân phối lưu lượng ra sao?
- Health check giữ máy chủ lỗi ra khỏi vòng phân phối như thế nào?
- L4 và L7 ảnh hưởng đến quyết định phân phối thế nào?
- Vì sao lưu lượng thực tế không phải lúc nào cũng chia đều?
Load balancer tiếp nhận lưu lượng từ client, chọn máy chủ backend còn khả dụng theo thuật toán phân phối rồi chuyển request đến máy chủ phù hợp. Cơ chế thực tế còn phụ thuộc health check, lớp L4/L7, trọng số, thời lượng kết nối và session persistence nên lưu lượng không nhất thiết được chia đều tuyệt đối.
Load balancer là thành phần trung gian đứng trước một nhóm máy chủ backend. Thay vì để client kết nối trực tiếp đến từng server, client gửi lưu lượng đến một điểm truy cập chung; load balancer xác định backend nào đủ điều kiện nhận công việc rồi chuyển connection hoặc request đến đó.
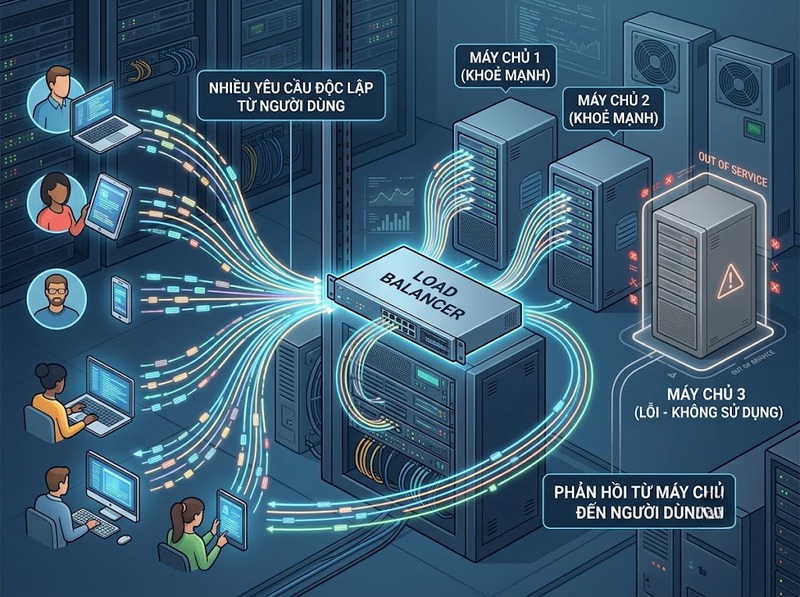
Điểm quan trọng là load balancer thường không “chia nhỏ” một request để nhiều server cùng xử lý. Việc cân bằng xuất hiện trên một chuỗi nhiều connection hoặc request: request này có thể đến server A, request tiếp theo đến B hoặc C tùy thuật toán, trạng thái sức khỏe và các ràng buộc đang áp dụng. Nhờ vậy, tải không tập trung vào một máy chủ duy nhất và server gặp lỗi có thể được loại khỏi vòng phân phối.
Load balancer là gì và đứng ở đâu trong luồng truy cập?
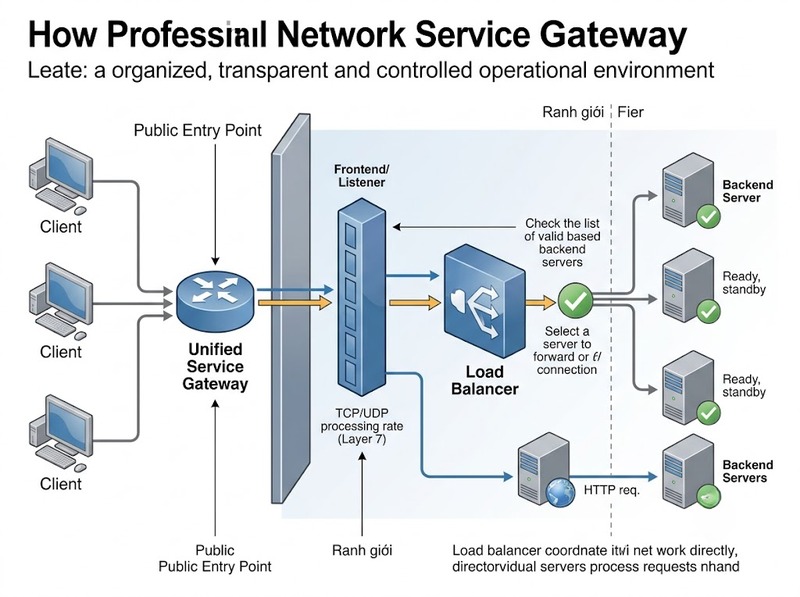
Trong mô hình phổ biến, client chỉ biết hostname hoặc địa chỉ dịch vụ công khai. Điểm đó dẫn lưu lượng đến load balancer; phía sau là một backend pool gồm nhiều máy chủ cùng cung cấp dịch vụ. Load balancer có một phía tiếp nhận traffic, thường được gọi là frontend hoặc listener, và một phía kết nối đến các backend.
Luồng cơ bản có dạng:
Client → Load balancer → Backend server
Load balancer giữ thông tin về các backend có thể nhận lưu lượng và áp dụng chính sách để chọn một trong số đó. Quyết định có thể diễn ra ở mức connection hoặc request. Một load balancer L4 thường làm việc với flow TCP/UDP, trong khi load balancer L7 có thể đưa thông tin của giao thức ứng dụng như HTTP vào quyết định định tuyến.
Vì vậy, chức năng cốt lõi của cân bằng tải không phải làm cho một server xử lý request nhanh hơn. Nó thay đổi nơi công việc mới được đưa đến, qua đó giảm hiện tượng một máy chủ bị dồn tải trong khi các máy khác còn khả năng xử lý.
Một request được phân phối đến backend theo quy trình nào?
Khi traffic đến listener, load balancer trước tiên xác định request hoặc connection thuộc dịch vụ nào. Từ cấu hình của dịch vụ đó, nó lấy ra backend pool tương ứng và chỉ giữ những server hiện được xem là đủ điều kiện nhận lưu lượng.
Tiếp theo, thuật toán cân bằng tải được áp dụng trên tập backend hợp lệ. Thuật toán có thể đơn giản như luân phiên từng server, hoặc sử dụng trạng thái như số connection đang hoạt động, số request chưa hoàn tất, trọng số của backend hay một giá trị hash. Những ràng buộc như session affinity cũng có thể giới hạn lựa chọn.
Sau khi chọn được server, load balancer chuyển traffic đến backend. Trong mô hình proxy phổ biến, backend trả response về load balancer và load balancer chuyển response lại cho client:
Client → Load balancer → Server B → Load balancer → Client
Không phải mọi kiến trúc đều bắt buộc response quay lại theo đúng đường này. Một số thiết kế mạng sử dụng direct server return hoặc cơ chế định tuyến khác, nhưng đó là trường hợp triển khai riêng chứ không thay đổi nguyên tắc chọn backend.
Cũng cần phân biệt connection-level balancing với request-level balancing. Nếu quyết định được thực hiện cho một TCP connection, nhiều dữ liệu đi trên connection đó thường tiếp tục đến cùng backend trong suốt vòng đời kết nối. Với proxy L7, việc cân bằng có thể diễn ra ở cấp HTTP request tùy giao thức và cách triển khai. Vì thế, “một kết nối” và “một yêu cầu” không phải lúc nào cũng là cùng một đơn vị tải.
Các thuật toán chọn máy chủ phân phối lưu lượng ra sao?
Thuật toán quyết định backend nào sẽ nhận công việc tiếp theo. Mỗi thuật toán tối ưu một tín hiệu khác nhau, vì vậy “cân bằng” không đồng nghĩa với việc mọi server luôn nhận chính xác cùng số request.
Round robin và weighted round robin
Round robin lần lượt chọn các backend đang khả dụng. Với ba server A, B và C có cùng trọng số, chuỗi lựa chọn có thể là A → B → C → A → B → C. Nếu có 300 request tương đương, cả ba server luôn healthy và không có ràng buộc khác, mỗi server sẽ nhận xấp xỉ 100 request.
Weighted round robin bổ sung trọng số để phản ánh khả năng xử lý khác nhau. Nếu A, B và C có trọng số lần lượt là 2:1:1, trong điều kiện lý tưởng A sẽ nhận khoảng 50% lưu lượng, còn B và C mỗi máy khoảng 25%. Cơ chế này phù hợp khi backend không có cùng năng lực hoặc khi cần chủ động phân bổ tỷ lệ khác nhau.
Giới hạn của round robin là nó chủ yếu quan tâm đến thứ tự hoặc trọng số, không biết một request cụ thể tiêu tốn bao nhiêu CPU, bộ nhớ hay thời gian xử lý. Hai server nhận cùng 100 request vẫn có thể chịu tải rất khác nếu độ nặng của các request không giống nhau.
Least connections và least outstanding requests
Least connections ưu tiên backend đang có ít connection hoạt động hơn. Cách này hữu ích khi connection có thời lượng khác nhau, vì server đang giữ nhiều connection dài sẽ ít có khả năng tiếp tục nhận thêm connection mới.
Ở tầng ứng dụng, một số hệ thống sử dụng biến thể như least outstanding requests, tập trung vào số request đang chờ hoàn tất thay vì số TCP connection. Sự khác biệt này đáng chú ý với HTTP hiện đại: một connection có thể mang nhiều request, nên số connection thấp chưa chắc đồng nghĩa với lượng công việc thấp.
Các thuật toán này vẫn không đo trực tiếp mức sử dụng CPU hoặc độ phức tạp của từng request. Chúng cân bằng theo metric mà chúng quan sát được.
Hash và session affinity
Load balancer cũng có thể dùng source IP, cookie hoặc khóa khác để tạo hash rồi ánh xạ traffic về một backend. Mục tiêu thường là duy trì session affinity, tức những request có cùng khóa có xu hướng quay về cùng server.
Cách này có ích khi ứng dụng còn giữ trạng thái cục bộ hoặc khi việc giữ locality mang lại lợi ích. Đổi lại, phân phối có thể kém đều hơn. Chẳng hạn, nhiều người dùng đi qua cùng một NAT có thể xuất hiện với cùng source IP; nếu source-IP hash được sử dụng, một backend có thể nhận lượng traffic lớn hơn dự kiến.
Khi backend bị lỗi hoặc danh sách server thay đổi, ánh xạ cũng có thể phải thay đổi. Mức độ xáo trộn phụ thuộc thuật toán hash và cách triển khai.
Health check giữ máy chủ lỗi ra khỏi vòng phân phối như thế nào?
Thuật toán chỉ có ý nghĩa nếu load balancer biết backend nào còn phục vụ được. Health check tạo ra tập server hợp lệ mà thuật toán được phép chọn.
Với active health check, load balancer chủ động gửi probe đến backend theo chu kỳ, chẳng hạn kiểm tra khả năng mở kết nối hoặc gọi một endpoint của ứng dụng. Sau số lần thành công hoặc thất bại theo ngưỡng được cấu hình, trạng thái backend có thể chuyển giữa healthy và unhealthy. Không có một khoảng thời gian hay số lần kiểm tra cố định phù hợp cho mọi hệ thống; các giá trị này phụ thuộc yêu cầu phát hiện lỗi và khả năng chịu dao động tạm thời của dịch vụ.
Passive health checking sử dụng lỗi quan sát được từ traffic thực tế, chẳng hạn lỗi thiết lập connection hoặc phản hồi không hợp lệ theo chính sách của hệ thống. Nhiều load balancer có thể kết hợp tín hiệu chủ động và thụ động.
Khi server B được đánh dấu unhealthy, request mới sẽ được phân phối trên các backend còn lại thay vì tiếp tục đưa traffic đến B. Nếu B phục hồi và vượt qua điều kiện health check, nó có thể được đưa trở lại pool.
Health check cũng có giới hạn. Kiểm tra một cổng TCP thành công chỉ chứng minh tiến trình có thể nhận connection ở mức đó; ứng dụng bên trong vẫn có thể không đủ khả năng phục vụ request thực tế. Ngược lại, endpoint health check quá nặng hoặc phụ thuộc vào quá nhiều thành phần phụ có thể loại một server khỏi pool dù phần chức năng cần thiết vẫn hoạt động. Vì thế, tín hiệu health nên phản ánh đúng mức “sẵn sàng nhận traffic” mà load balancer cần quyết định.
L4 và L7 ảnh hưởng đến quyết định phân phối thế nào?
Ở Layer 4, load balancer chủ yếu dựa trên thông tin tầng vận chuyển. Một flow mạng thường được phân biệt bằng 5-tuple gồm source IP, source port, destination IP, destination port và protocol. Từ những dữ liệu này cùng trạng thái backend, hệ thống có thể chọn server mà không cần hiểu nội dung HTTP bên trong.
Điều đó phù hợp với cân bằng TCP/UDP và các trường hợp muốn giữ xử lý ở tầng transport. Đổi lại, L4 không thể tự đưa những thuộc tính ứng dụng như URL path hoặc HTTP header vào quyết định nếu chúng không được giải mã và xử lý ở lớp cao hơn.
Ở Layer 7, load balancer hoạt động như proxy ở tầng ứng dụng nên có thể sử dụng thông tin HTTP như host/authority, path, method, header hoặc cookie. Chẳng hạn, /api/ có thể được đưa tới một backend pool khác với /static/, hoặc cookie có thể được dùng để duy trì affinity. Đây vẫn là cân bằng tải, nhưng tập dữ liệu dùng để chọn backend phong phú hơn.
TLS tạo ra một ranh giới quan trọng. Nếu kết nối HTTPS chỉ được chuyển tiếp ở chế độ TLS passthrough, thành phần L4 không nhìn thấy nội dung HTTP đã mã hóa. Muốn định tuyến dựa trên path, header hoặc cookie, một proxy L7 thường phải có điểm xử lý TLS để truy cập thông tin ứng dụng.
HTTP/2 cũng cho thấy vì sao metric cần được hiểu đúng. Nhiều request có thể được multiplex trên một TCP connection. Do đó, thuật toán chỉ nhìn số connection có thể đánh giá tải khác với thuật toán theo dõi số request đang xử lý. Đây là lý do một thuật toán phù hợp cho traffic connection-oriented chưa chắc phản ánh tốt workload ở cấp HTTP request.
Vì sao lưu lượng thực tế không phải lúc nào cũng chia đều?
Một hệ thống có thể đang cân bằng tải đúng dù các backend không nhận cùng số request. Kết quả phân phối chịu tác động đồng thời của thuật toán, trọng số, health status, session affinity, thời lượng connection và đặc điểm của từng request.
Ngay cả khi A và B đều nhận 1.000 request, tải tính toán vẫn có thể khác đáng kể nếu request của A chủ yếu là tác vụ nhẹ còn request của B thực hiện truy vấn hoặc xử lý tốn tài nguyên hơn. Ngược lại, least connections có thể làm số connection giữa các server gần nhau hơn nhưng không đảm bảo CPU hoặc bộ nhớ sử dụng ngang nhau.
Connection dài cũng làm phân phối thay đổi theo thời gian. Một server giữ nhiều WebSocket hoặc connection kéo dài có thể trông “bận” hơn theo thuật toán least connections, trong khi round robin vẫn tiếp tục luân phiên request mới. Session persistence lại cố ý đưa một nhóm traffic về cùng backend, còn health check có thể tạm thời thu nhỏ pool khiến các server còn lại phải nhận phần tải lớn hơn.
Vì vậy, mục tiêu thực tế nên được hiểu là phân bổ công việc theo metric và ràng buộc đã chọn, không phải tạo tỷ lệ request bằng nhau bằng mọi giá. Nếu workload không đồng nhất, metric gần với công việc đang xử lý thường có ý nghĩa hơn việc chỉ đếm request.
Load balancer cũng không làm biến mất tổng lượng tính toán mà ứng dụng phải thực hiện. Nó giảm sự tập trung tải, tận dụng nhiều backend và tránh tiếp tục gửi công việc mới đến server không khả dụng. Nếu toàn bộ backend đều đã hết năng lực xử lý, thay đổi thuật toán phân phối không thể tự tạo thêm capacity; khi đó vấn đề nằm ở tổng tài nguyên của hệ thống chứ không chỉ ở cách chia traffic.
Load balancer phân phối lưu lượng bằng cách tiếp nhận connection hoặc request, xác định các backend đang đủ điều kiện, áp dụng thuật toán cùng các ràng buộc như trọng số hoặc session affinity rồi chuyển công việc đến server được chọn. Health check quyết định server nào còn nằm trong vòng phân phối, còn L4 hay L7 quyết định loại thông tin mà load balancer có thể dùng khi lựa chọn.
Do đó, cân bằng tải hiệu quả không nhất thiết tạo ra số request bằng nhau trên mọi máy chủ. Giá trị chính của cơ chế này là tránh điểm nóng, sử dụng nhiều backend hợp lý và chuyển traffic khỏi server gặp lỗi; nó không thay thế năng lực xử lý cần thiết khi toàn bộ hệ thống đã quá tải.

GỬI Ý KIẾN BÌNH LUẬN

