
Observability khác giám sát hệ thống như thế nào?
Mục lục
- Monitoring tập trung vào việc phát hiện trạng thái bất thường
- Observability tập trung vào khả năng suy luận trạng thái bên trong
- Khác biệt cốt lõi nằm ở khả năng trả lời câu hỏi chưa biết trước
- Observability không đồng nghĩa với việc thu thập càng nhiều dữ liệu càng tốt
- Monitoring và observability nên được dùng cùng nhau
- Khi nào monitoring là đủ và khi nào cần observability?
Observability và monitoring đều giúp theo dõi hệ thống, nhưng khác nhau ở mục tiêu nhận thức: monitoring phát hiện và cảnh báo trạng thái bất thường, còn observability giúp suy luận nguyên nhân bên trong từ các tín hiệu hệ thống
Monitoring và observability đều xuất hiện trong vận hành hệ thống, nhưng chúng không phải hai cách gọi khác nhau cho cùng một hoạt động. Điểm phân biệt quan trọng nhất nằm ở khả năng hiểu trạng thái bên trong của hệ thống từ những gì có thể quan sát được bên ngoài.
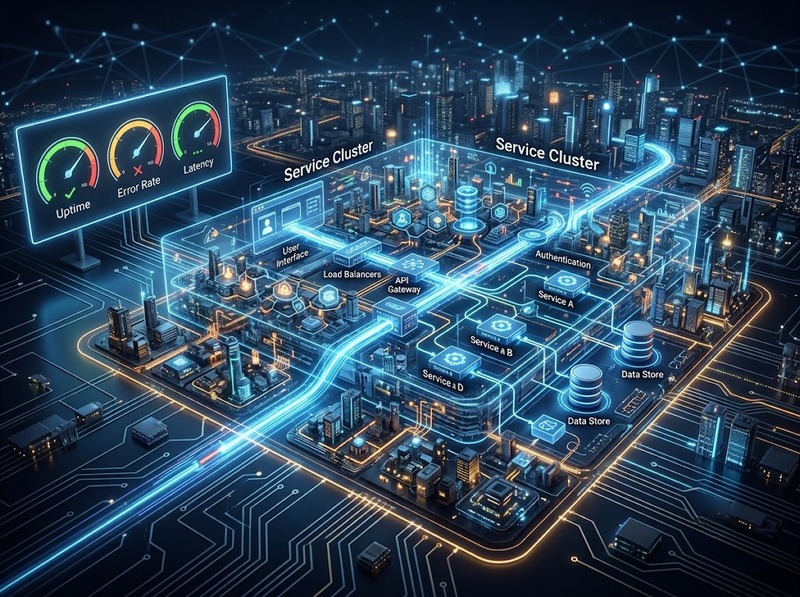
Monitoring chủ yếu trả lời: “Hệ thống có đang hoạt động bình thường không?” Khi một chỉ số vượt ngưỡng hoặc một điều kiện được xác định trước xảy ra, monitoring có thể phát hiện và cảnh báo.
Observability đi xa hơn: “Điều gì đang xảy ra bên trong hệ thống và tại sao nó xảy ra?” Nó sử dụng nhiều tín hiệu như metrics, logs và traces để giúp suy luận trạng thái nội tại, đặc biệt trong những tình huống chưa được dự đoán trước.
Vì vậy, có thể xem monitoring là cơ chế phát hiện vấn đề, còn observability là năng lực giúp điều tra và giải thích vấn đề.
Monitoring tập trung vào việc phát hiện trạng thái bất thường
Monitoring là quá trình thu thập và theo dõi các chỉ số hoặc điều kiện đã được xác định trước để biết hệ thống có đang vận hành trong trạng thái mong muốn hay không.
Ví dụ, một hệ thống có thể theo dõi:
· CPU vượt 80%
· Memory sử dụng vượt 90%
· Tỷ lệ lỗi HTTP 5xx tăng cao
· Latency vượt ngưỡng
· Một service không phản hồi
· Số lượng request giảm bất thường
Khi một điều kiện được định nghĩa trước bị vi phạm, monitoring có thể tạo cảnh báo.
Điểm mạnh của cách tiếp cận này là tính rõ ràng và khả năng tự động hóa. Đội vận hành có thể xác định trước điều gì được xem là bất thường, đặt ngưỡng hoặc điều kiện cảnh báo, sau đó phản ứng khi hệ thống vượt khỏi phạm vi đó.
Nhưng monitoring có một giới hạn quan trọng: nó thường cần biết trước nên theo dõi cái gì.
Nếu một vấn đề mới xuất hiện nhưng chưa có metric, threshold hoặc alert rule tương ứng, monitoring có thể không cho biết rõ vấn đề đang nằm ở đâu. Thậm chí hệ thống có thể vẫn đáp ứng các ngưỡng monitoring trong khi trải nghiệm người dùng đã suy giảm.
Đó là khoảng trống mà observability hướng tới giải quyết.
Observability tập trung vào khả năng suy luận trạng thái bên trong
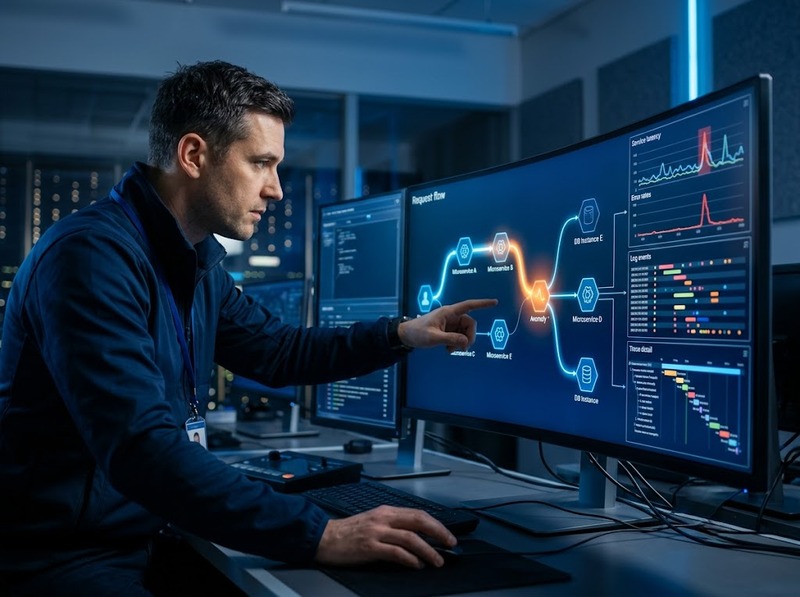
Observability không đơn giản là “có nhiều metric hơn”. Cốt lõi của nó là khả năng dùng dữ liệu quan sát được từ hệ thống để suy luận về trạng thái bên trong mà không nhất thiết phải biết trước mọi câu hỏi cần đặt ra.
Ba loại tín hiệu thường đóng vai trò quan trọng là:
· Metrics: Các giá trị định lượng mô tả trạng thái hoặc hành vi của hệ thống theo thời gian
· Logs: Các sự kiện và thông tin chi tiết được ghi lại trong quá trình hệ thống hoạt động
· Traces: Dấu vết của một request hoặc transaction đi qua nhiều thành phần của hệ thống
Giá trị của observability xuất hiện khi các tín hiệu này có thể được liên hệ với nhau.
Chẳng hạn, monitoring có thể cho biết latency của API tăng cao. Nhưng để điều tra sâu hơn, observability cho phép đi từ latency đó tới request cụ thể, trace tương ứng, service gây chậm, log liên quan và các tín hiệu khác xuất hiện cùng thời điểm.
Vì vậy, observability không chỉ giúp trả lời “có vấn đề hay không”, mà còn hỗ trợ trả lời “vấn đề nằm ở đâu, xảy ra như thế nào và nguyên nhân có thể là gì”.
Khác biệt cốt lõi nằm ở khả năng trả lời câu hỏi chưa biết trước
Điểm khác biệt dễ hiểu nhất giữa monitoring và observability là loại câu hỏi mà mỗi cách tiếp cận có thể hỗ trợ.
|
Khía cạnh |
Monitoring |
Observability |
|
Mục tiêu chính |
Phát hiện trạng thái bất thường |
Hiểu và suy luận trạng thái bên trong |
|
Câu hỏi điển hình |
Hệ thống có lỗi không? |
Điều gì đang xảy ra và tại sao? |
|
Cách tiếp cận |
Theo dõi tín hiệu và điều kiện đã định nghĩa |
Kết hợp nhiều tín hiệu để điều tra |
|
Alert |
Có vai trò trung tâm |
Là một phần trong quy trình quan sát |
|
Điều tra nguyên nhân |
Có thể bị giới hạn bởi dữ liệu đã định nghĩa |
Hỗ trợ truy nguyên sâu hơn |
|
Tình huống mới chưa biết trước |
Khó xử lý nếu chưa có rule tương ứng |
Có khả năng hỗ trợ khám phá tốt hơn |
|
Giá trị chính |
Detection |
Understanding và Investigation |
Sự khác biệt này không có nghĩa observability thay thế monitoring. Hai khái niệm phục vụ những tầng nhận thức khác nhau.
Monitoring đặc biệt hữu ích khi câu hỏi đã rõ: “Nếu X vượt ngưỡng thì hãy báo cho tôi.”
Observability trở nên quan trọng khi câu hỏi chưa rõ: “Người dùng đang gặp vấn đề, hãy giúp tôi tìm xem bên trong hệ thống đang xảy ra chuyện gì.”
Observability không đồng nghĩa với việc thu thập càng nhiều dữ liệu càng tốt
Một hiểu lầm phổ biến là cứ có nhiều logs, metrics và traces thì hệ thống đã có observability tốt.
Thực tế, số lượng telemetry không tự động tạo ra khả năng hiểu hệ thống.
Giá trị còn phụ thuộc vào việc dữ liệu có đủ ngữ cảnh và có thể liên kết với nhau hay không. Nếu metrics, logs và traces tồn tại nhưng không thể liên hệ request với service, service với dependency hoặc sự kiện với thời điểm xảy ra lỗi, quá trình điều tra vẫn có thể khó khăn.
Vì vậy, một hệ thống observability tốt cần chú ý đến:
· Khả năng thu thập tín hiệu phù hợp
· Ngữ cảnh đi kèm mỗi tín hiệu
· Khả năng liên kết giữa các tín hiệu
· Khả năng truy vấn và khám phá dữ liệu
· Khả năng đi từ triệu chứng đến nguyên nhân
Điểm này cũng tạo ra một boundary quan trọng: observability là một năng lực của hệ thống quan sát và điều tra, không phải chỉ là danh sách công cụ hoặc số lượng telemetry được thu thập.
Monitoring và observability nên được dùng cùng nhau
Trong vận hành thực tế, đặt monitoring và observability đối lập nhau thường dẫn đến cách tiếp cận không đầy đủ.
Một hệ thống có thể sử dụng monitoring để phát hiện nhanh các điều kiện đã biết, sau đó sử dụng observability để điều tra những gì đang xảy ra phía sau cảnh báo.
Có thể hình dung luồng xử lý như sau:
Monitoring → Phát hiện → Cảnh báo → Observability → Điều tra → Suy luận nguyên nhân → Khắc phục
Ví dụ, monitoring phát hiện tỷ lệ lỗi của một API tăng cao. Đây là tín hiệu để đội vận hành biết rằng hệ thống đang có vấn đề.
Tiếp theo, observability có thể giúp truy vấn các metrics liên quan, tìm trace của những request lỗi, đối chiếu logs và xác định service hoặc dependency liên quan. Khi đó, đội vận hành không chỉ biết “API đang lỗi” mà có thêm cơ sở để hiểu “lỗi xuất hiện ở thành phần nào và trong luồng xử lý nào”.
Do đó, monitoring cung cấp khả năng phát hiện có hệ thống, trong khi observability cung cấp khả năng điều tra có chiều sâu.
Khi nào monitoring là đủ và khi nào cần observability?
Monitoring có thể đáp ứng tốt những tình huống mà trạng thái cần theo dõi tương đối rõ ràng và các điều kiện bất thường có thể được định nghĩa trước.
Ví dụ, nếu mục tiêu là biết một server có vượt ngưỡng CPU hay không, một hệ thống monitoring với metric và alert phù hợp có thể đã đáp ứng nhu cầu.
Observability trở nên có giá trị hơn khi hệ thống có nhiều thành phần, nhiều dependency và hành vi khó dự đoán. Khi một vấn đề xảy ra, đội vận hành cần khám phá dữ liệu để tìm nguyên nhân thay vì chỉ kiểm tra một danh sách cảnh báo đã được định nghĩa sẵn.
Có thể dùng cách phân biệt thực dụng sau:
· Nếu câu hỏi là “Có vấn đề không?”, monitoring thường là lớp đầu tiên cần có
· Nếu câu hỏi là “Vấn đề nằm ở đâu?”, cần khả năng điều tra sâu hơn
· Nếu câu hỏi là “Tại sao vấn đề xảy ra?”, observability trở nên đặc biệt quan trọng
· Nếu vấn đề có thể phát sinh theo những cách chưa được dự đoán trước, khả năng khám phá và liên kết telemetry càng có giá trị
Nói cách khác, monitoring giúp hệ thống biết khi nào cần chú ý, còn observability giúp con người hiểu nên chú ý vào đâu và điều gì có thể đang xảy ra bên trong.
Tóm lại, observability không phải là một phiên bản monitoring có nhiều dữ liệu hơn. Monitoring chủ yếu tập trung vào việc theo dõi các trạng thái và điều kiện đã được xác định để phát hiện bất thường. Observability tập trung vào khả năng suy luận trạng thái bên trong từ các tín hiệu mà hệ thống phát ra, qua đó hỗ trợ điều tra những vấn đề chưa chắc đã được dự đoán trước.
Vì thế, cách phân biệt ngắn gọn nhất là: monitoring thiên về detection, còn observability thiên về understanding và investigation. Hai năng lực này bổ sung cho nhau thay vì loại trừ nhau.

GỬI Ý KIẾN BÌNH LUẬN

