
Vì sao cần làm sạch dữ liệu trước khi phân tích?
Mục lục
Làm sạch dữ liệu giúp phát hiện và xử lý lỗi, giá trị thiếu, bản ghi trùng và dữ liệu bất thường để kết quả phân tích phản ánh đúng dữ liệu đầu vào.
Làm sạch dữ liệu (data cleaning hoặc data cleansing) là quá trình phát hiện, đánh giá và xử lý các vấn đề chất lượng trong dữ liệu trước khi đưa dữ liệu vào tính toán. Các vấn đề thường gặp gồm giá trị thiếu, bản ghi trùng, sai kiểu dữ liệu, định dạng không nhất quán, giá trị ngoài miền hợp lệ và các điểm bất thường cần xác minh.
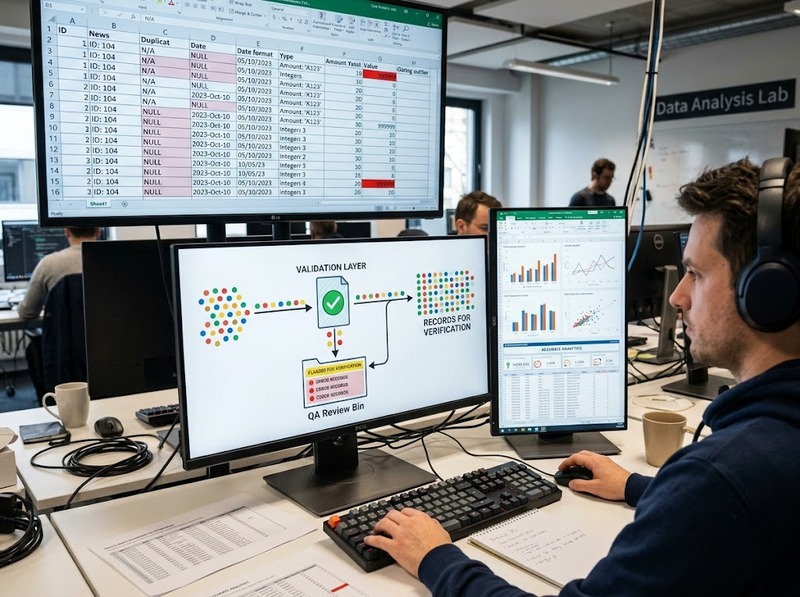
Việc này cần diễn ra trước phân tích vì phép tính không tự phân biệt được đâu là tín hiệu thật và đâu là lỗi dữ liệu. Một bản ghi bị nhân đôi có thể làm tăng số đếm hoặc tổng; một nhóm giá trị bị thiếu có hệ thống có thể làm lệch trung bình; một ngày tháng bị hiểu sai định dạng có thể bị xếp vào sai kỳ. Tuy nhiên, làm sạch không có nghĩa là xóa mọi giá trị lạ. Mục tiêu là đưa dữ liệu về trạng thái phù hợp với quy tắc và mục đích phân tích, đồng thời giữ nguyên những biến thiên hợp lệ.
Làm sạch dữ liệu là gì?
Làm sạch dữ liệu là một quy trình kiểm soát chất lượng dữ liệu, không chỉ là thao tác “sửa lỗi”. Quy trình này thường bắt đầu bằng việc rà soát dữ liệu để phát hiện vấn đề, sau đó đối chiếu với quy tắc hợp lệ hoặc ngữ nghĩa nghiệp vụ, thực hiện xử lý phù hợp và cuối cùng kiểm tra lại dữ liệu sau thay đổi. Theo cách hiểu này, một giá trị chỉ nên bị sửa, xóa hoặc thay thế khi có căn cứ cho thấy nó không đáp ứng yêu cầu của bộ dữ liệu hoặc của phép phân tích.
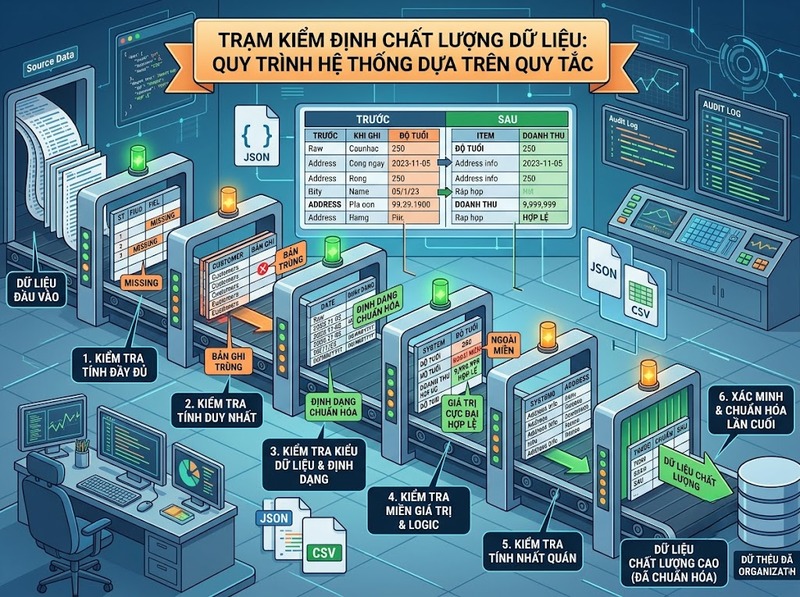
Các vấn đề cần làm sạch thường liên quan đến những chiều chất lượng dễ đo như tính đầy đủ, tính duy nhất, tính hợp lệ và tính nhất quán. Ví dụ, cột ngày giao dịch có thể chứa cả 2026-08-28 và 28/08/2026; mã khách hàng đáng lẽ duy nhất có thể xuất hiện ở hai bản ghi do nhập lặp; cột số lượng có thể chứa chuỗi "mười" thay vì số; hoặc một trường bắt buộc bị để trống. Mỗi dạng lỗi đòi hỏi một quy tắc xử lý khác nhau.
Các bộ tiêu chuẩn về chất lượng dữ liệu như ISO 8000 và các thực hành quản trị dữ liệu trong DAMA-DMBOK đều củng cố một nguyên tắc quan trọng: chất lượng phải được đánh giá theo yêu cầu và tiêu chí xác định, chứ không theo cảm giác dữ liệu “đẹp” hay “xấu”. Vì vậy, làm sạch dữ liệu nên có quy tắc, có kiểm tra trước và sau, và có khả năng truy vết những thay đổi đã thực hiện.
Ranh giới quan trọng là không đánh đồng “khác thường” với “sai”. Một giá trị rất lớn có thể là lỗi nhập liệu, nhưng cũng có thể là một giao dịch thật. Một khách hàng xuất hiện nhiều lần có thể là bản ghi trùng, nhưng cũng có thể là nhiều giao dịch hợp lệ. Làm sạch tốt bảo toàn ý nghĩa của dữ liệu thay vì ép mọi quan sát về một mẫu đồng nhất.
Vì sao phải làm sạch dữ liệu trước khi phân tích?
Phân tích dữ liệu sử dụng chính các quan sát đầu vào để tính số đếm, tỷ lệ, trung bình, phân phối, tương quan hoặc các chỉ số khác. Khi đầu vào có lỗi, lỗi đó có thể đi thẳng vào phép tính. Đây là lý do làm sạch dữ liệu cần được thực hiện trước khi diễn giải kết quả.
Bản ghi trùng là ví dụ dễ thấy. Nếu một tập có 100 giao dịch nhưng 5 giao dịch bị ghi thêm một lần, hệ thống sẽ đếm 105 dòng. Tổng doanh thu cũng bị cộng thêm đúng giá trị của 5 giao dịch trùng, nên mức sai lệch không nhất thiết bằng 5%; nó phụ thuộc giá trị của các giao dịch bị nhân đôi. Nếu các dòng trùng tập trung ở một nhóm khách hàng, tỷ trọng của nhóm đó cũng bị phóng đại.
Dữ liệu thiếu gây vấn đề theo cơ chế khác. Giả sử 20% giá trị thu nhập bị thiếu và phần thiếu chủ yếu thuộc nhóm thu nhập cao. Trung bình tính trên 80% quan sát còn lại có thể thấp hơn mức thực tế của toàn bộ nhóm, dù công thức tính trung bình hoàn toàn đúng. Vấn đề nằm ở mẫu dữ liệu được đưa vào phép tính, không nằm ở phép tính.
Lỗi kiểu dữ liệu và định dạng có thể làm phép phân tích thất bại hoặc phân nhóm sai. Chuỗi 01/02/2026 có thể được hiểu là ngày 1 tháng 2 hoặc ngày 2 tháng 1 tùy quy ước; số tiền được lưu dưới dạng chuỗi có thể không được cộng đúng; cùng một đơn vị “kg” và “g” nếu không quy đổi sẽ tạo ra so sánh sai. Những lỗi này thường không tự biến mất khi đưa dữ liệu vào công cụ phân tích.
Outlier lại cần thận trọng hơn. Với năm giá trị 10, 10, 11, 11, 100, trung bình là 28,4 trong khi trung vị là 11. Điểm 100 ảnh hưởng mạnh đến trung bình, nhưng chỉ nên xóa nếu có bằng chứng đó là lỗi hoặc không thuộc phạm vi phân tích. Nếu 100 là một quan sát thật, xóa nó chỉ để “làm đẹp” phân phối sẽ làm mất thông tin.
Làm sạch vì thế giúp bảo vệ tính hợp lệ của đầu vào, nhưng không thể bảo đảm mọi kết luận đều đúng. Một bộ dữ liệu sạch vẫn có thể dẫn đến phân tích sai nếu câu hỏi nghiên cứu, cách chọn mẫu hoặc phương pháp tính không phù hợp. Cleaning xử lý rủi ro chất lượng dữ liệu; nó không thay thế cho thiết kế phân tích đúng.
Xử lý dữ liệu thiếu mà không làm sai ý nghĩa
Giá trị thiếu không phải một loại lỗi có cách xử lý duy nhất. Trước khi xóa hoặc điền, cần biết thiếu ở đâu, thiếu bao nhiêu, tập trung ở nhóm nào và vì sao có thể bị thiếu. Một tỷ lệ thiếu nhỏ nhưng dồn vào một phân khúc quan trọng có thể đáng lo hơn tỷ lệ thiếu lớn nhưng nằm ở trường không dùng cho phân tích.
Đánh giá mức độ và kiểu thiếu
Bước đầu tiên là đo tỷ lệ thiếu theo từng biến và theo các nhóm có ý nghĩa. Chẳng hạn, nếu một cột có 1.000 dòng và 50 ô trống, tỷ lệ thiếu của cột là 5%. Con số 5% chỉ mô tả mức độ thiếu; nó chưa cho biết nên xóa hay điền.
Quan trọng hơn là kiểm tra pattern. Nếu các ô thiếu xuất hiện rải rác và không liên quan rõ ràng đến nhóm quan sát, tác động có thể khác với trường hợp chúng chỉ xuất hiện ở một khu vực, một thời kỳ hoặc một nhóm khách hàng. Khi thiếu có tính hệ thống, việc chỉ điền một giá trị đại diện có thể che mất chính cơ chế đã tạo ra khoảng trống.
Không có một ngưỡng phần trăm thiếu duy nhất phù hợp cho mọi bộ dữ liệu. Quyết định phải phụ thuộc vào vai trò của biến, kích thước mẫu còn lại, nguyên nhân thiếu và mức độ nhạy của chỉ số cần phân tích.
Chọn giữ, xóa hay điền giá trị thiếu
Có ba nhóm lựa chọn cơ bản. Có thể giữ trạng thái thiếu nếu bản thân việc thiếu mang thông tin hoặc phương pháp phân tích có cách xử lý phù hợp; có thể xóa dòng hoặc biến khi phần thiếu khiến quan sát không còn sử dụng được và việc xóa không tạo lệch đáng kể; hoặc có thể điền giá trị khi có phương pháp và căn cứ phù hợp.
Không nên tự động biến giá trị thiếu thành 0. Số 0 là một giá trị có nghĩa, trong khi NULL/NA thường biểu thị “không có dữ liệu”. Cũng không nên mặc định điền trung bình cho mọi biến, vì thao tác này có thể làm giảm biến thiên và thay đổi mối quan hệ giữa các biến.
Sau xử lý, cần so sánh trước và sau: số dòng, tỷ lệ thiếu, phân phối của biến và các chỉ số quan trọng. Nếu một thao tác làm thay đổi mạnh kết quả nhưng không có lý do nghiệp vụ hoặc thống kê hợp lý, đó là tín hiệu cần xem lại quyết định làm sạch.
Phát hiện và xử lý dữ liệu trùng lặp
Dữ liệu trùng làm tăng trọng số của một số quan sát, nhưng “trùng” phải được định nghĩa theo đơn vị quan sát. Hai dòng giống hệt nhau có thể là lỗi sao chép; cũng có thể là hai sự kiện thực sự giống nhau. Vì vậy, deduplication cần bắt đầu từ khóa và ý nghĩa của bản ghi.
Xác định tiêu chí một bản ghi bị coi là trùng
Nếu mỗi dòng đại diện cho một khách hàng, mã khách hàng có thể là khóa duy nhất. Nếu mỗi dòng là một giao dịch, một khách hàng xuất hiện nhiều lần là bình thường; tiêu chí trùng có thể cần kết hợp mã giao dịch, thời điểm, số tiền và nguồn ghi nhận.
Có thể phân biệt trùng chính xác và trùng gần đúng. Trùng chính xác là các bản ghi giống nhau trên tập trường xác định. Trùng gần đúng xảy ra khi cùng một thực thể được ghi khác cách, chẳng hạn tên viết tắt, khác khoảng trắng hoặc khác định dạng số điện thoại. Với trùng gần đúng, việc gộp dữ liệu cần thận trọng hơn vì nguy cơ gộp nhầm hai thực thể khác nhau cao hơn.
Một kiểm tra định lượng đơn giản là đếm số khóa duy nhất so với tổng số dòng. Nếu dữ liệu có 10.000 dòng nhưng chỉ 9.850 khóa giao dịch duy nhất trong khi mỗi giao dịch theo thiết kế chỉ được xuất hiện một lần, có 150 dòng cần điều tra; chưa thể kết luận cả 150 đều phải xóa trước khi xác minh quy tắc.
Xóa, giữ hay gộp bản ghi trùng
Nếu xác định được một dòng là bản sao không mang thông tin mới, có thể giữ một bản và loại các bản sao theo quy tắc nhất quán. Nếu các dòng chứa thông tin bổ sung, có thể cần gộp trường thay vì xóa nguyên dòng. Nếu nhiều dòng đại diện cho các sự kiện độc lập, phải giữ lại dù chúng có nhiều giá trị giống nhau.
Sau deduplication, cần đối soát ít nhất số dòng, số khóa duy nhất và các tổng quan trọng. Nếu loại 150 dòng làm doanh thu giảm bất thường so với giá trị được xác định là trùng, tiêu chí có thể đã xóa nhầm giao dịch hợp lệ. Đây là lý do việc “Remove duplicates” theo toàn bộ dòng không nên được xem là quy tắc chung cho mọi bộ dữ liệu.
Sửa lỗi, định dạng không nhất quán và giá trị bất thường
Không phải mọi vấn đề chất lượng đều liên quan đến thiếu hoặc trùng. Dữ liệu còn có thể sai kiểu, dùng nhiều cách biểu diễn cho cùng một giá trị, nằm ngoài miền hợp lệ hoặc xuất hiện các điểm bất thường cần xác minh. Mức độ can thiệp nên tăng dần: chuẩn hóa cách biểu diễn thường ít rủi ro hơn thay đổi giá trị thực.
Chuẩn hóa kiểu dữ liệu và định dạng
Trước hết cần xác định schema mong đợi: trường nào là số, ngày, danh mục, mã định danh hoặc văn bản. Sau đó đưa các cách biểu diễn tương đương về cùng chuẩn, chẳng hạn thống nhất định dạng ngày, dấu phân cách thập phân, mã quốc gia, đơn vị đo hoặc cách viết danh mục.
Chuẩn hóa chỉ an toàn khi không làm mất nghĩa. Chuyển 1.500 thành 1,5 hoặc 1500 mà không biết quy ước dấu chấm là lỗi nghiêm trọng; tương tự, đổi toàn bộ chuỗi ngày theo một định dạng mà không xác định quy ước gốc có thể tạo ngày sai nhưng vẫn “hợp lệ” về mặt kỹ thuật.
Kiểm tra miền giá trị và tính nhất quán
Mỗi trường nên có rule hợp lệ tương ứng. Số lượng sản phẩm có thể không được âm; mã trạng thái chỉ được thuộc tập giá trị cho phép; ngày kết thúc không nên trước ngày bắt đầu nếu quy trình nghiệp vụ không cho phép; cùng một đơn vị đo phải được quy đổi trước khi so sánh.
Khi phát hiện giá trị vi phạm rule, ưu tiên kiểm tra nguồn hoặc dữ liệu liên quan trước khi tự suy đoán giá trị đúng. Nếu không thể xác minh, đánh dấu là không hợp lệ hoặc thiếu có kiểm soát thường an toàn hơn việc tự “sửa” theo giá trị có vẻ hợp lý.
Đánh giá outlier trước khi loại bỏ
Outlier là quan sát khác biệt mạnh so với phần lớn dữ liệu, nhưng sự khác biệt đó có thể là lỗi hoặc tín hiệu thật. Cần kiểm tra nguồn, đơn vị, bối cảnh thời gian và rule nghiệp vụ trước khi loại bỏ. Một đơn hàng lớn bất thường trong ngày khuyến mại có thể hoàn toàn hợp lệ; một nhiệt độ 500°C trong dữ liệu phòng điều hòa nhiều khả năng cần xác minh.
Có thể dùng các chỉ báo thống kê để gắn cờ outlier, nhưng ngưỡng thống kê không tự quyết định việc xóa. Khi giá trị hợp lệ nhưng ảnh hưởng mạnh đến chỉ số như trung bình, giải pháp có thể là báo cáo thêm trung vị, phân tích nhạy cảm hoặc tách nhóm—thay vì xóa dữ liệu thật. Mục tiêu là phân biệt representation error, validity error và quan sát hiếm nhưng hợp lệ.
Quy trình làm sạch dữ liệu trước khi phân tích
Một quy trình tốt giúp tránh sửa dữ liệu theo cảm tính và giúp người khác có thể tái hiện những gì đã thay đổi. Không có trạng thái “sạch tuyệt đối”; dữ liệu được xem là đủ sạch khi các vấn đề trọng yếu đối với mục đích phân tích đã được xử lý hoặc gắn cờ, các chỉ số chất lượng đã được kiểm tra và các thay đổi có thể truy vết.
Kiểm tra dữ liệu trước khi sửa
Trước khi thay đổi bất kỳ giá trị nào, cần tạo baseline để biết dữ liệu ban đầu có vấn đề gì. Các chỉ số tối thiểu nên gồm số dòng, số khóa duy nhất, tỷ lệ thiếu theo biến, số giá trị ngoài miền hợp lệ, kiểu dữ liệu và một số thống kê/phân phối chính. Việc lưu bản gốc hoặc snapshot giúp đối chiếu nếu một quy tắc làm sạch tạo tác dụng ngoài ý muốn.
Làm sạch theo quy tắc và mức ưu tiên
Nên xử lý theo mức ảnh hưởng đến phân tích, không theo mức độ “dễ sửa”. Một trình tự thực hành có thể là:
1. Xác định đơn vị quan sát, schema và rule hợp lệ
2. Chuẩn hóa kiểu dữ liệu, định dạng và đơn vị
3. Xử lý bản ghi trùng theo khóa và ngữ nghĩa
4. Đánh giá và xử lý giá trị thiếu
5. Kiểm tra giá trị ngoài miền và outlier
6. Ghi lại quy tắc, số bản ghi bị ảnh hưởng và lý do thay đổi
Thứ tự cụ thể có thể đổi khi các lỗi phụ thuộc nhau. Ví dụ, cần chuẩn hóa mã khách hàng trước khi phát hiện duplicate gần đúng; hoặc cần sửa đơn vị đo trước khi đánh giá outlier. Điều quan trọng là mỗi bước phải có điều kiện vào, thao tác và kiểm tra sau thao tác.
Xác thực lại trước khi bắt đầu phân tích
Sau cleaning, không nên chỉ nhìn vào việc “không còn lỗi”. Cần đối soát dữ liệu trước và sau bằng các chỉ số đã đặt ở baseline. Những kiểm tra hữu ích gồm:
· Số dòng và số khóa duy nhất
· Tỷ lệ missing theo biến và theo nhóm quan trọng
· Số bản ghi duplicate hoặc vi phạm uniqueness rule
· Số giá trị ngoài domain/range
· Tổng, trung bình, trung vị hoặc phân phối của các biến chính
· Các tổng đối soát quan trọng như doanh thu, số giao dịch hoặc số khách hàng
Nếu một chỉ số thay đổi mạnh, cần giải thích được thay đổi đó bằng rule làm sạch. Nếu không giải thích được, chưa nên coi bộ dữ liệu là sẵn sàng phân tích.
Tiêu chí dừng không phải “mọi ô đều hoàn hảo”. Bộ dữ liệu có thể vẫn còn missing hoặc outlier hợp lệ nhưng vẫn đủ điều kiện phân tích nếu những trường hợp đó đã được hiểu, xử lý phù hợp hoặc được mô hình phân tích chấp nhận. Đây cũng là cách tránh “làm sạch quá mức” và vô tình loại bỏ tín hiệu có giá trị.
Làm sạch dữ liệu cần diễn ra trước phân tích vì chất lượng đầu vào quyết định trực tiếp độ tin cậy của các phép tính và kết luận. Giá trị thiếu, bản ghi trùng, sai định dạng, giá trị ngoài miền hay outlier có thể làm thay đổi số đếm, tỷ lệ, trung bình, phân phối và quan hệ giữa các biến nếu không được phát hiện.
Một quy trình làm sạch tốt không xóa hoặc điền dữ liệu theo công thức cố định. Nó bắt đầu bằng profiling, đặt rule, xử lý có điều kiện, kiểm tra tác động trước–sau và lưu lại thay đổi. Khi các lỗi trọng yếu đã được xử lý hoặc gắn cờ, các chỉ số được đối soát và ý nghĩa dữ liệu vẫn được bảo toàn, bộ dữ liệu mới thực sự sẵn sàng cho bước phân tích.

GỬI Ý KIẾN BÌNH LUẬN

