
Data warehouse khác cơ sở dữ liệu vận hành như thế nào?
Mục lục
Data warehouse tập trung dữ liệu lịch sử để phân tích, còn cơ sở dữ liệu vận hành ưu tiên ghi nhận giao dịch nhanh và nhất quán. Bài viết giải thích khác biệt từ workload, mô hình dữ liệu đến cách triển khai thực tế.
Data warehouse là hệ thống dữ liệu được thiết kế chủ yếu cho truy vấn, tổng hợp và phân tích; cơ sở dữ liệu vận hành chủ yếu phục vụ các giao dịch phát sinh hằng ngày của ứng dụng. Vì hai workload này có yêu cầu trái ngược nhau, chúng thường được tối ưu theo những cách khác nhau về mô hình dữ liệu, kiểu đọc/ghi, dữ liệu lịch sử và cách sử dụng tài nguyên.
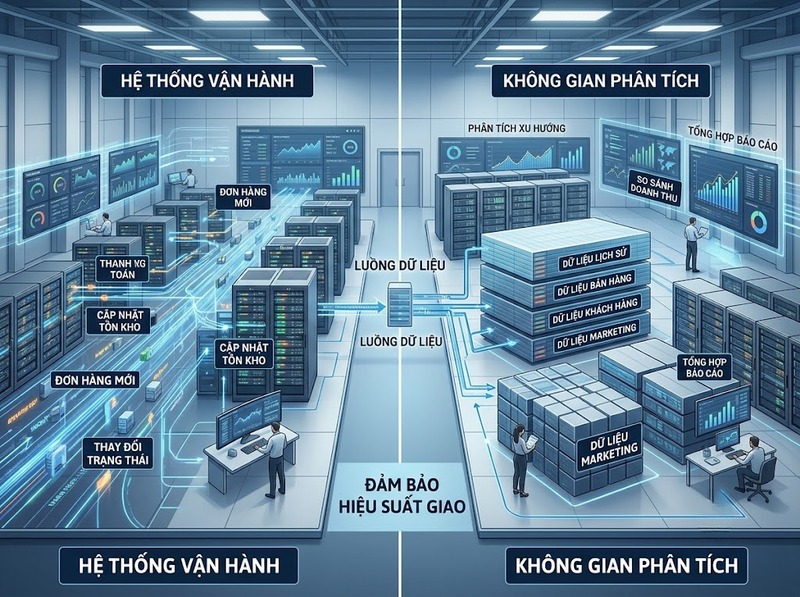
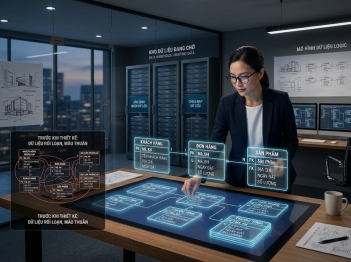
Data warehouse không đơn giản là một cơ sở dữ liệu “lớn hơn”. Nó thường nhận dữ liệu từ nhiều hệ thống nguồn, chuẩn hóa cách hiểu về khách hàng, sản phẩm, thời gian hoặc doanh thu, lưu lịch sử đủ dài để phân tích xu hướng và tách workload phân tích khỏi workload giao dịch.
Data warehouse là gì?
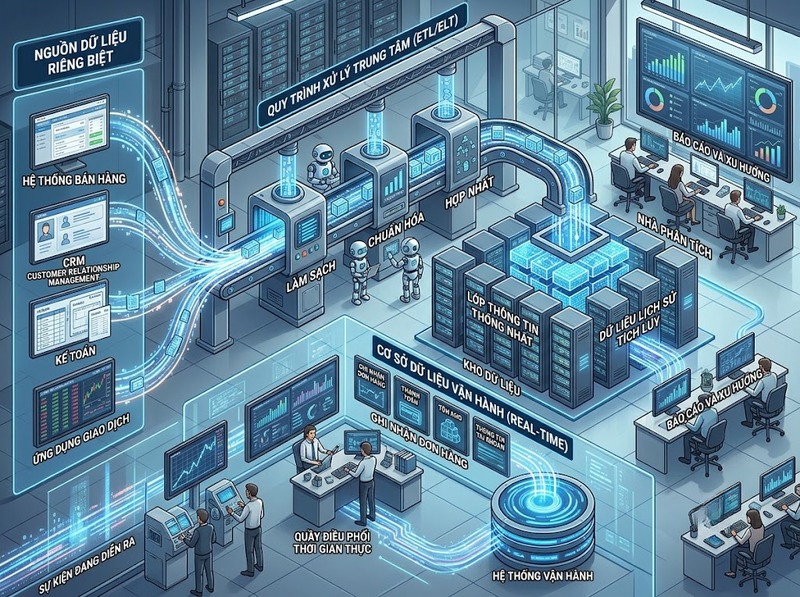
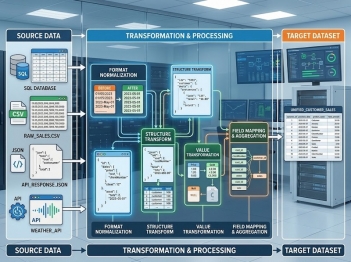
Trong tài liệu về data warehousing, Oracle mô tả data warehouse là cơ sở dữ liệu được thiết kế cho truy vấn và phân tích thay vì xử lý giao dịch. Dữ liệu thường đến từ các hệ thống giao dịch nhưng có thể được kết hợp với nhiều nguồn khác, sau đó được làm sạch, biến đổi và nạp vào kho qua các pipeline ETL hoặc ELT.
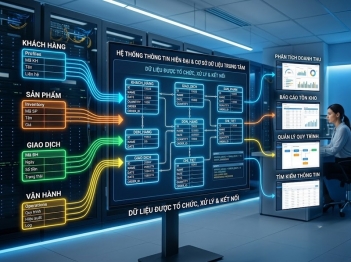
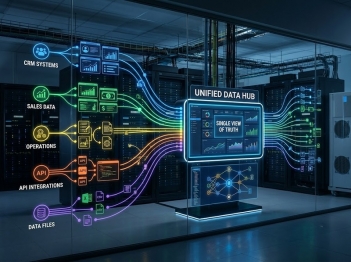
“Kho” ở đây không chỉ có nghĩa là nơi chứa dữ liệu. Giá trị của data warehouse nằm ở việc biến dữ liệu từ nhiều nguồn thành một lớp phân tích có cấu trúc và định nghĩa nhất quán. Một đơn hàng trong hệ thống bán hàng, dữ liệu khách hàng trong CRM và chi phí từ hệ thống kế toán có thể được liên kết theo cùng các khái niệm kinh doanh để người phân tích nhìn được doanh thu, biên lợi nhuận hoặc hành vi khách hàng theo thời gian.
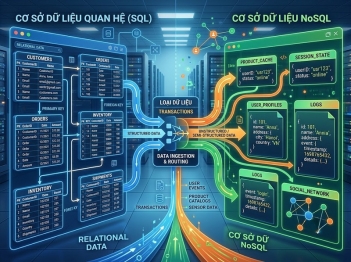
Cơ sở dữ liệu vận hành, thường gắn với OLTP (online transaction processing), có nhiệm vụ khác. Nó ghi nhận các sự kiện kinh doanh khi chúng xảy ra: tạo đơn hàng, thanh toán, cập nhật tồn kho, đổi trạng thái giao hàng hoặc sửa thông tin tài khoản. Ở đây, tốc độ phản hồi, tính nhất quán và khả năng xử lý nhiều giao dịch nhỏ đồng thời quan trọng hơn việc quét một lượng lớn lịch sử để tìm xu hướng.
Khác biệt cốt lõi giữa data warehouse và cơ sở dữ liệu vận hành
|
Tiêu chí |
Data warehouse |
Cơ sở dữ liệu vận hành / OLTP |
|
Mục đích chính |
Phân tích, BI, báo cáo, tìm xu hướng |
Ghi nhận và phục vụ giao dịch hằng ngày |
|
Kiểu workload |
Đọc nhiều, tổng hợp, join và truy vấn ad hoc |
Ghi/đọc liên tục trên các giao dịch nhỏ, thường đã biết trước |
|
Phạm vi dữ liệu |
Thường tích hợp nhiều nguồn và lưu lịch sử dài |
Tập trung vào trạng thái vận hành cần cho ứng dụng |
|
Kiểu truy vấn |
Quét nhiều hàng, nhóm, tính tổng, so sánh theo thời gian |
Tìm hoặc cập nhật một số ít bản ghi theo khóa/điều kiện cụ thể |
|
Cách cập nhật |
Thường qua pipeline ETL/ELT, batch, micro-batch hoặc streaming |
Ứng dụng cập nhật trực tiếp từng giao dịch |
|
Mô hình dữ liệu |
Thường dùng mô hình chiều, star schema hoặc mức phi chuẩn hóa phù hợp cho phân tích |
Thường chuẩn hóa cao để giảm dư thừa và bảo vệ tính nhất quán khi ghi |
|
Người dùng chính |
Analyst, BI, data team, nhà quản lý |
Ứng dụng nghiệp vụ, API, nhân viên vận hành, khách hàng |
|
Ưu tiên hiệu năng |
Throughput và thời gian phản hồi của truy vấn phân tích |
Độ trễ thấp, concurrency và độ tin cậy của giao dịch |
Sự khác biệt dễ thấy nhất nằm ở kích thước công việc mỗi truy vấn phải xử lý. Oracle đưa ra đối chiếu điển hình: một truy vấn kho dữ liệu có thể quét hàng nghìn hoặc hàng triệu hàng để tính tổng doanh số, trong khi một thao tác OLTP thường chỉ truy cập một số ít bản ghi, chẳng hạn lấy đơn hàng hiện tại của một khách hàng.
Cùng dùng SQL hoặc cùng chạy trên công nghệ cơ sở dữ liệu quan hệ không có nghĩa hai hệ thống có cùng vai trò. Thứ quyết định kiến trúc là workload cần phục vụ và các ưu tiên hiệu năng đi kèm.
Vì sao hai hệ thống được tối ưu khác nhau?
Workload giao dịch cần cập nhật nhỏ, nhanh và nhất quán
Một giao dịch thanh toán không được ở trạng thái “nửa thành công”. Hệ thống cần ghi đúng số tiền, cập nhật đúng trạng thái đơn hàng và đảm bảo các thay đổi liên quan tuân theo quy tắc nhất quán. OLTP vì thế thường dựa nhiều vào giao dịch ACID, chỉ mục phục vụ truy cập chọn lọc và mô hình dữ liệu chuẩn hóa.
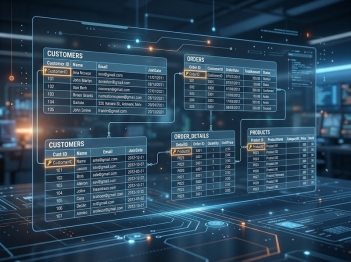
Chuẩn hóa chia dữ liệu thành các bảng có quan hệ rõ ràng, hạn chế lặp lại cùng một thông tin ở nhiều nơi. Khi địa chỉ khách hàng thay đổi, hệ thống không phải sửa hàng trăm bản ghi đơn hàng chỉ để đồng bộ một thuộc tính dùng chung. Cách tổ chức này phù hợp với insert, update và delete thường xuyên, nhưng các câu hỏi phân tích có thể cần nhiều phép join hơn.
Workload phân tích cần quét và tổng hợp trên tập dữ liệu lớn
Một câu hỏi như “doanh thu theo khu vực, nhóm sản phẩm và tháng trong ba năm gần nhất thay đổi ra sao?” có mô hình truy cập hoàn toàn khác. Hệ thống phải đọc nhiều dữ liệu, nhóm theo nhiều chiều, tính toán chỉ số và đôi khi kết hợp dữ liệu từ nhiều nguồn.
Data warehouse thường tổ chức dữ liệu để giảm chi phí của kiểu truy vấn này. Mô hình star schema có thể đặt các số đo kinh doanh trong bảng fact và các thuộc tính mô tả trong bảng dimension, giúp truy vấn phân tích đi theo các quan hệ dễ dự đoán hơn. Việc nạp dữ liệu theo lô hoặc qua pipeline cũng cho phép làm sạch, chuẩn hóa mã, xử lý bản ghi trùng và tính sẵn một số dữ liệu cần cho báo cáo trước khi người dùng truy vấn.
Tách workload phân tích còn bảo vệ hệ thống vận hành. Microsoft Azure Architecture Center lưu ý rằng các truy vấn tổng hợp trên hàng triệu giao dịch có thể rất tốn tài nguyên đối với OLTP, chạy chậm và thậm chí làm các giao dịch khác chậm theo do cạnh tranh hoặc khóa tài nguyên. Chuyển workload phân tích nặng sang kho dữ liệu giúp ứng dụng giao dịch không phải chia sẻ cùng một tài nguyên với các truy vấn quét lớn.
Không nên dùng ACID như ranh giới tuyệt đối giữa hai loại hệ thống. Một số data warehouse hiện đại vẫn hỗ trợ transaction; khác biệt cốt lõi vẫn là loại workload mà hệ thống được thiết kế để phục vụ và tối ưu.
Dữ liệu đi từ OLTP sang data warehouse như thế nào?
Hãy lấy một hệ thống thương mại điện tử làm ví dụ. Khi khách đặt hàng, cơ sở dữ liệu OLTP phải ghi đơn hàng, dòng sản phẩm, thanh toán và trạng thái tồn kho gần như ngay lập tức để ứng dụng tiếp tục xử lý. Đây là dữ liệu phục vụ hoạt động hiện tại.
Sau đó, pipeline dữ liệu lấy những thay đổi cần thiết từ hệ thống nguồn. Trong bước biến đổi, dữ liệu có thể được chuẩn hóa về mã sản phẩm, múi giờ, đơn vị tiền tệ hoặc quy tắc phân loại khách hàng; các bản ghi từ CRM, hệ thống bán hàng và kế toán cũng có thể được đối chiếu để dùng chung định nghĩa. Dữ liệu đã xử lý được nạp vào data warehouse theo cấu trúc phù hợp với báo cáo và phân tích.
Khi analyst hỏi doanh thu theo khu vực trong 36 tháng, truy vấn chạy trên lớp dữ liệu đã tích hợp thay vì yêu cầu hệ thống đặt hàng quét toàn bộ lịch sử giao dịch. Phân tích nhờ đó có dữ liệu lịch sử nhất quán hơn, còn ứng dụng vận hành không bị biến thành nền tảng BI bất đắc dĩ.
Kho dữ liệu không nhất thiết chỉ được cập nhật mỗi đêm. Pipeline hiện đại có thể nạp theo micro-batch, change data capture hoặc streaming để rút ngắn độ trễ. “Data warehouse là dữ liệu cũ” vì thế không phải là định nghĩa đúng; độ tươi dữ liệu là lựa chọn kiến trúc. Khác biệt bền vững hơn nằm ở cách hệ thống phục vụ phân tích thay vì xử lý từng giao dịch nghiệp vụ.
Tương tự, tính “nonvolatile” của kho dữ liệu không nên hiểu là dữ liệu tuyệt đối bất biến. Dữ liệu có thể được sửa do hoàn tiền, điều chỉnh kế toán, sửa lỗi nguồn hoặc cập nhật logic nghiệp vụ. Ý cốt lõi là người dùng phân tích thường không thực hiện CRUD từng bản ghi như trong OLTP; thay đổi được quản lý qua pipeline và quy trình dữ liệu có kiểm soát.
Khi nào nên tách data warehouse khỏi cơ sở dữ liệu giao dịch?
Việc tách riêng trở nên có giá trị khi phân tích bắt đầu có nhu cầu khác rõ rệt với vận hành. Những tín hiệu thường gặp gồm:
· Báo cáo phải quét, join hoặc tổng hợp trên khối lượng giao dịch lớn và làm ảnh hưởng thời gian phản hồi của ứng dụng
· Doanh nghiệp cần hợp nhất dữ liệu từ nhiều hệ thống thay vì chỉ phân tích một cơ sở dữ liệu nguồn
· Các câu hỏi cần lịch sử nhiều tháng hoặc nhiều năm để so sánh xu hướng
· Nhiều nhóm sử dụng BI cần cùng định nghĩa về doanh thu, khách hàng, sản phẩm hoặc thời gian
· Workload phân tích tăng độc lập với workload giao dịch và cần được mở rộng tài nguyên riêng
Ngược lại, một ứng dụng nhỏ chỉ có báo cáo vận hành đơn giản chưa chắc cần data warehouse riêng. Nếu truy vấn nhẹ, dữ liệu nằm trong một nguồn và không ảnh hưởng giao dịch, báo cáo trực tiếp trên OLTP hoặc trên read replica có thể đủ. Tách hệ thống quá sớm cũng tạo thêm pipeline, chi phí vận hành, giám sát chất lượng dữ liệu và độ trễ đồng bộ mà bài toán chưa chắc cần.
Sự phân tách OLTP và phân tích cũng không phải luật tuyệt đối. Các kiến trúc HTAP cố gắng phục vụ cả giao dịch và phân tích trên cùng nền tảng hoặc trên các lớp dữ liệu được đồng bộ rất chặt. Tuy nhiên, ngay cả khi công nghệ cho phép kết hợp, đội ngũ vẫn phải đánh giá hai loại workload theo cùng các câu hỏi: giao dịch cần độ trễ và tính nhất quán đến mức nào, truy vấn phân tích phải quét bao nhiêu dữ liệu, và một workload có thể làm suy giảm workload kia hay không.
Data warehouse vì thế không thay thế cơ sở dữ liệu vận hành. Hai hệ thống giải quyết hai nhiệm vụ bổ sung cho nhau: OLTP ghi nhận “điều gì đang xảy ra với giao dịch này”, còn data warehouse giúp trả lời “điều gì đã xảy ra trên toàn bộ dữ liệu theo thời gian, theo những chiều nào và với xu hướng ra sao”.
Nếu chỉ cần một nguyên tắc để phân biệt, hãy nhìn vào workload thay vì tên sản phẩm. Cơ sở dữ liệu vận hành được tối ưu để giao dịch nhỏ diễn ra nhanh, đúng và liên tục; data warehouse được tối ưu để nhiều dữ liệu có thể được tích hợp, lưu theo thời gian và truy vấn sâu mà không gây áp lực không cần thiết lên hệ thống giao dịch.
Trong kiến trúc thực tế, OLTP thường là nơi ghi nhận trạng thái nghiệp vụ hiện hành, còn data warehouse là lớp phục vụ phân tích từ dữ liệu đã được tập hợp và chuẩn hóa. Khi báo cáo bắt đầu cạnh tranh tài nguyên với giao dịch, cần lịch sử dài hoặc phải hợp nhất nhiều nguồn, đó là dấu hiệu rõ nhất cho thấy hai workload nên được tách và tối ưu theo mục tiêu riêng.

GỬI Ý KIẾN BÌNH LUẬN

