
Xử lý ngôn ngữ tự nhiên giúp máy hiểu ngôn ngữ thế nào?
Mục lục
Xử lý ngôn ngữ tự nhiên biến câu chữ thành dữ liệu số, học quan hệ ngữ cảnh và dùng mô hình để phân tích hoặc tạo ngôn ngữ; bài viết cũng làm rõ giới hạn của khái niệm “máy hiểu”.
Xử lý ngôn ngữ tự nhiên, thường viết tắt là NLP từ Natural Language Processing, là lĩnh vực giúp máy tính làm việc với ngôn ngữ con người dưới dạng văn bản hoặc lời nói đã được chuyển thành dữ liệu. Máy không nhận một câu theo cách con người “nghe là hiểu”; hệ thống phải biến câu thành các đơn vị có thể tính toán, biểu diễn chúng bằng số, xác định quan hệ trong ngữ cảnh rồi dự đoán đầu ra phù hợp với nhiệm vụ.
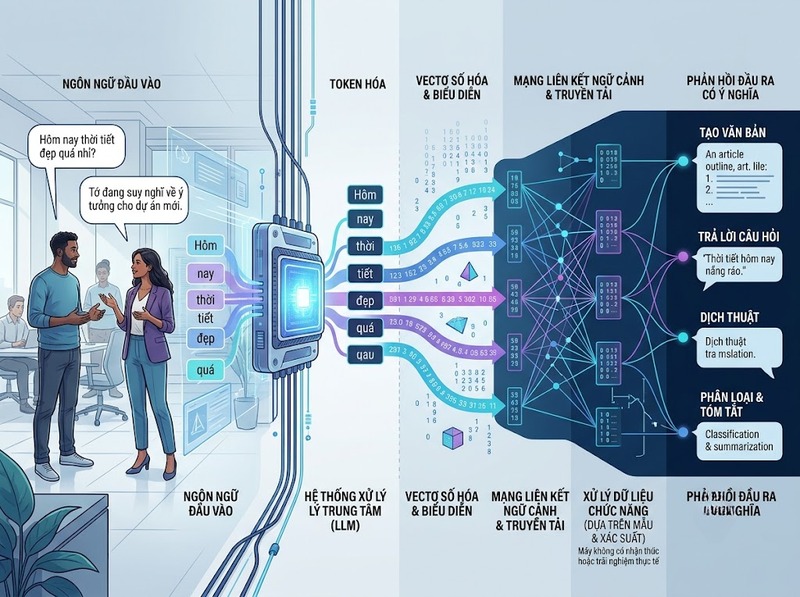
Vì vậy, “máy hiểu ngôn ngữ” nên được hiểu theo nghĩa chức năng: mô hình nhận ra đủ cấu trúc, ý định và quan hệ ngữ nghĩa để phân loại, trích xuất, dịch, trả lời hoặc tạo văn bản. Khả năng đó có thể rất mạnh nhưng không đồng nghĩa với việc máy có trải nghiệm, tri thức nền và cách hiểu thế giới giống con người.
Xử lý ngôn ngữ tự nhiên là gì?
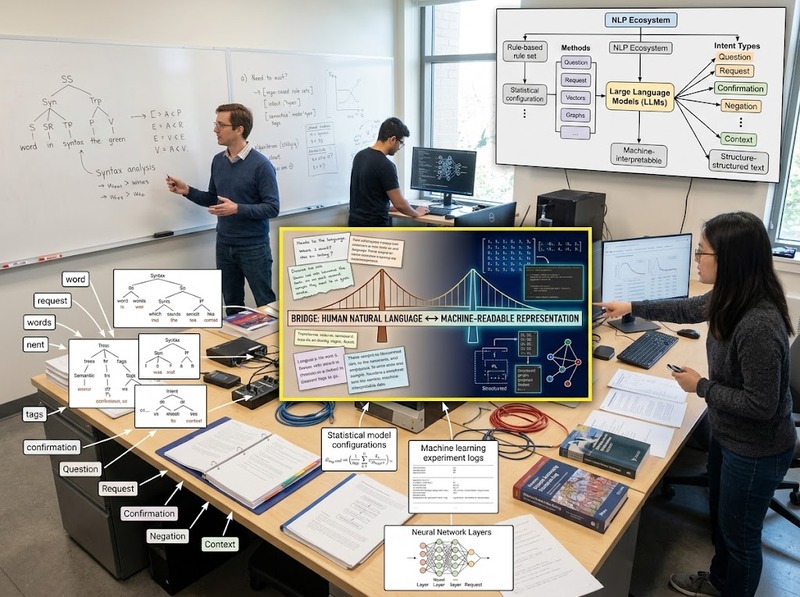
NLP nằm ở giao điểm giữa ngôn ngữ học, khoa học máy tính và trí tuệ nhân tạo. Đối tượng của nó không chỉ là từ riêng lẻ mà còn là cách từ kết hợp thành câu, cách câu thay đổi nghĩa theo ngữ cảnh và cách một phát ngôn thực hiện một mục đích như hỏi, yêu cầu, xác nhận hay phủ định. Các tài liệu nền tảng của lĩnh vực, chẳng hạn giáo trình Speech and Language Processing của Daniel Jurafsky và James H. Martin, tiếp cận NLP qua các bài toán biểu diễn, phân tích, mô hình hóa và sinh ngôn ngữ.
Một hệ thống NLP có thể được xây dựng bằng quy tắc, mô hình thống kê, học máy hoặc mạng nơ-ron. Trong các hệ thống hiện đại, mô hình thường học từ lượng lớn dữ liệu ngôn ngữ để tìm các mẫu liên hệ giữa đơn vị ngôn ngữ và đầu ra cần dự đoán. Điều quan trọng là NLP không phải một mô hình duy nhất, còn mô hình ngôn ngữ lớn chỉ là một nhóm công nghệ nằm trong phạm vi rộng hơn của NLP.
Giá trị cốt lõi của NLP nằm ở việc thu hẹp khoảng cách giữa hai dạng biểu diễn: ngôn ngữ tự nhiên vốn linh hoạt, mơ hồ và phụ thuộc ngữ cảnh; máy tính lại cần dữ liệu có cấu trúc số để thực hiện phép tính. Toàn bộ cơ chế “hiểu” bắt đầu từ bước chuyển đổi này.
Máy biến câu chữ thành dữ liệu có thể tính toán ra sao?
Trước hết, văn bản được chuẩn hóa và chia thành các đơn vị xử lý gọi là token. Token có thể là một từ, một phần của từ, dấu câu hoặc ký hiệu, tùy cách mô hình được thiết kế. Vì vậy, một token không phải lúc nào cũng tương ứng với một từ hoàn chỉnh. Khi dùng token con (subword), cách chia này giúp hệ thống xử lý nhiều từ mới hoặc biến thể cấu tạo từ mà không cần lưu mọi từ như một mục từ riêng biệt.
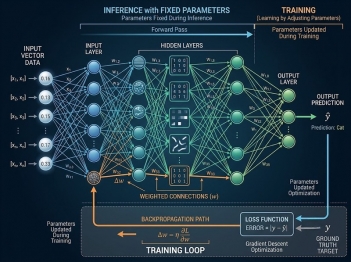
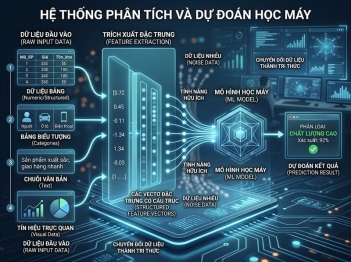
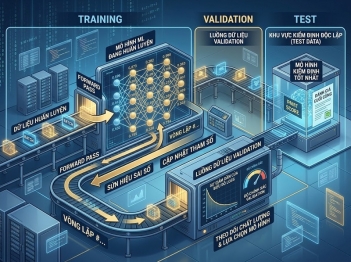
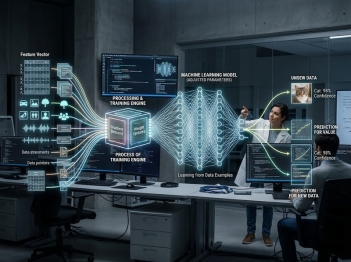
Sau đó, mỗi token được ánh xạ thành một vector số. Vector không mang “nghĩa” theo kiểu định nghĩa trong từ điển; nó là một biểu diễn toán học cho phép mô hình đặt các đơn vị ngôn ngữ vào không gian nhiều chiều và học quan hệ giữa chúng. Trong quá trình huấn luyện, các tham số được điều chỉnh theo một mục tiêu học cụ thể. Mục tiêu đó có thể là dự đoán token bị che, token tiếp theo hoặc nhãn do dữ liệu huấn luyện cung cấp. Qua nhiều lần cập nhật, biểu diễn số trở nên hữu ích hơn cho việc dự đoán từ, nhãn, quan hệ hoặc chuỗi đầu ra.
Vị trí cũng phải được mã hóa, bởi “chó cắn người” và “người cắn chó” có cùng tập từ nhưng quan hệ hoàn toàn khác. Khi thông tin về token, vị trí và ngữ cảnh được kết hợp, câu chữ mới trở thành dạng dữ liệu mà mô hình có thể xử lý bằng các phép toán trên ma trận và vector.
Mô hình xác định nghĩa và ngữ cảnh như thế nào?
Nghĩa của một từ thường phụ thuộc vào những gì đứng trước, đứng sau và mục đích của cả câu. Từ “bàn” trong “đặt bàn ở nhà hàng” không được giải thích giống “bàn về kế hoạch”. Nếu chỉ tra một nghĩa cố định cho từng từ, hệ thống sẽ dễ sai ngay khi gặp đa nghĩa, phủ định, tham chiếu hoặc câu có cấu trúc phức tạp.
Các mô hình nơ-ron hiện đại giải quyết vấn đề này bằng cách xây dựng biểu diễn phụ thuộc ngữ cảnh. Với kiến trúc Transformer, cơ chế attention — thành phần trung tâm trong công trình Attention Is All You Need của Vaswani và cộng sự — cho phép mô hình tính mức ảnh hưởng tương đối giữa các token trong cùng chuỗi. Nhờ đó, biểu diễn của một token được cập nhật dựa trên các phần khác của câu thay vì được xử lý như một đơn vị độc lập.
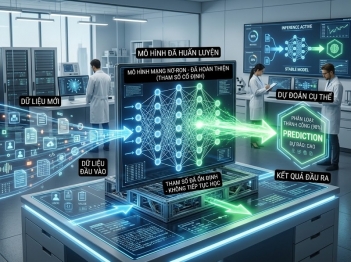
Mô hình không cần dựng một “bản dịch sang ý nghĩ” tách biệt trước khi trả lời. Qua huấn luyện, nó học các tham số làm cho những quan hệ ngôn ngữ hữu ích xuất hiện trong biểu diễn nội bộ: từ nào thường liên hệ với thực thể nào, cấu trúc nào báo hiệu phủ định, phần nào của câu có khả năng là chủ thể, và ngữ cảnh nào khiến một nghĩa phù hợp hơn nghĩa khác. Tùy nhiệm vụ, biểu diễn đó được chuyển thành một nhãn, một đoạn trích xuất, một chuỗi dịch hoặc xác suất cho token tiếp theo.
Cơ chế này mạnh ở việc khai thác mẫu thống kê và quan hệ theo ngữ cảnh, nhưng vẫn có biên giới. Khi câu cần tri thức đời sống chưa có trong dữ liệu, chứa hàm ý tinh tế hoặc cố ý đánh lừa bằng cấu trúc lạ, mô hình có thể chọn một diễn giải hợp lý về mặt thống kê nhưng sai với ý người nói.
NLP phân tích và tạo ngôn ngữ bằng những cơ chế nào?
Ở phía phân tích, mô hình biến biểu diễn ngữ cảnh thành quyết định. Với phân loại văn bản, đầu ra có thể là nhãn chủ đề hoặc cảm xúc. Với nhận dạng thực thể, mô hình gán nhãn cho từng đoạn để xác định tên người, địa điểm hay tổ chức. Với hỏi đáp trích xuất, hệ thống có thể chọn đoạn văn bản có khả năng chứa câu trả lời. Điểm chung là mô hình không thao tác trực tiếp trên chữ, mà thao tác trên biểu diễn số đã học.
Ở phía tạo ngôn ngữ, mô hình sinh chuỗi từng bước. Một mô hình ngôn ngữ dự đoán phân bố xác suất của token tiếp theo dựa trên ngữ cảnh đã có; quá trình giải mã chọn một token từ phân bố đó, rồi token vừa chọn trở thành một phần của ngữ cảnh cho bước kế tiếp. Lặp quá trình này tạo thành câu hoặc đoạn văn. Các điều kiện như câu hỏi, chỉ dẫn, tài liệu tham chiếu hay lịch sử hội thoại có thể làm thay đổi phân bố xác suất và do đó thay đổi nội dung được sinh.
Ví dụ, với câu “Đặt vé từ Hà Nội đi Đà Nẵng sáng mai”, một hệ thống có thể nhận ra ý định đặt vé và trích xuất nơi đi, nơi đến, thời gian từ cùng biểu diễn ngữ cảnh. Cùng một nền tảng biểu diễn có thể phục vụ cả phân tích lẫn tạo ngôn ngữ, nhưng hai nhiệm vụ không hoàn toàn giống nhau. Phân tích thường cần ánh xạ đầu vào vào một nhãn hoặc cấu trúc tương đối xác định; sinh văn bản phải lựa chọn giữa nhiều chuỗi đều có thể hợp ngữ pháp. Chính không gian lựa chọn rộng này khiến văn bản sinh ra có thể trôi chảy nhưng vẫn chứa chi tiết không được dữ liệu hoặc ngữ cảnh hỗ trợ.
“Máy hiểu ngôn ngữ” khác cách con người hiểu ở đâu?
Con người thường gắn câu chữ với trải nghiệm giác quan, mục tiêu giao tiếp, ký ức, quan hệ xã hội và tri thức về thế giới. Một hệ thống NLP chủ yếu suy luận từ biểu diễn dữ liệu và các mẫu đã học. Nó có thể mô hình hóa nhiều quan hệ ngữ nghĩa rất tốt mà không cần sở hữu trải nghiệm chủ quan tương ứng.
Vì vậy, không nên đánh đồng độ trôi chảy với độ đúng. Một mô hình có thể tạo câu tự nhiên vì nó dự đoán chuỗi ngôn ngữ tốt, nhưng câu đó vẫn có thể sai sự thật, bỏ sót điều kiện hoặc hiểu nhầm tham chiếu. Đây là lý do các hệ thống NLP cần dữ liệu phù hợp với miền sử dụng, ngữ cảnh đủ rõ và cơ chế kiểm tra đầu ra khi nhiệm vụ đòi hỏi độ chính xác cao.
Một giới hạn khác là tính phụ thuộc phân phối dữ liệu. Nếu dữ liệu huấn luyện không đại diện cho kiểu ngôn ngữ, phương ngữ, thuật ngữ chuyên môn hoặc tình huống mà hệ thống gặp khi vận hành, chất lượng có thể giảm. “Hiểu” trong NLP vì thế là khả năng thực hiện nhiệm vụ ngôn ngữ trong những điều kiện nhất định, không phải một tuyên bố rằng máy có năng lực nhận thức giống con người.
Làm sao biết một hệ thống NLP đang hiểu đúng nhiệm vụ?
Không có một chỉ số duy nhất đo được “mức hiểu ngôn ngữ” cho mọi bài toán. Đánh giá phải gắn với nhiệm vụ cụ thể. Với phân loại, người ta có thể dùng accuracy, precision, recall hoặc F1; với trích xuất thực thể thường quan tâm precision, recall và F1; với một số bài toán dịch hoặc sinh văn bản có thể dùng các thước đo tự động như BLEU hoặc ROUGE. Mỗi chỉ số chỉ phản ánh một phần hành vi của hệ thống. Thước đo tự động có ưu điểm là nhất quán và dễ áp dụng trên nhiều mẫu, nhưng có thể bỏ sót khác biệt quan trọng về ý nghĩa.
Với nội dung mở, đánh giá của con người vẫn quan trọng vì một câu có thể gần đáp án tham chiếu về mặt từ vựng nhưng sai ý, hoặc khác cách diễn đạt mà vẫn hoàn toàn đúng. Đổi lại, đánh giá thủ công tốn nguồn lực hơn và phụ thuộc vào tiêu chí cũng như mức nhất quán giữa người chấm. Các tiêu chí như tính liên quan, nhất quán, độ chính xác sự thật và mức tuân thủ chỉ dẫn thường cần được xem xét riêng. Kiểm thử trên câu mơ hồ, dữ liệu ngoài phân phối hoặc ngữ cảnh thiếu cũng giúp phát hiện giới hạn mà điểm trung bình trên bộ dữ liệu quen thuộc có thể che khuất.
Do đó, bằng chứng tốt nhất cho việc một hệ thống NLP “hiểu” không phải là câu trả lời nghe tự nhiên, mà là khả năng duy trì hiệu năng trên tiêu chí phù hợp, trong điều kiện đã xác định, và giảm lỗi khi ngữ cảnh thay đổi theo cách có thể dự đoán.
Xử lý ngôn ngữ tự nhiên giúp máy làm việc với ngôn ngữ bằng một chuỗi chuyển đổi: tách và mã hóa câu chữ thành biểu diễn số, học quan hệ giữa các đơn vị trong ngữ cảnh, rồi dùng biểu diễn đó để phân tích hoặc sinh đầu ra. Máy có thể nắm bắt cấu trúc và quan hệ ngữ nghĩa đủ tốt để hoàn thành nhiều nhiệm vụ, nhưng “hiểu” ở đây là năng lực vận hành có thể kiểm chứng, không đồng nghĩa với trải nghiệm nhận thức của con người. Muốn đánh giá một hệ thống NLP đáng tin đến đâu, cần nhìn vào nhiệm vụ, dữ liệu, điều kiện sử dụng và bằng chứng đo lường phù hợp.

GỬI Ý KIẾN BÌNH LUẬN

