
Học sâu khác học máy truyền thống như thế nào?
Mục lục
- Học sâu là gì và nằm ở đâu trong học máy?
- Khác biệt lớn nhất: ai tạo ra đặc trưng?
- Học sâu và học máy truyền thống khác nhau về mô hình, dữ liệu và tài nguyên thế nào?
- Vì sao học sâu thường cần nhiều dữ liệu và sức mạnh tính toán hơn?
- Khi nào nên dùng học sâu thay vì học máy truyền thống?
- Học sâu có phải lúc nào cũng chính xác và tốt hơn học máy truyền thống?
Học sâu là gì, hoạt động như thế nào và khác học máy truyền thống ở đâu? Bài viết phân biệt hai phương pháp qua cách học đặc trưng, kiến trúc mô hình, dữ liệu, tài nguyên tính toán và trường hợp ứng dụng
Học sâu là một nhánh của học máy sử dụng các mạng nơ-ron nhiều lớp để học biểu diễn và tìm quy luật trực tiếp từ dữ liệu. Điểm khác biệt quan trọng nhất so với học máy truyền thống không đơn giản nằm ở việc mô hình “phức tạp hơn”, mà ở cách mô hình xử lý đặc trưng của dữ liệu.
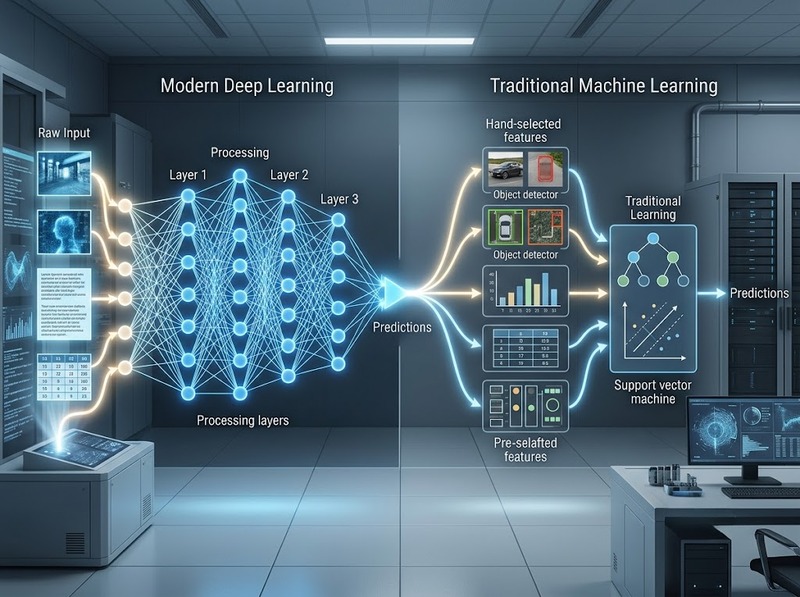
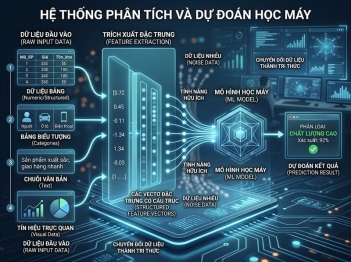
Với nhiều thuật toán học máy truyền thống, con người thường phải lựa chọn hoặc thiết kế đặc trưng trước khi đưa dữ liệu vào mô hình. Học sâu có khả năng học nhiều tầng biểu diễn từ dữ liệu thô, nhờ đó giảm đáng kể phần đặc trưng phải thiết kế thủ công. Đổi lại, mô hình học sâu thường cần nhiều dữ liệu, năng lực tính toán và thời gian huấn luyện hơn.
Học sâu là gì và nằm ở đâu trong học máy?
Học sâu (Deep Learning) là một phương pháp thuộc lĩnh vực học máy (Machine Learning). Học máy lại nằm trong phạm vi rộng hơn của trí tuệ nhân tạo.
Quan hệ này có thể hình dung như sau:
Trí tuệ nhân tạo → Học máy → Học sâu
Học máy cho phép hệ thống tìm quy luật từ dữ liệu thay vì phải lập trình từng quy tắc cụ thể. Học sâu thực hiện điều đó bằng các mạng nơ-ron nhân tạo có nhiều lớp xử lý.
Điểm đáng chú ý là mỗi lớp trong mạng có thể học một dạng biểu diễn khác nhau. Với dữ liệu hình ảnh, chẳng hạn, các lớp đầu có thể học những mẫu đơn giản như cạnh hoặc đường nét, trong khi các lớp sâu hơn kết hợp chúng thành hình dạng và đặc điểm phức tạp hơn.
Vì vậy, “sâu” trong học sâu chủ yếu đề cập đến chiều sâu của mạng nơ-ron, tức số lượng lớp biến đổi biểu diễn dữ liệu, chứ không chỉ nói đến độ khó của bài toán.
Trong học máy truyền thống, các mô hình như hồi quy tuyến tính, logistic regression, cây quyết định, random forest hoặc các phương pháp dựa trên vector đặc trưng thường được xây dựng trên những đặc trưng đã được lựa chọn hoặc biến đổi trước.
Đây là khác biệt nền tảng để hiểu vì sao hai nhóm phương pháp có yêu cầu dữ liệu và tài nguyên rất khác nhau.
Khác biệt lớn nhất: ai tạo ra đặc trưng?
Đặc trưng (feature) là những thông tin mà mô hình sử dụng để tìm quan hệ giữa đầu vào và đầu ra.
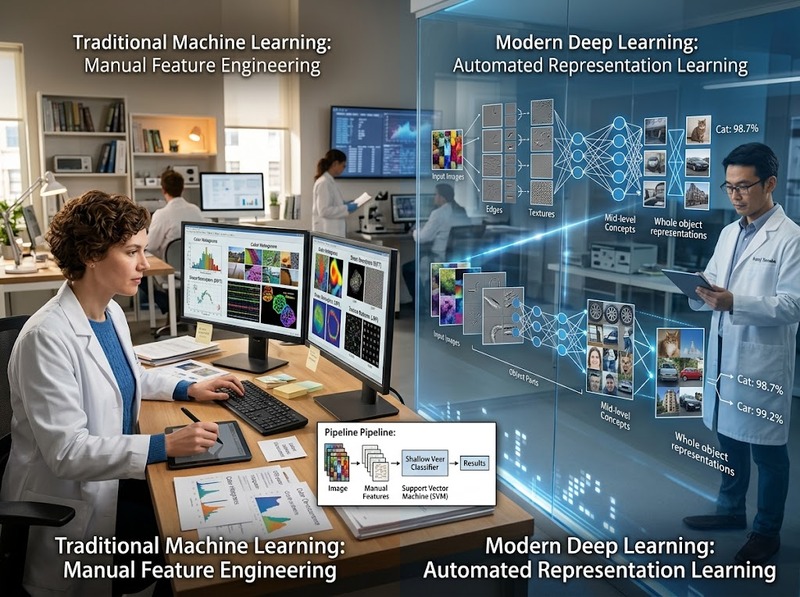
Giả sử cần xây dựng hệ thống phân loại ảnh chó và mèo. Với cách tiếp cận học máy truyền thống, người phát triển có thể phải tìm cách biểu diễn ảnh bằng các đặc trưng như màu sắc, hình dạng, kết cấu hoặc các đặc điểm được trích xuất bằng một phương pháp riêng. Mô hình sau đó học cách kết hợp những đặc trưng này để đưa ra dự đoán.
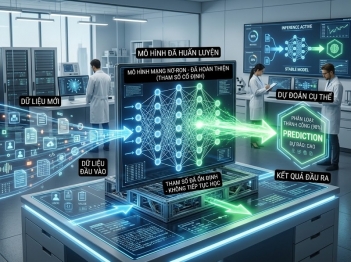
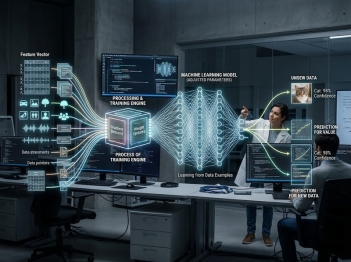
Học sâu thay đổi quy trình đó. Mạng nơ-ron có thể học trực tiếp từ dữ liệu ảnh và tự hình thành các biểu diễn trung gian qua nhiều lớp.
Cơ chế có thể khái quát như sau:
Dữ liệu thô → Đặc trưng cấp thấp → Đặc trưng cấp cao → Dự đoán
Nhờ vậy, phần “thiết kế đặc trưng” được chuyển một phần từ con người sang quá trình tối ưu mô hình.
Tuy nhiên, điều này không có nghĩa học sâu hoàn toàn không cần con người can thiệp. Con người vẫn phải xác định dữ liệu đầu vào, cách gán nhãn, kiến trúc mô hình, hàm mất mát, quy trình huấn luyện và nhiều siêu tham số khác.
Khác biệt chính là mức độ tự động hóa việc học biểu diễn, chứ không phải con người biến mất khỏi quá trình xây dựng mô hình.
Học sâu và học máy truyền thống khác nhau về mô hình, dữ liệu và tài nguyên thế nào?
|
Tiêu chí |
Học máy truyền thống |
Học sâu |
|
Cách học đặc trưng |
Thường cần thiết kế hoặc lựa chọn đặc trưng |
Có thể tự học biểu diễn qua nhiều lớp |
|
Kiến trúc |
Thường đơn giản hơn |
Thường gồm nhiều lớp mạng nơ-ron |
|
Dữ liệu |
Có thể hoạt động tốt với tập dữ liệu vừa và nhỏ tùy bài toán |
Thường phát huy rõ hơn khi có nhiều dữ liệu |
|
Tài nguyên tính toán |
Thường thấp hơn |
Thường cao hơn, đặc biệt khi huấn luyện mô hình lớn |
|
Tiền xử lý |
Có thể đóng vai trò rất quan trọng |
Có thể giảm một phần công việc thiết kế đặc trưng thủ công |
|
Khả năng xử lý dữ liệu phi cấu trúc |
Tùy thuật toán và cách biểu diễn dữ liệu |
Đặc biệt mạnh với ảnh, âm thanh, văn bản và video |
|
Khả năng giải thích |
Một số mô hình tương đối dễ diễn giải |
Nhiều mạng sâu khó diễn giải trực tiếp hơn |
|
Thời gian huấn luyện |
Thường ngắn hơn với mô hình và dữ liệu vừa phải |
Có thể dài hơn đáng kể khi mô hình lớn |
|
Quy mô mô hình |
Thường nhỏ hơn |
Có thể rất lớn với nhiều tham số |
Sự khác biệt về dữ liệu cần được hiểu theo điều kiện. Học sâu không phải lúc nào cũng cần nhiều dữ liệu hơn mọi thuật toán học máy truyền thống. Một mô hình học sâu được huấn luyện từ đầu thường cần lượng dữ liệu đáng kể để học biểu diễn tốt, nhưng transfer learning có thể cho phép tận dụng một mô hình đã được huấn luyện trước và thích nghi với tập dữ liệu nhỏ hơn.
Ngược lại, với một bài toán dữ liệu có cấu trúc và kích thước vừa phải, một thuật toán học máy truyền thống có thể đạt kết quả tốt mà không cần mạng nơ-ron sâu.
Vì sao học sâu thường cần nhiều dữ liệu và sức mạnh tính toán hơn?
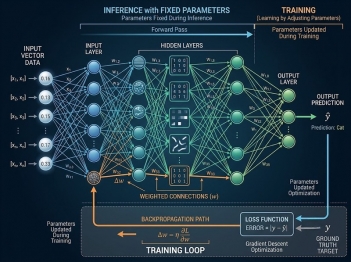
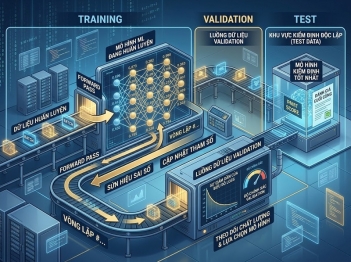
Mạng nơ-ron sâu có nhiều lớp và có thể chứa lượng lớn tham số. Trong quá trình huấn luyện, các tham số này được điều chỉnh liên tục để giảm sai số giữa dự đoán của mô hình và kết quả mong muốn.
Một cách đơn giản hóa quá trình là:
Dữ liệu đầu vào → Lan truyền qua nhiều lớp → Dự đoán → Tính sai số → Cập nhật tham số → Lặp lại
Số lượng phép tính tăng lên khi mô hình có nhiều lớp, nhiều tham số và được huấn luyện trên lượng dữ liệu lớn. Vì vậy, GPU hoặc các bộ xử lý tăng tốc thường được sử dụng để rút ngắn thời gian huấn luyện.
Nhu cầu dữ liệu cũng xuất phát từ khả năng biểu diễn của mô hình. Một mạng có năng lực học rất lớn có thể tìm được những quy luật phức tạp, nhưng nếu dữ liệu huấn luyện không đủ hoặc không đại diện cho dữ liệu thực tế, mô hình có thể học sai mẫu hoặc quá khớp.
Đây là một trade-off quan trọng:
· Mô hình lớn hơn có thể biểu diễn quan hệ phức tạp hơn
· Dữ liệu nhiều và đa dạng hơn giúp mô hình học những quy luật có khả năng tổng quát tốt hơn
· Tài nguyên tính toán lớn hơn cho phép huấn luyện các kiến trúc và tập dữ liệu lớn hơn
Do đó, ưu thế của học sâu không đến miễn phí. Chi phí dữ liệu, phần cứng, thời gian huấn luyện và triển khai đều có thể tăng theo quy mô mô hình.
Khi nào nên dùng học sâu thay vì học máy truyền thống?
Không có quy tắc rằng học sâu luôn tốt hơn học máy truyền thống. Lựa chọn phụ thuộc trước hết vào loại dữ liệu, quy mô dữ liệu và Information Task của bài toán.
Học sâu thường có lợi thế khi dữ liệu có cấu trúc phức tạp hoặc phi cấu trúc như:
· Hình ảnh
· Âm thanh
· Văn bản
· Video
· Dữ liệu cảm biến có quan hệ phức tạp
Trong những trường hợp này, khả năng học biểu diễn nhiều tầng giúp mô hình giảm phụ thuộc vào việc con người phải xác định trước toàn bộ đặc trưng phù hợp.
Ngược lại, học máy truyền thống có thể là lựa chọn hợp lý khi:
· Dữ liệu có cấu trúc rõ ràng
· Tập dữ liệu không quá lớn
· Đặc trưng của bài toán đã tương đối rõ
· Tài nguyên tính toán bị giới hạn
· Cần mô hình dễ kiểm tra hoặc diễn giải hơn
Ví dụ, với một bài toán dự đoán dựa trên các biến dạng bảng như tuổi, thu nhập, lịch sử giao dịch và một số chỉ số định lượng, các mô hình như cây quyết định hoặc random forest có thể là lựa chọn thực tế mà không nhất thiết phải sử dụng mạng nơ-ron sâu.
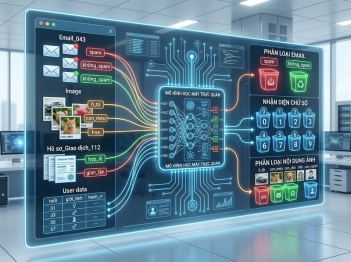
Ngược lại, nếu bài toán yêu cầu nhận dạng đối tượng trong ảnh hoặc hiểu nội dung của văn bản dài, lợi thế của học sâu thường rõ rệt hơn vì dữ liệu đầu vào chứa những quan hệ khó mô tả đầy đủ bằng một tập đặc trưng thủ công.
Học sâu có phải lúc nào cũng chính xác và tốt hơn học máy truyền thống?
Không. Độ sâu của mô hình không tự động bảo đảm độ chính xác cao hơn.
Hiệu quả thực tế phụ thuộc vào dữ liệu, cách xây dựng bài toán, chất lượng nhãn, kiến trúc, quy trình huấn luyện, cách đánh giá và điều kiện triển khai.
Một mô hình học sâu có thể hoạt động kém nếu dữ liệu huấn luyện ít, sai lệch hoặc không đại diện cho dữ liệu thực tế. Mô hình cũng có thể gặp overfitting nếu học quá sát dữ liệu huấn luyện mà không tổng quát tốt sang dữ liệu mới.
Ngoài ra, học sâu thường có một hạn chế đáng chú ý về khả năng giải thích. Với nhiều mô hình truyền thống, người phát triển có thể quan sát trực tiếp vai trò của từng đặc trưng hoặc quy tắc trong quyết định. Với mạng nơ-ron nhiều lớp, đường đi từ dữ liệu đầu vào đến kết quả thường phức tạp hơn.
Điều đó tạo ra một trade-off:
Khả năng học biểu diễn phức tạp ↔ Độ phức tạp của mô hình và khả năng giải thích
Vì vậy, không nên chọn học sâu chỉ vì nó là công nghệ mới hơn. Mô hình phù hợp phải là mô hình giải quyết tốt bài toán trong những điều kiện dữ liệu, tài nguyên và yêu cầu cụ thể.
Điểm khác biệt cốt lõi giữa học sâu và học máy truyền thống nằm ở cách học và biểu diễn đặc trưng. Học máy truyền thống thường dựa nhiều hơn vào việc con người lựa chọn hoặc thiết kế đặc trưng trước khi huấn luyện mô hình, trong khi học sâu có thể tự học các biểu diễn nhiều tầng từ dữ liệu.
Học sâu vì thế đặc biệt hữu ích với dữ liệu phi cấu trúc và các bài toán có quan hệ phức tạp, nhưng thường đi kèm yêu cầu cao hơn về dữ liệu, tính toán và độ phức tạp mô hình. Học máy truyền thống vẫn có lợi thế trong nhiều bài toán dữ liệu có cấu trúc, quy mô vừa phải hoặc cần mô hình dễ diễn giải.
Nói ngắn gọn, học sâu không phải một phương pháp thay thế tuyệt đối cho học máy truyền thống. Nó là một nhánh của học máy, phù hợp nhất khi khả năng tự học biểu diễn nhiều tầng mang lại lợi ích đủ lớn để bù cho chi phí dữ liệu, tính toán và độ phức tạp mà mô hình phải chịu.

GỬI Ý KIẾN BÌNH LUẬN

