
Hồi quy trong học máy khác phân loại như thế nào?
Mục lục
- Hồi quy trong học máy là gì?
- Phân loại trong học máy là gì?
- Khác biệt cốt lõi giữa hồi quy và phân loại nằm ở đầu ra
- Vì sao loại biến mục tiêu quyết định bài toán?
- Hồi quy và phân loại khác nhau ở cách đánh giá dự đoán
- Khi nào nên chọn hồi quy và khi nào nên chọn phân loại?
- Một bài toán có thể chuyển từ hồi quy sang phân loại không?
Hồi quy trong học máy dự đoán giá trị số, còn phân loại dự đoán nhãn hoặc nhóm. Bài viết làm rõ sự khác biệt về loại đầu ra, cách mô hình học, điều kiện sử dụng và các chỉ số đánh giá để phân biệt hai bài toán
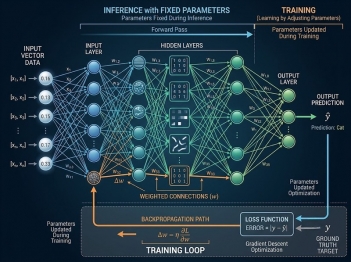
Hồi quy và phân loại đều là những bài toán học máy có giám sát, trong đó mô hình học mối quan hệ giữa dữ liệu đầu vào và đầu ra từ tập dữ liệu đã biết. Điểm khác biệt cốt lõi nằm ở loại đầu ra cần dự đoán: hồi quy dự đoán một giá trị số, thường thuộc miền liên tục; phân loại dự đoán một nhãn thuộc một hoặc nhiều lớp đã xác định.
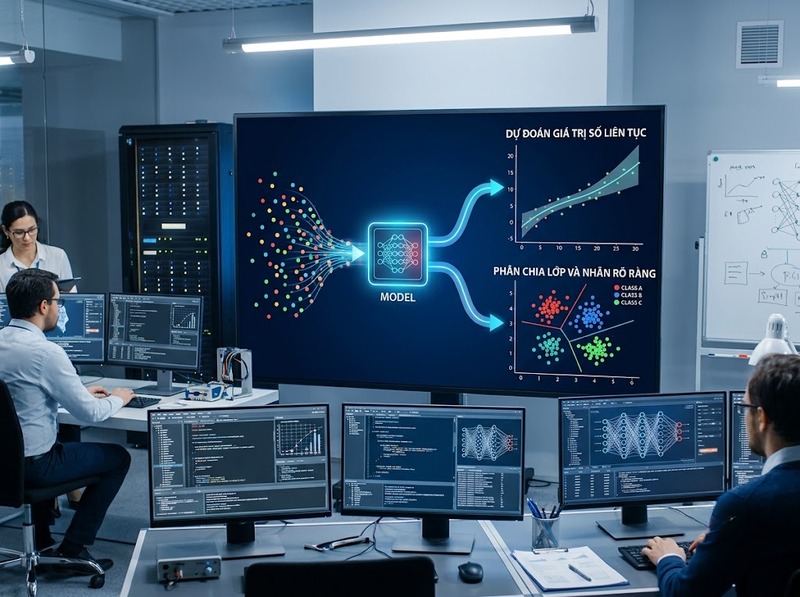
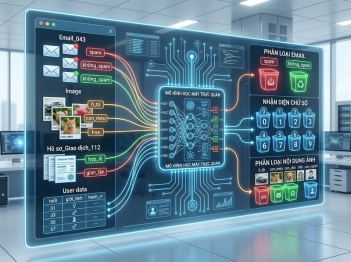
Ví dụ, dự đoán giá một căn nhà là bài toán hồi quy vì kết quả có thể là 2,1 tỷ, 2,15 tỷ hoặc 2,153 tỷ đồng. Ngược lại, dự đoán một email là “spam” hay “không spam” là bài toán phân loại vì đầu ra thuộc các lớp rời rạc.
Hồi quy trong học máy là gì?
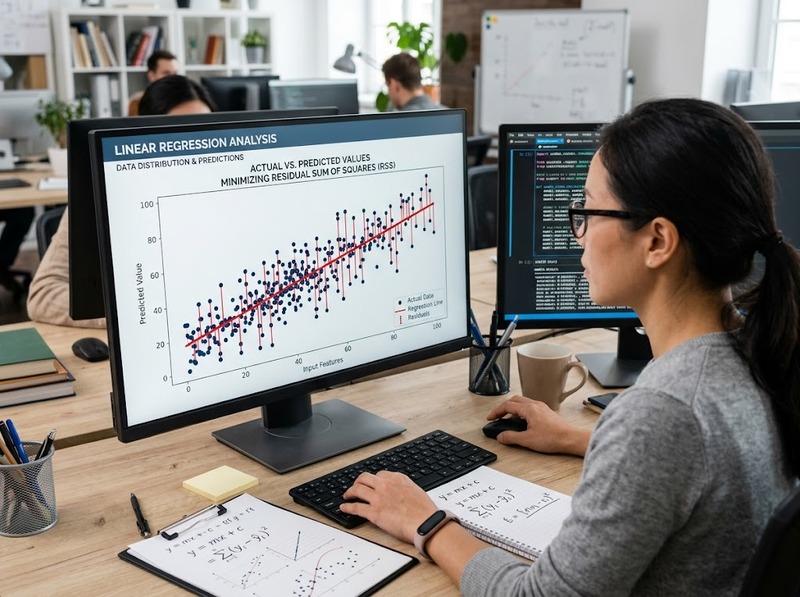
Hồi quy trong học máy là bài toán xây dựng mô hình để dự đoán giá trị số dựa trên một hoặc nhiều biến đầu vào.
Với hồi quy tuyến tính, mô hình có thể biểu diễn dưới dạng:
y^=b0 b1x
Trong đó, x là biến đầu vào, y là giá trị thực tế và y^ là giá trị mô hình dự đoán. Với nhiều biến đầu vào, mô hình có thể mở rộng thành nhiều hệ số tương ứng.
Điểm quan trọng là đầu ra của hồi quy mang tính định lượng. Vì vậy, sai số giữa giá trị dự đoán và giá trị thực tế cũng có thể được đo trực tiếp. Các chỉ số thường dùng gồm MAE, MSE, RMSE và R2.
Hồi quy phù hợp với những câu hỏi như:
· Giá trị cần dự đoán là bao nhiêu?
· Doanh thu tháng tới có thể đạt mức nào?
· Nhiệt độ dự kiến là bao nhiêu?
· Thời gian giao hàng dự kiến là bao lâu?
Phân loại trong học máy là gì?
Phân loại là bài toán dự đoán nhãn hoặc lớp cho một quan sát mới.
Nếu có hai lớp, chẳng hạn “có gian lận” và “không gian lận”, đó là phân loại nhị phân. Nếu có nhiều lớp như “thấp”, “trung bình” và “cao”, đó là phân loại đa lớp.
Một mô hình phân loại có thể tạo ra xác suất cho từng lớp trước khi chuyển chúng thành nhãn dự đoán. Chẳng hạn, mô hình có thể ước tính một giao dịch có xác suất gian lận 0,92 rồi gán giao dịch đó vào lớp “gian lận” theo ngưỡng quyết định được sử dụng.
Các chỉ số đánh giá phổ biến gồm accuracy, precision, recall và F1-score. Với những bài toán mất cân bằng lớp, accuracy có thể không phản ánh đầy đủ chất lượng mô hình nên precision, recall hoặc F1 thường có giá trị hơn.
Khác biệt cốt lõi giữa hồi quy và phân loại nằm ở đầu ra
Có thể phân biệt hai bài toán bằng câu hỏi đơn giản: mô hình cần trả về một con số hay một nhãn?
|
Tiêu chí |
Hồi quy |
Phân loại |
|
Loại đầu ra |
Giá trị số |
Nhãn/lớp |
|
Không gian đầu ra |
Thường liên tục |
Rời rạc |
|
Ví dụ |
Giá nhà, doanh thu, nhiệt độ |
Spam, bệnh/không bệnh, nhóm khách hàng |
|
Sai số điển hình |
Khoảng cách giữa dự đoán và giá trị thực |
Dự đoán đúng/sai lớp và chất lượng quyết định |
|
Chỉ số thường dùng |
MAE, MSE, RMSE, R2 |
Accuracy, Precision, Recall, F1 |
|
Câu hỏi chính |
“Giá trị là bao nhiêu?” |
“Thuộc lớp nào?” |
Điểm cần tránh là không phân biệt hai bài toán chỉ dựa vào tên thuật toán. Cùng một họ mô hình có thể được sử dụng cho các mục tiêu khác nhau tùy cách xây dựng bài toán và biến mục tiêu.
Vì sao loại biến mục tiêu quyết định bài toán?
Trong học máy, biến mục tiêu y đóng vai trò trung tâm khi xác định loại bài toán.
Nếu y là một đại lượng số cần ước lượng, bài toán thường được xây dựng dưới dạng hồi quy. Chẳng hạn, y có thể là doanh thu 125 triệu đồng hoặc thời gian 37,5 phút.
Nếu y biểu diễn thành viên của một lớp, bài toán thuộc nhóm phân loại. Ví dụ, y có thể nhận giá trị “spam” hoặc “không spam”.
Điều này cũng giải thích tại sao một biến được biểu diễn bằng số chưa chắc tạo thành bài toán hồi quy. Nếu các giá trị 0, 1 và 2 chỉ là mã cho ba nhóm “thấp”, “trung bình” và “cao”, bản chất mục tiêu vẫn là phân loại. Con số ở đây chỉ là cách mã hóa nhãn, không phải đại lượng cần dự đoán trên một thang liên tục.
Hồi quy và phân loại khác nhau ở cách đánh giá dự đoán
Vì loại đầu ra khác nhau, cách đánh giá mô hình cũng khác.
Với hồi quy
Sai số có thể được tính trực tiếp từ chênh lệch giữa giá trị thực tế và giá trị dự đoán. MAE cho biết sai lệch tuyệt đối trung bình, còn RMSE làm nổi bật hơn những sai số lớn vì sai số được bình phương trước khi lấy trung bình và căn bậc hai.
Ví dụ, nếu mô hình dự đoán giá nhà thấp hơn thực tế 100 triệu đồng, mức chênh lệch này có ý nghĩa trực tiếp về mặt định lượng.
Với phân loại
Không thể đánh giá mô hình chỉ bằng khoảng cách giữa hai nhãn. Một dự đoán “spam” thay vì “không spam” không có khoảng cách số học mang ý nghĩa như sai lệch 100 triệu đồng trong hồi quy.
Thay vào đó, cần xem mô hình phân loại đúng bao nhiêu trường hợp và mắc loại lỗi nào. Precision tập trung vào tỷ lệ dự đoán dương tính là đúng, còn recall tập trung vào khả năng tìm ra các trường hợp dương tính thực sự. F1-score cân bằng hai khía cạnh này thông qua trung bình điều hòa.
Khi nào nên chọn hồi quy và khi nào nên chọn phân loại?
Cách lựa chọn nên bắt đầu từ ý nghĩa của biến mục tiêu, không phải từ thuật toán muốn sử dụng.
Chọn hồi quy khi:
· Mục tiêu là một đại lượng số
· Các giá trị khác nhau của mục tiêu có ý nghĩa về khoảng cách hoặc độ lớn
· Người dùng cần biết giá trị dự đoán cụ thể
· Sai số lớn và nhỏ cần được phân biệt về mức độ
Chọn phân loại khi:
· Mục tiêu là một nhóm hoặc nhãn
· Các lớp có ý nghĩa phân biệt rõ ràng
· Câu hỏi cần trả lời là đối tượng thuộc lớp nào
· Chi phí của từng loại lỗi phân loại cần được xem xét riêng
Ví dụ, “khách hàng sẽ chi bao nhiêu tiền?” là hồi quy, trong khi “khách hàng có rời bỏ dịch vụ hay không?” là phân loại. Hai câu hỏi có thể sử dụng cùng dữ liệu đầu vào nhưng vẫn là hai bài toán khác nhau vì biến mục tiêu khác nhau.
Một bài toán có thể chuyển từ hồi quy sang phân loại không?
Có, nhưng khi đó mục tiêu dự đoán đã thay đổi.
Giả sử ban đầu cần dự đoán điểm tín dụng chính xác của một khách hàng. Đây là hồi quy vì đầu ra là một giá trị số.
Nếu chuyển mục tiêu thành “khách hàng thuộc nhóm rủi ro thấp, trung bình hay cao”, bài toán trở thành phân loại. Mô hình lúc này không còn cần dự đoán chính xác điểm số mà cần xác định lớp.
Việc chuyển đổi này có thể làm mất một phần thông tin định lượng. Hai khách hàng có điểm số 650 và 699 có thể được xếp cùng một nhóm dù giá trị ban đầu của chúng khác nhau. Vì vậy, không nên biến một bài toán hồi quy thành phân loại chỉ để làm bài toán có vẻ đơn giản hơn nếu khoảng cách giữa các giá trị mục tiêu vẫn có ý nghĩa.
Hồi quy trong học máy và phân loại đều học từ dữ liệu có nhãn, nhưng chúng giải quyết hai dạng đầu ra khác nhau. Hồi quy dự đoán giá trị số, còn phân loại dự đoán lớp hoặc nhãn. Ranh giới quan trọng nhất không nằm ở việc thuật toán tên gì mà nằm ở ý nghĩa của biến mục tiêu và loại quyết định cần tạo ra. Khi xác định đúng loại đầu ra ngay từ đầu, việc lựa chọn mô hình, hàm mất mát và chỉ số đánh giá cũng trở nên nhất quán hơn.
Hỏi đáp về hồi quy trong học máy
Hồi quy có phải lúc nào cũng dự đoán số thực không?
Không nhất thiết phải là số thực theo nghĩa toán học hẹp, nhưng mục tiêu của hồi quy phải là một đại lượng định lượng mà độ lớn và sai lệch giữa các giá trị có ý nghĩa. Nếu các số chỉ đóng vai trò mã hóa nhãn, bài toán vẫn có thể là phân loại.
Phân loại có thể dự đoán xác suất không?
Có. Nhiều mô hình phân loại tạo ra xác suất hoặc điểm số cho các lớp trước khi áp dụng quy tắc quyết định để tạo nhãn cuối cùng. Việc mô hình xuất ra xác suất không biến bài toán đó thành hồi quy.
Dự đoán số lượng sản phẩm bán được là hồi quy hay phân loại?
Nếu mục tiêu là dự đoán số lượng cụ thể, đây thường là bài toán hồi quy. Nếu số lượng được chuyển thành các nhóm như “bán ít”, “bán vừa” và “bán nhiều”, mục tiêu đã trở thành phân loại.
Hồi quy và phân loại có thể dùng cùng một thuật toán không?
Có thể. Một số thuật toán có biến thể dành cho hồi quy và phân loại. Tuy nhiên, cách huấn luyện, đầu ra và tiêu chí đánh giá phải phù hợp với loại bài toán tương ứng.

GỬI Ý KIẾN BÌNH LUẬN

