Nhận dạng giọng nói chuyển âm thanh thành văn bản thế nào?
Mục lục
- Nhận dạng giọng nói thực chất là gì?
- Từ âm thanh đến văn bản diễn ra qua những bước nào?
- Mô hình nhận dạng biến đặc trưng âm thanh thành từ như thế nào?
- Vì sao hệ thống phải dùng ngữ cảnh để nhận dạng giọng nói?
- Điều gì quyết định độ chính xác của nhận dạng giọng nói?
- Nhận dạng giọng nói khác gì với nghe và hiểu ngôn ngữ?
- Hệ thống xử lý âm thanh trực tiếp khác gì xử lý file ghi âm?
- Những giới hạn nào cần lưu ý khi chuyển âm thanh thành văn bản?
- Từ văn bản nhận dạng đến bản chép lời có thể sử dụng
Nhận dạng giọng nói là công nghệ giúp máy tính hiểu lời nói của con người và chuyển tín hiệu âm thanh thành văn bản. Bài viết giải thích từng bước từ thu âm, xử lý tín hiệu, nhận diện đặc trưng đến giải mã thành câu chữ, cùng các yếu tố ảnh hưởng đến độ chính xác
Nhận dạng giọng nói là quá trình máy tính phân tích tín hiệu lời nói và tạo ra chuỗi từ tương ứng dưới dạng văn bản. Về bản chất, hệ thống không “đọc” âm thanh như con người mà xử lý một tín hiệu liên tục, trích xuất các đặc trưng liên quan đến tiếng nói rồi dùng mô hình học máy để xác định nội dung được phát ra.
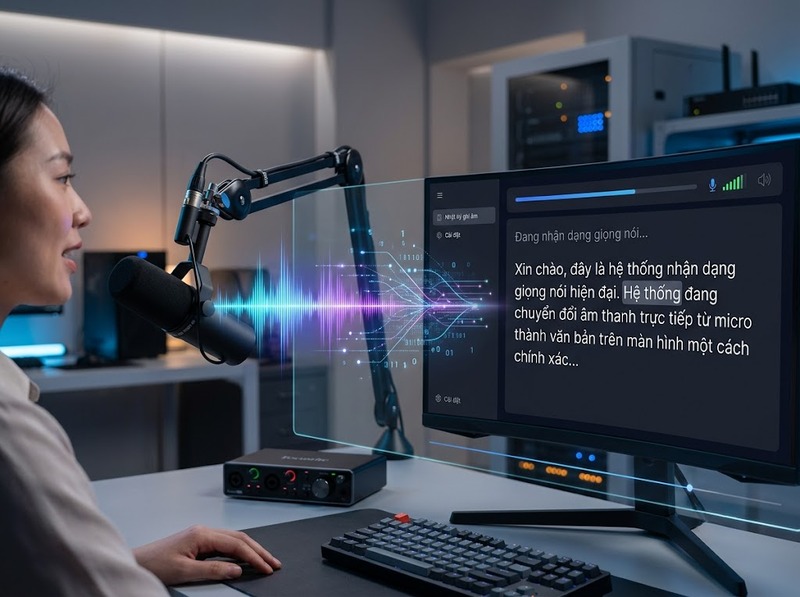
Một hệ thống nhận dạng giọng nói hoàn chỉnh thường phải giải quyết nhiều bước: tiếp nhận âm thanh, làm sạch tín hiệu, phát hiện phần có lời nói, biểu diễn đặc trưng âm thanh, dự đoán các đơn vị ngôn ngữ và cuối cùng ghép chúng thành câu có ý nghĩa.
Nhận dạng giọng nói thực chất là gì?
Nhận dạng giọng nói, thường được gọi là Automatic Speech Recognition (ASR), là công nghệ biến lời nói thành dữ liệu văn bản mà máy tính có thể xử lý. Đầu vào có thể là âm thanh từ micro, cuộc gọi, tệp ghi âm hoặc luồng âm thanh trực tiếp; đầu ra thường là các từ và câu được nhận diện.
Điểm quan trọng là âm thanh không chứa sẵn văn bản. Micro chỉ ghi lại sự biến đổi áp suất không khí dưới dạng tín hiệu điện hoặc dữ liệu số. Hệ thống phải suy luận từ tín hiệu đó xem người nói đã phát ra âm nào, các âm được ghép thành từ nào và các từ tạo thành câu ra sao.
Vì vậy, nhận dạng giọng nói không đơn thuần là “nghe rồi chép lại”. Đây là bài toán liên kết giữa tín hiệu âm thanh và ngôn ngữ.
Từ âm thanh đến văn bản diễn ra qua những bước nào?
Quá trình có thể hình dung theo chuỗi:
Âm thanh → Tiền xử lý → Phát hiện lời nói → Trích xuất đặc trưng → Mô hình âm thanh → Mô hình ngôn ngữ/giải mã → Văn bản
Các hệ thống hiện đại có thể kết hợp nhiều bước trong một mô hình học sâu thay vì tách biệt hoàn toàn từng thành phần. Tuy nhiên, về mặt nguyên lý, chúng vẫn phải giải quyết các nhiệm vụ tương tự.
Thu nhận và số hóa âm thanh
Âm thanh đầu tiên được micro chuyển thành tín hiệu điện rồi số hóa thành các mẫu dữ liệu. Những mẫu này mô tả sự thay đổi của tín hiệu theo thời gian.
Chất lượng tín hiệu đầu vào ảnh hưởng trực tiếp đến quá trình nhận dạng. Tiếng nói rõ, đủ mức tín hiệu và ít nhiễu giúp hệ thống dễ phân biệt các đặc trưng âm học hơn.
Tiền xử lý tín hiệu
Âm thanh thực tế thường chứa tiếng quạt, tiếng xe, tiếng người khác nói, tiếng vọng hoặc khoảng lặng. Hệ thống có thể xử lý tín hiệu để giảm tác động của những thành phần không mong muốn.
Mục tiêu không phải biến mọi bản ghi thành âm thanh hoàn hảo, mà là làm nổi bật thông tin liên quan đến lời nói trước khi đưa vào bước nhận dạng.
Phát hiện vùng có lời nói
Nếu bản ghi dài vài phút nhưng người nói chỉ phát biểu trong một số khoảng thời gian, hệ thống cần phân biệt phần có lời nói với phần im lặng hoặc âm thanh nền.
Bước này thường được gọi là Voice Activity Detection (VAD). Nó giúp giảm lượng dữ liệu phải xử lý và hạn chế việc hệ thống cố gắng giải mã tiếng ồn thành từ ngữ.
Chuyển âm thanh thành biểu diễn phù hợp
Dữ liệu sóng âm thô thay đổi liên tục và chứa rất nhiều thông tin. Hệ thống cần biến nó thành một biểu diễn mà mô hình có thể khai thác hiệu quả.
Một cách tiếp cận truyền thống là biểu diễn phổ tần số của âm thanh, chẳng hạn thông qua các đặc trưng như Mel-frequency cepstral coefficients (MFCC). Các hệ thống học sâu hiện đại có thể học trực tiếp đặc trưng từ dạng sóng hoặc từ các biểu diễn phổ.
Điều cần nhận ra là đặc trưng âm thanh không phải văn bản. Chúng chỉ cung cấp thông tin giúp mô hình suy ra những đơn vị ngôn ngữ có khả năng tương ứng.
Mô hình nhận dạng biến đặc trưng âm thanh thành từ như thế nào?
Đây là phần cốt lõi của quá trình nhận dạng.
Khi một người nói, âm thanh thay đổi theo thời gian. Một âm vị có thể được phát âm khác nhau tùy người nói, tốc độ nói, ngữ cảnh và vị trí trong câu. Vì vậy, hệ thống không thể chỉ dùng một mẫu âm thanh cố định để tìm kiếm từng từ.
Mô hình học máy học mối quan hệ thống kê giữa mẫu âm thanh và đơn vị ngôn ngữ. Với mô hình hiện đại, mạng nơ-ron có thể học các biểu diễn phức tạp hơn, trong đó thông tin về ngữ cảnh theo thời gian đóng vai trò quan trọng.
Ví dụ, cùng một chuỗi âm thanh gần giống nhau có thể dẫn đến các cách diễn giải khác nhau nếu những từ xung quanh khác nhau. Mô hình vì thế cần xem xét cả tín hiệu âm thanh lẫn ngữ cảnh ngôn ngữ.
Ở các kiến trúc ASR hiện đại, quá trình này có thể được thực hiện bằng những mô hình học sâu như CTC, sequence-to-sequence hoặc các kiến trúc dựa trên Transformer. Điểm chung là chúng học cách ánh xạ chuỗi biểu diễn âm thanh sang chuỗi ký hiệu văn bản.
Vì sao hệ thống phải dùng ngữ cảnh để nhận dạng giọng nói?
Chỉ dựa vào âm thanh đôi khi chưa đủ để xác định chính xác từ được nói.
Trong ngôn ngữ tự nhiên, nhiều âm có thể gần nhau về mặt âm học. Người nói cũng thường nối âm, nuốt âm, nói nhanh hoặc phát âm không hoàn toàn giống cách đọc chuẩn. Khi đó, ngữ cảnh giúp hệ thống chọn cách giải mã hợp lý hơn.
Ví dụ, nếu một đoạn âm thanh có thể tương ứng với nhiều chuỗi từ, mô hình cần đánh giá chuỗi nào có xác suất xuất hiện cao hơn trong câu đang được nói.
Đây là vai trò của mô hình ngôn ngữ và quá trình giải mã. Hệ thống không chỉ hỏi “âm thanh này giống từ nào?” mà còn phải xem “chuỗi từ nào phù hợp với những gì đã xuất hiện trước đó?”.
Vì thế, nhận dạng giọng nói là sự kết hợp giữa thông tin âm học và thông tin ngôn ngữ.
Điều gì quyết định độ chính xác của nhận dạng giọng nói?
Độ chính xác không chỉ phụ thuộc vào bản thân mô hình. Chất lượng đầu vào và điều kiện sử dụng có thể làm thay đổi đáng kể kết quả.
Chất lượng âm thanh
Micro tốt, khoảng cách phù hợp và tín hiệu đủ rõ giúp hệ thống có nhiều thông tin hữu ích hơn. Ngược lại, âm thanh bị rè, méo hoặc quá nhỏ khiến đặc trưng lời nói khó phân biệt.
Tiếng ồn và tiếng vọng
Tiếng ồn nền có thể chồng lên tín hiệu lời nói. Trong phòng có nhiều bề mặt phản xạ âm, tiếng vọng còn khiến cùng một âm thanh xuất hiện dưới nhiều dạng trễ khác nhau.
Khi tỷ lệ tín hiệu lời nói so với nhiễu giảm, bài toán nhận dạng trở nên khó hơn.
Giọng nói và cách phát âm
Mỗi người có cao độ, tốc độ, âm sắc và cách phát âm riêng. Phương ngữ, giọng địa phương, nói lắp hoặc phát âm không chuẩn cũng có thể tạo ra khoảng cách giữa dữ liệu thực tế và những mẫu mà mô hình đã học.
Tốc độ nói và cách nối âm
Nói quá nhanh làm ranh giới giữa các từ khó xác định. Trong hội thoại tự nhiên, người nói cũng thường nối âm và không phát âm từng từ tách biệt như khi đọc văn bản.
Ngữ cảnh chuyên ngành
Tên riêng, thuật ngữ y khoa, kỹ thuật, pháp lý hoặc từ viết tắt có thể khó nhận dạng nếu mô hình không có đủ thông tin về lĩnh vực đang được sử dụng.
Vì vậy, một hệ thống có thể nhận dạng tốt hội thoại thông thường nhưng gặp nhiều lỗi hơn khi xử lý nội dung chuyên môn.
Nhận dạng giọng nói khác gì với nghe và hiểu ngôn ngữ?
Nhận dạng giọng nói chủ yếu trả lời câu hỏi “Người nói đã nói những từ nào?”
Nó không đồng nghĩa với việc máy tính đã hiểu đầy đủ “Người nói muốn làm gì hoặc có ý định gì?”
Ví dụ, ASR có thể chuyển một câu nói thành văn bản khá chính xác, nhưng một hệ thống khác mới chịu trách nhiệm phân tích ý định, cảm xúc, thực thể hoặc yêu cầu trong câu đó.
Do đó, trong một hệ thống xử lý tiếng nói hoàn chỉnh, ASR thường là lớp biến âm thanh thành văn bản, sau đó văn bản mới có thể được đưa sang các hệ thống xử lý ngôn ngữ tự nhiên khác.
Ranh giới này quan trọng vì một bản chép lời chính xác về mặt từ ngữ chưa chắc đồng nghĩa với khả năng hiểu ngữ nghĩa hoàn chỉnh.
Hệ thống xử lý âm thanh trực tiếp khác gì xử lý file ghi âm?
Về nguyên lý nhận dạng, hai trường hợp có cùng mục tiêu: biến chuỗi âm thanh thành văn bản. Khác biệt lớn nằm ở cách dữ liệu được cung cấp.
Với file ghi âm, toàn bộ hoặc một phần nội dung đã tồn tại trước khi hệ thống xử lý. Hệ thống có thể phân tích dữ liệu theo từng đoạn và tạo văn bản sau đó.
Với nhận dạng thời gian thực, âm thanh liên tục được đưa vào khi người nói đang phát biểu. Hệ thống phải cân bằng giữa hai yêu cầu: đưa ra kết quả nhanh và vẫn giữ đủ ngữ cảnh để nhận dạng chính xác.
Điều này tạo ra một đánh đổi rõ ràng: chờ thêm dữ liệu có thể giúp mô hình có nhiều ngữ cảnh hơn, nhưng lại làm tăng độ trễ của kết quả.
Những giới hạn nào cần lưu ý khi chuyển âm thanh thành văn bản?
Không có hệ thống nhận dạng giọng nói nào bảo đảm mọi bản ghi đều được chuyển thành văn bản chính xác tuyệt đối.
Các lỗi thường xuất hiện khi tín hiệu đầu vào kém, người nói chồng tiếng, có nhiều tiếng ồn, dùng từ hiếm, sử dụng phương ngữ hoặc nói trong điều kiện mà mô hình chưa được tối ưu.
Một chỉ số phổ biến để đánh giá ASR là Word Error Rate (WER), được tính dựa trên số lỗi thay thế, chèn và xóa so với bản chép lời tham chiếu:
WER = (S D I) / N
Trong đó:
· S là số lỗi thay thế
· D là số lỗi xóa
· I là số lỗi chèn
· N là tổng số từ trong bản tham chiếu
WER càng thấp thì kết quả nhận dạng càng gần với bản tham chiếu. Tuy nhiên, WER không phải thước đo duy nhất cho mọi ứng dụng. Với hội thoại thực tế, tên riêng, thuật ngữ chuyên ngành hoặc các lỗi không làm thay đổi ý nghĩa có thể cần được đánh giá riêng.
Vì vậy, khi đánh giá một hệ thống nhận dạng giọng nói, cần xem xét cả độ chính xác, độ trễ, điều kiện âm thanh và loại nội dung thay vì chỉ nhìn vào một con số.
Từ văn bản nhận dạng đến bản chép lời có thể sử dụng
Kết quả ASR ban đầu thường mới là chuỗi văn bản được mô hình giải mã. Để sử dụng trong thực tế, hệ thống có thể cần xử lý thêm dấu câu, viết hoa, định dạng số, nhận diện người nói hoặc chia đoạn.
Những bước này không phải lúc nào cũng thuộc lõi của nhận dạng giọng nói. Chúng là các lớp xử lý sau nhận dạng nhằm biến kết quả thô thành văn bản dễ đọc và dễ sử dụng hơn.
Điều đó cũng giải thích vì sao “chuyển âm thanh thành văn bản” có thể là một quy trình lớn hơn bản thân ASR: ASR tạo ra nội dung ngôn ngữ, còn các bước hậu xử lý giúp tổ chức và trình bày nội dung đó.
Nhìn tổng thể, nhận dạng giọng nói hoạt động bằng cách biến tín hiệu âm thanh thành một biểu diễn có thể phân tích, dùng mô hình học máy để liên hệ biểu diễn đó với các đơn vị ngôn ngữ, rồi giải mã thành chuỗi từ phù hợp với ngữ cảnh. Chất lượng cuối cùng phụ thuộc đồng thời vào tín hiệu âm thanh, mô hình nhận dạng, ngữ cảnh ngôn ngữ và điều kiện sử dụng. Vì vậy, hiểu đúng quy trình này giúp phân biệt rõ giữa việc “nghe được âm thanh”, “chuyển âm thanh thành văn bản” và “thực sự hiểu nội dung người nói”.

GỬI Ý KIẾN BÌNH LUẬN

