Hệ thống dựa trên luật khác học từ dữ liệu thế nào?
Mục lục
Hệ thống dựa trên luật và hệ thống học máy khác nhau chủ yếu ở cách tạo ra logic quyết định: một bên được con người viết sẵn bằng quy tắc, bên kia học các mẫu từ dữ liệu. Bài viết giải thích cơ chế, ưu nhược điểm và trường hợp nên sử dụng từng cách tiếp cận.
Hệ thống dựa trên luật là hệ thống sử dụng các quy tắc được con người xác định trước để biến điều kiện đầu vào thành hành động hoặc kết luận. Dạng phổ biến nhất là cấu trúc if–then: nếu điều kiện A xảy ra thì thực hiện B. Ngược lại, hệ thống học từ dữ liệu, điển hình là hệ thống học máy, không được cung cấp toàn bộ logic quyết định bằng tay mà được huấn luyện trên dữ liệu để tìm ra các mẫu và quan hệ có khả năng dùng cho dữ liệu mới.
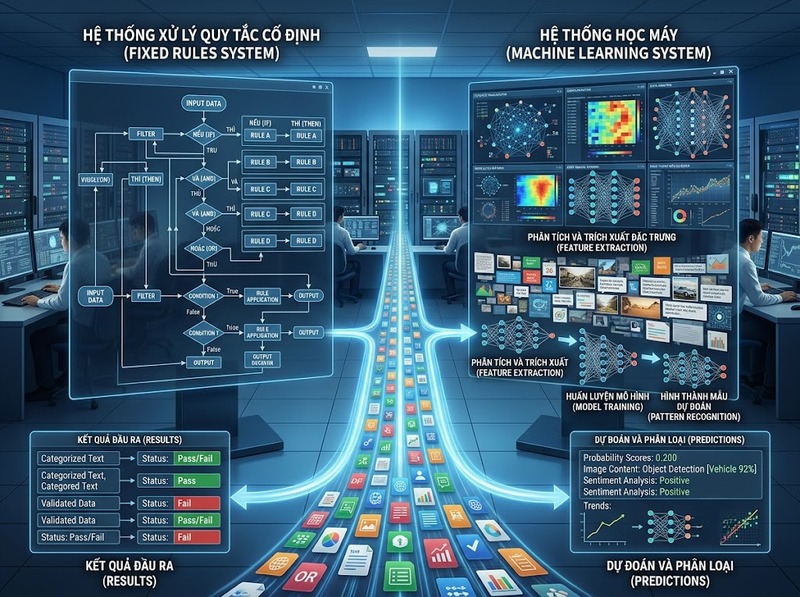
Vì vậy, khác biệt cốt lõi không nằm ở việc hệ thống có sử dụng dữ liệu hay không. Cả hai đều nhận dữ liệu đầu vào. Điểm khác là logic chuyển từ đầu vào sang đầu ra được tạo ra như thế nào: hệ thống dựa trên luật nhận logic từ con người, còn học máy suy ra logic hoặc tham số từ dữ liệu huấn luyện.
Hệ thống dựa trên luật là gì?
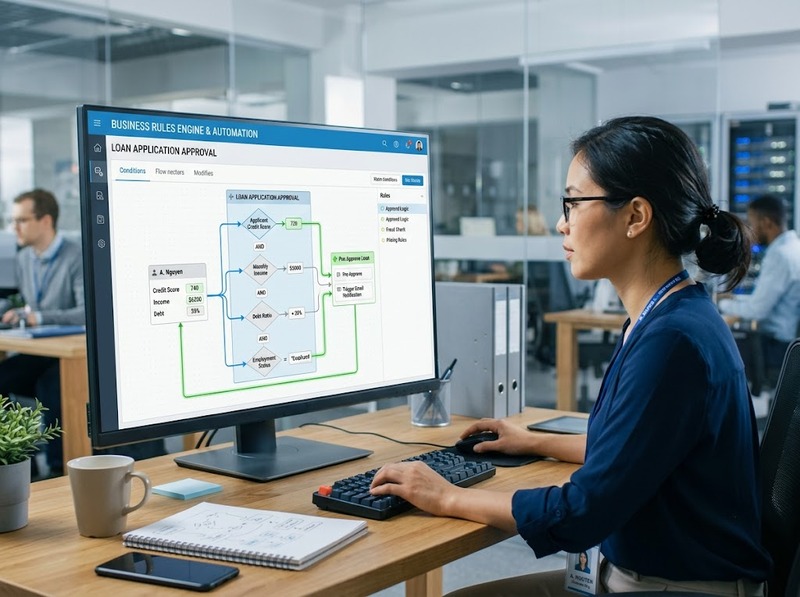
Hệ thống dựa trên luật biểu diễn kiến thức hoặc logic quyết định bằng một tập quy tắc được xác định trước. Một quy tắc thường có dạng:
Nếu điều kiện X đúng, thì thực hiện hành động Y
Ví dụ, một hệ thống xét điều kiện giao dịch có thể áp dụng:
· Nếu giá trị đơn hàng trên một ngưỡng nhất định thì áp dụng mức giảm giá tương ứng
· Nếu hồ sơ thiếu trường bắt buộc thì đánh dấu cần bổ sung
· Nếu nhiệt độ vượt ngưỡng thì phát cảnh báo
Khi đầu vào thỏa điều kiện, hệ thống áp dụng quy tắc tương ứng. Logic này có thể được kiểm tra trực tiếp vì người phát triển biết hệ thống đang dựa trên những điều kiện nào.
Trong các hệ thống phức tạp hơn, tập luật có thể kết hợp với cơ sở tri thức và cơ chế suy luận. Khi đó, hệ thống không chỉ kiểm tra một điều kiện đơn lẻ mà có thể thực hiện chuỗi suy luận dựa trên các luật đã được xác định.
Điểm quan trọng là hệ thống không tự học ra luật mới chỉ từ việc quan sát dữ liệu vận hành. Nếu logic cần thay đổi, con người thường phải bổ sung, sửa hoặc tổ chức lại các luật.
Hệ thống học từ dữ liệu hoạt động như thế nào?
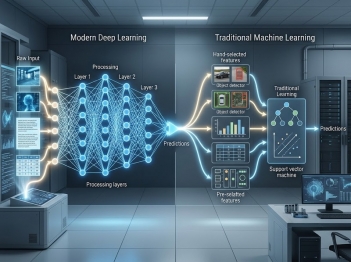
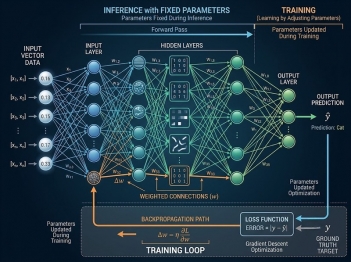
Hệ thống học máy bắt đầu từ dữ liệu huấn luyện và một thuật toán học. Trong quá trình huấn luyện, mô hình điều chỉnh các tham số của mình để tìm ra cách tạo đầu ra phù hợp với dữ liệu hoặc mục tiêu được đặt ra.
Chẳng hạn, thay vì viết thủ công hàng trăm quy tắc để phát hiện thư rác, có thể cung cấp cho mô hình nhiều email đã được xác định là thư rác hoặc không phải thư rác. Mô hình học các mẫu xuất hiện trong dữ liệu và sau đó sử dụng những mẫu đã học để dự đoán trên email mới.
Cơ chế này tạo ra một khác biệt quan trọng: logic bên trong mô hình thường không được biểu diễn thành một danh sách quy tắc dễ đọc như trong hệ thống dựa trên luật. Với các mô hình phức tạp, đặc biệt là mạng nơ-ron, người phát triển thường biết dữ liệu, mục tiêu và quy trình huấn luyện nhưng không thể viết lại toàn bộ quá trình dự đoán thành một tập điều kiện if–then đơn giản.
Mục tiêu quan trọng của học máy là khả năng khái quát hóa: mô hình không chỉ ghi nhớ dữ liệu huấn luyện mà phải tạo dự đoán hữu ích trên dữ liệu mới.
Khác biệt cốt lõi giữa hệ thống dựa trên luật và học từ dữ liệu
Có thể nhìn sự khác nhau qua cách hình thành logic, khả năng thích nghi và mức độ kiểm soát.
|
Tiêu chí |
Hệ thống dựa trên luật |
Hệ thống học từ dữ liệu |
|
Nguồn logic |
Luật do con người xác định |
Mẫu được học từ dữ liệu |
|
Cơ chế chính |
Điều kiện → hành động/kết luận |
Dữ liệu → huấn luyện → dự đoán |
|
Khả năng giải thích |
Thường dễ truy nguyên qua luật |
Có thể khó giải thích, tùy mô hình |
|
Thay đổi hành vi |
Sửa hoặc thêm luật |
Thường cần dữ liệu, huấn luyện hoặc hiệu chỉnh mô hình |
|
Phụ thuộc dữ liệu |
Có nhưng không nhất thiết cần tập dữ liệu huấn luyện lớn |
Phụ thuộc đáng kể vào dữ liệu phù hợp |
|
Xử lý quy tắc rõ ràng |
Mạnh |
Không nhất thiết là lựa chọn tốt nhất |
|
Xử lý mẫu phức tạp |
Dễ trở nên cồng kềnh |
Có thể phù hợp hơn nếu có dữ liệu đủ tốt |
|
Kiểm soát trực tiếp logic |
Cao |
Thấp hơn đối với mô hình phức tạp |
Điểm cần tránh là xem hai phương pháp như hai lựa chọn hoàn toàn đối lập. Một hệ thống thực tế có thể kết hợp cả luật và học máy. Ví dụ, mô hình học máy có thể đưa ra dự đoán, sau đó một lớp luật được dùng để áp dụng các điều kiện bắt buộc hoặc giới hạn an toàn.
Khi nào hệ thống dựa trên luật có lợi thế?
Hệ thống dựa trên luật phù hợp khi logic nghiệp vụ rõ ràng, ổn định và có thể mô tả bằng điều kiện cụ thể.
Một lợi thế lớn là khả năng kiểm soát. Khi một quyết định được tạo ra từ một luật cụ thể, người vận hành có thể kiểm tra điều kiện nào đã kích hoạt kết quả. Điều này đặc biệt hữu ích khi doanh nghiệp cần biết vì sao một quyết định được đưa ra hoặc cần thay đổi chính xác một điều kiện.
Hệ thống dựa trên luật cũng phù hợp khi có những quy tắc bắt buộc mà tổ chức muốn áp dụng một cách nhất quán. Thay vì để mô hình suy ra một hành vi từ dữ liệu, con người có thể quy định trực tiếp hành vi phải xảy ra trong một điều kiện xác định.
Tuy nhiên, lợi thế này trở thành hạn chế khi số lượng trường hợp tăng nhanh. Một bài toán phức tạp có thể có rất nhiều ngoại lệ và sự kết hợp giữa các điều kiện. Khi đó, việc viết và bảo trì toàn bộ tập luật trở nên khó khăn. Chỉ cần một trường hợp chưa được quy định cũng có thể khiến hệ thống xử lý sai hoặc không có kết quả phù hợp.
Khi nào học từ dữ liệu phù hợp hơn?
Học máy có lợi thế khi quy luật của bài toán khó mô tả đầy đủ bằng các quy tắc thủ công nhưng có đủ dữ liệu để mô hình học các mẫu.
Nhận dạng hình ảnh, phân loại văn bản, phát hiện mẫu bất thường hoặc dự đoán từ nhiều biến đầu vào là những dạng bài toán thường có rất nhiều tương tác mà việc viết từng luật bằng tay không thực tế.
Học máy cũng có khả năng thích nghi tốt hơn khi mối quan hệ trong dữ liệu phức tạp. Tuy nhiên, sự linh hoạt này đi kèm với điều kiện: dữ liệu phải đủ phù hợp với nhiệm vụ. Dữ liệu huấn luyện thiếu đại diện, chứa sai lệch hoặc không phản ánh môi trường thực tế có thể khiến mô hình hoạt động kém trên dữ liệu mới.
Một điểm khác là học máy không tự động tốt hơn chỉ vì nó “học từ dữ liệu”. Chất lượng mô hình còn phụ thuộc vào thuật toán, dữ liệu, cách huấn luyện, đánh giá và khả năng khái quát hóa.
Nên chọn hệ thống dựa trên luật hay học máy?
Không có lựa chọn luôn tốt hơn. Câu hỏi đúng hơn là logic của bài toán có thể được xác định rõ bằng luật hay cần được suy ra từ dữ liệu.
Có thể ưu tiên hệ thống dựa trên luật khi:
· Điều kiện và kết quả được xác định rõ
· Quy tắc tương đối ổn định
· Cần kiểm soát trực tiếp hành vi của hệ thống
· Cần truy nguyên quyết định qua các điều kiện cụ thể
· Dữ liệu huấn luyện không đủ hoặc không cần thiết
Có thể ưu tiên học máy khi:
· Quy luật khó viết thủ công
· Có lượng dữ liệu phù hợp để huấn luyện
· Bài toán phụ thuộc nhiều vào nhận dạng mẫu
· Cần xử lý nhiều biến và mối quan hệ phức tạp
· Khả năng khái quát hóa trên dữ liệu mới là yêu cầu quan trọng
Trong nhiều trường hợp, giải pháp thực tế là kết hợp hai cách tiếp cận. Học máy xử lý phần nhận dạng hoặc dự đoán dựa trên dữ liệu, trong khi hệ thống luật kiểm soát những điều kiện nghiệp vụ, giới hạn hoặc hành động bắt buộc. Cách kết hợp này cho phép tận dụng khả năng học mẫu của mô hình mà vẫn duy trì một lớp kiểm soát rõ ràng ở những nơi cần thiết.
Tóm lại, hệ thống dựa trên luật trả lời câu hỏi theo logic mà con người đã quy định, còn hệ thống học từ dữ liệu xây dựng khả năng dự đoán từ các mẫu tìm thấy trong dữ liệu. Nếu bài toán có quy tắc rõ và cần kiểm soát trực tiếp, luật thường phù hợp; nếu bài toán có mẫu phức tạp khó mô tả nhưng có dữ liệu tốt, học máy thường có lợi thế hơn.

GỬI Ý KIẾN BÌNH LUẬN

