Vì sao overfitting khiến mô hình kém trên dữ liệu mới?
Mục lục
Overfitting xảy ra khi mô hình học quá sát dữ liệu huấn luyện, kể cả những nhiễu và đặc điểm riêng không có tính khái quát, khiến kết quả trên dữ liệu mới kém hơn đáng kể
Khi huấn luyện mô hình học máy, mục tiêu không chỉ là làm cho mô hình dự đoán đúng dữ liệu đã nhìn thấy mà còn phải hoạt động tốt với dữ liệu chưa từng xuất hiện. Overfitting xảy ra khi mô hình thích nghi quá mức với tập huấn luyện, đến mức không chỉ học quy luật có ý nghĩa mà còn ghi nhớ những đặc điểm riêng, nhiễu hoặc mẫu ngẫu nhiên của tập dữ liệu đó.
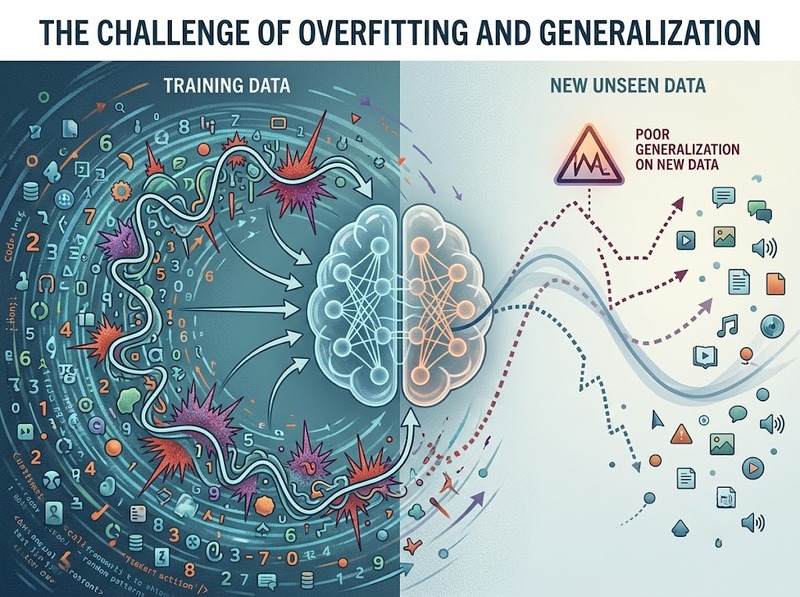
Vì vậy, một mô hình có thể đạt kết quả rất tốt trên dữ liệu huấn luyện nhưng lại giảm hiệu suất khi gặp dữ liệu mới. Đây chính là vấn đề về khả năng khái quát hóa (generalization).
Overfitting là gì?
Overfitting là trạng thái mô hình học quá sát dữ liệu huấn luyện, khiến sai số trên tập huấn luyện rất thấp nhưng khả năng dự đoán trên dữ liệu chưa từng thấy lại kém.
Điểm quan trọng là mô hình không nhất thiết "học quá nhiều" theo nghĩa đơn giản. Vấn đề nằm ở mô hình học những gì không nên học. Thay vì tập trung vào quy luật tổng quát giữa đầu vào và đầu ra, mô hình có thể tận dụng cả nhiễu, ngoại lệ hoặc đặc điểm chỉ xuất hiện trong tập huấn luyện.
Có thể hình dung quá trình này theo ba mức:
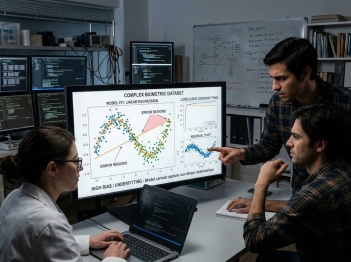
· Underfitting: Mô hình quá đơn giản nên chưa học được quy luật cần thiết
· Fit phù hợp: Mô hình học được quy luật có tính khái quát và hoạt động tốt trên dữ liệu mới
· Overfitting: Mô hình tiếp tục tối ưu dữ liệu huấn luyện đến mức bắt đầu học cả những đặc điểm không đại diện cho dữ liệu nói chung
Do đó, việc một mô hình có training accuracy rất cao chưa đủ để kết luận rằng mô hình tốt. Cần xem xét đồng thời kết quả trên dữ liệu validation hoặc test để đánh giá khả năng khái quát hóa.
Vì sao mô hình có thể rất tốt trên dữ liệu huấn luyện nhưng kém trên dữ liệu mới?
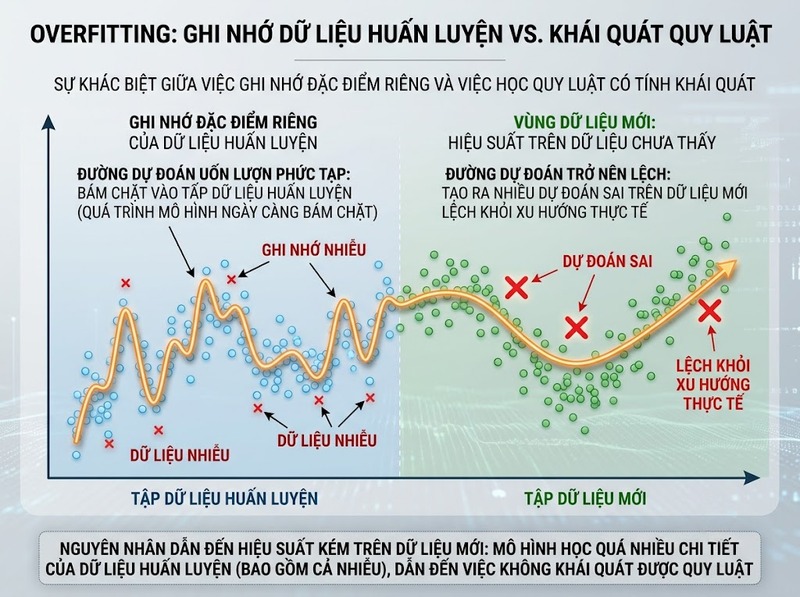
Nguyên nhân cốt lõi nằm ở sự khác biệt giữa học quy luật và ghi nhớ đặc điểm của mẫu huấn luyện.
Trong quá trình tối ưu, thuật toán điều chỉnh tham số để giảm hàm mất mát trên dữ liệu huấn luyện. Nếu mô hình có đủ năng lực biểu diễn và được huấn luyện quá lâu hoặc thiếu các cơ chế kiểm soát, nó có thể tiếp tục giảm lỗi bằng cách thích nghi với những chi tiết ngày càng đặc thù của tập huấn luyện.
Khi gặp dữ liệu mới, những chi tiết đó không còn hữu ích. Mô hình vì thế đưa ra dự đoán kém chính xác.
Có thể mô tả chuỗi nguyên nhân như sau:
Mô hình có năng lực biểu diễn cao → tối ưu ngày càng sát tập huấn luyện → học cả tín hiệu đặc thù và nhiễu → quy luật học được kém tổng quát → hiệu suất trên dữ liệu mới giảm
Đây cũng là lý do overfitting thường được nhận diện thông qua generalization gap — khoảng cách hiệu suất giữa dữ liệu huấn luyện và dữ liệu chưa được sử dụng để học tham số.
Những yếu tố nào làm tăng nguy cơ overfitting?
Không có một nguyên nhân duy nhất. Overfitting thường xuất hiện khi mức độ phức tạp của mô hình và cách huấn luyện không phù hợp với lượng hoặc chất lượng dữ liệu.
Mô hình quá phức tạp so với dữ liệu
Một mô hình có quá nhiều tham số hoặc năng lực biểu diễn lớn có thể học được những quan hệ rất chi tiết trong tập huấn luyện. Nếu dữ liệu không đủ đa dạng, những quan hệ này có thể không đại diện cho quy luật chung.
Vấn đề không phải là mô hình lớn luôn bị overfitting. Mô hình lớn vẫn có thể khái quát tốt khi dữ liệu, kiến trúc, quy trình huấn luyện và regularization phù hợp. Rủi ro xuất hiện khi năng lực mô hình vượt quá thông tin thực sự có thể được dữ liệu hỗ trợ.
Dữ liệu huấn luyện quá ít hoặc thiếu đa dạng
Nếu tập huấn luyện nhỏ, một số đặc điểm ngẫu nhiên có thể xuất hiện với tần suất đủ lớn để mô hình xem chúng như tín hiệu có ý nghĩa.
Tập dữ liệu càng thiếu đại diện cho các trường hợp có thể gặp trong thực tế, mô hình càng khó phân biệt đâu là quy luật tổng quát và đâu là đặc điểm riêng của mẫu huấn luyện.
Dữ liệu chứa nhiều nhiễu
Nhãn sai, giá trị bất thường hoặc đặc điểm không liên quan có thể trở thành thứ mô hình cố gắng học.
Khi mô hình tìm cách khớp cả những nhiễu này, training error có thể tiếp tục giảm nhưng khả năng dự đoán trên dữ liệu mới không cải thiện tương ứng.
Huấn luyện quá lâu
Trong một số trường hợp, hiệu suất trên validation cải thiện ở giai đoạn đầu nhưng sau đó bắt đầu giảm trong khi hiệu suất trên training tiếp tục tăng.
Đây là dấu hiệu quan trọng cho thấy mô hình đã đi từ việc học quy luật hữu ích sang thích nghi quá mức với tập huấn luyện. Vì vậy, số epoch lớn hơn không đồng nghĩa với mô hình tốt hơn.
Làm thế nào nhận biết mô hình đang bị overfitting?
Cách trực quan nhất là theo dõi hiệu suất của mô hình trên các tập dữ liệu khác nhau trong quá trình huấn luyện.
Một tình huống điển hình là:
· Training loss: tiếp tục giảm
· Validation loss: ban đầu giảm nhưng sau đó tăng
· Training performance: tiếp tục cải thiện
· Validation hoặc test performance: bắt đầu suy giảm
Khoảng cách giữa kết quả trên training và validation/test cũng là một tín hiệu quan trọng. Nếu mô hình đạt kết quả rất cao trên training nhưng thấp hơn rõ rệt trên dữ liệu chưa thấy, khả năng khái quát hóa đang có vấn đề.
Tuy nhiên, không nên xác định overfitting chỉ từ một chỉ số. Cần xem xét đồng thời training loss, validation loss và các metric phù hợp với bài toán như accuracy, precision, recall, F1 hoặc sai số dự đoán.
Overfitting khác gì với underfitting?
Overfitting và underfitting nằm ở hai phía của vấn đề độ phù hợp mô hình.
|
Trạng thái |
Dữ liệu huấn luyện |
Dữ liệu mới |
Nguyên nhân điển hình |
|
Underfitting |
Kết quả kém |
Kết quả kém |
Mô hình chưa đủ khả năng học quy luật |
|
Fit phù hợp |
Kết quả tốt |
Kết quả tốt |
Cân bằng tốt giữa khả năng học và khái quát hóa |
|
Overfitting |
Kết quả rất tốt |
Kết quả kém hơn rõ rệt |
Mô hình học quá sát dữ liệu huấn luyện |
Vì vậy, mục tiêu không phải là tối đa hóa hiệu suất trên training bằng mọi giá. Mục tiêu là đạt điểm cân bằng giữa khả năng mô hình hóa dữ liệu và khả năng khái quát hóa sang dữ liệu mới.
Làm gì để giảm overfitting?
Biện pháp xử lý cần phù hợp với nguyên nhân gây ra overfitting. Một số hướng phổ biến gồm:
· Tăng hoặc đa dạng hóa dữ liệu: Giúp mô hình tiếp xúc với nhiều trường hợp hơn và giảm khả năng ghi nhớ những đặc điểm riêng của một tập mẫu nhỏ
· Regularization: Thêm ràng buộc vào quá trình học để hạn chế mô hình hình thành các nghiệm quá phức tạp
· Early stopping: Dừng huấn luyện khi hiệu suất validation không còn cải thiện, đặc biệt hữu ích khi training performance vẫn tiếp tục tăng
· Giảm độ phức tạp mô hình: Sử dụng kiến trúc hoặc số lượng tham số phù hợp hơn với lượng thông tin mà dữ liệu cung cấp
· Data augmentation: Tạo thêm các biến thể hợp lý của dữ liệu trong những bài toán mà phương pháp này phù hợp
· Đánh giá bằng validation/test đúng cách: Tách dữ liệu đánh giá khỏi quá trình học tham số để có thước đo đáng tin cậy hơn về khả năng khái quát hóa
Không có biện pháp nào luôn hiệu quả trong mọi trường hợp. Chẳng hạn, giảm độ phức tạp quá mức có thể chuyển vấn đề từ overfitting sang underfitting. Tương tự, tăng dữ liệu nhưng dữ liệu mới vẫn không đại diện cho phân phối thực tế thì khả năng khái quát hóa có thể không cải thiện đáng kể.
Overfitting khiến mô hình hoạt động tốt trên dữ liệu huấn luyện nhưng kém trên dữ liệu mới vì mô hình đã thích nghi quá mức với những đặc điểm riêng của tập huấn luyện, thay vì chỉ học những quy luật có khả năng khái quát. Dấu hiệu quan trọng là hiệu suất training tiếp tục cải thiện trong khi validation hoặc test bắt đầu suy giảm, tạo ra khoảng cách về khả năng khái quát hóa.
Do đó, đánh giá một mô hình không nên chỉ dựa vào mức độ chính xác trên dữ liệu đã dùng để huấn luyện. Điều cần quan tâm hơn là mô hình có duy trì được hiệu suất khi gặp dữ liệu chưa từng thấy hay không.

GỬI Ý KIẾN BÌNH LUẬN

