Khi nào độ chính xác mô hình không phải thước đo tốt nhất?
Mục lục
Độ chính xác mô hình cho biết tỷ lệ dự đoán đúng, nhưng có thể gây hiểu sai khi dữ liệu lệch lớp, chi phí lỗi khác nhau hoặc mục tiêu cần nhiều hơn một con số.
Độ chính xác mô hình, hay accuracy, là tỷ lệ số dự đoán đúng trên tổng số dự đoán. Với bài toán phân loại nhị phân, accuracy được tính bằng:
Accuracy = (TP TN) / (TP TN FP FN)
Trong đó TP và TN là các trường hợp dự đoán đúng, còn FP và FN là hai loại dự đoán sai.
Accuracy dễ hiểu, dễ so sánh và hữu ích trong nhiều bài toán phân loại. Tuy nhiên, nó chỉ trả lời một câu hỏi khá hẹp: bao nhiêu phần trăm dự đoán là đúng? Nó không cho biết mô hình đang sai ở lớp nào, loại sai nào nghiêm trọng hơn, xác suất dự đoán có đáng tin hay không, hoặc hiệu quả đó có phù hợp với mục tiêu vận hành hay không.
Vì vậy, accuracy không phải mặc định là thước đo tốt nhất. Nó đáng tin nhất khi phân bố lớp không làm sai lệch kết quả, các loại lỗi có hậu quả tương đối tương đương, tập đánh giá đại diện cho dữ liệu thực tế và mục tiêu thực sự là tối đa hóa số trường hợp phân loại đúng.
Độ chính xác mô hình thực sự đo điều gì?
Accuracy gộp toàn bộ dự đoán thành hai nhóm: đúng và sai. Một mô hình dự đoán đúng 900 trong 1.000 trường hợp sẽ có accuracy 90%, bất kể 100 trường hợp sai thuộc lớp nào và phát sinh theo cách nào.
Cách tính này hàm chứa một giả định quan trọng: mỗi quan sát có trọng số như nhau và mỗi lỗi đều đóng góp như nhau vào kết quả cuối cùng. Một false positive làm accuracy giảm một đơn vị; một false negative cũng làm giảm đúng một đơn vị. Metric không biết rằng trong ứng dụng thực tế, hai lỗi đó có thể gây hậu quả rất khác nhau.
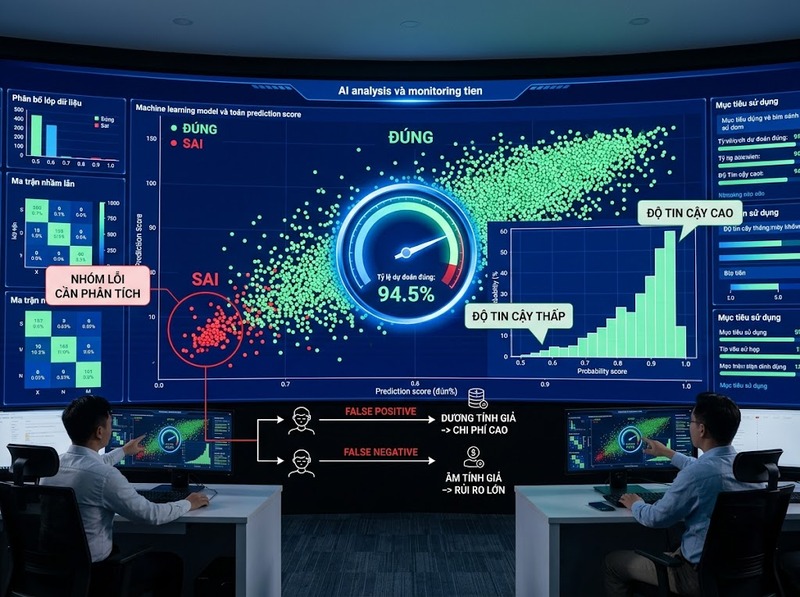
Đây là lý do hai mô hình có cùng accuracy chưa chắc có cùng giá trị sử dụng. Accuracy chỉ phản ánh tổng số dự đoán đúng, còn cấu trúc của các dự đoán sai nằm trong confusion matrix mới cho biết mô hình đang thất bại ở đâu.
Accuracy cũng không có một ngưỡng phổ quát để kết luận mô hình “tốt”. Mức 90%, 95% hay 99% chỉ có ý nghĩa khi đặt cạnh độ khó của bài toán, tỷ lệ các lớp, baseline đơn giản và yêu cầu thực tế. Nếu một lớp đã chiếm 99% dữ liệu, accuracy 99% thậm chí có thể đạt được mà không cần phát hiện một trường hợp nào của lớp còn lại.
Dữ liệu lệch lớp có thể khiến accuracy trông rất tốt
Mất cân bằng lớp là trường hợp điển hình khiến accuracy trở nên dễ gây hiểu nhầm.
Giả sử một tập dữ liệu có 10.000 giao dịch, trong đó chỉ 100 giao dịch là gian lận và 9.900 giao dịch bình thường. Một mô hình luôn dự đoán “không gian lận” sẽ đúng 9.900 lần:
Accuracy = 9.900 / 10.000 = 99%
Con số 99% nghe rất cao, nhưng mô hình phát hiện được 0 trong 100 giao dịch gian lận. Recall của lớp gian lận bằng 0%.
Vấn đề không nằm ở phép tính accuracy. Accuracy đã đo chính xác điều nó được định nghĩa để đo. Vấn đề là câu hỏi mà metric trả lời không trùng với câu hỏi người vận hành cần biết.
Trong tình huống này, tỷ lệ lớp chiếm ưu thế tạo ra một baseline rất mạnh. Trước khi coi 99% là thành tích, cần hỏi một chiến lược tầm thường như “luôn chọn lớp phổ biến nhất” đã đạt bao nhiêu. Nếu baseline đã là 99%, accuracy 99% không chứng minh mô hình học được khả năng nhận diện lớp hiếm.
Balanced accuracy khắc phục một phần vấn đề bằng cách tính trung bình recall của các lớp thay vì để lớp đông chi phối kết quả. Trong ví dụ trên, mô hình luôn dự đoán giao dịch bình thường có recall của lớp gian lận bằng 0 và recall của lớp bình thường bằng 1, nên balanced accuracy chỉ bằng:
(0 1) / 2 = 0,5
So sánh 99% accuracy với 50% balanced accuracy cho thấy cùng một mô hình có thể trông xuất sắc hoặc vô dụng tùy câu hỏi mà metric được thiết kế để trả lời.
Cùng một accuracy có thể che giấu hai kiểu sai rất khác nhau
Ngay cả khi dữ liệu không quá mất cân bằng, accuracy vẫn có thể thiếu thông tin khi false positive và false negative mang chi phí khác nhau.
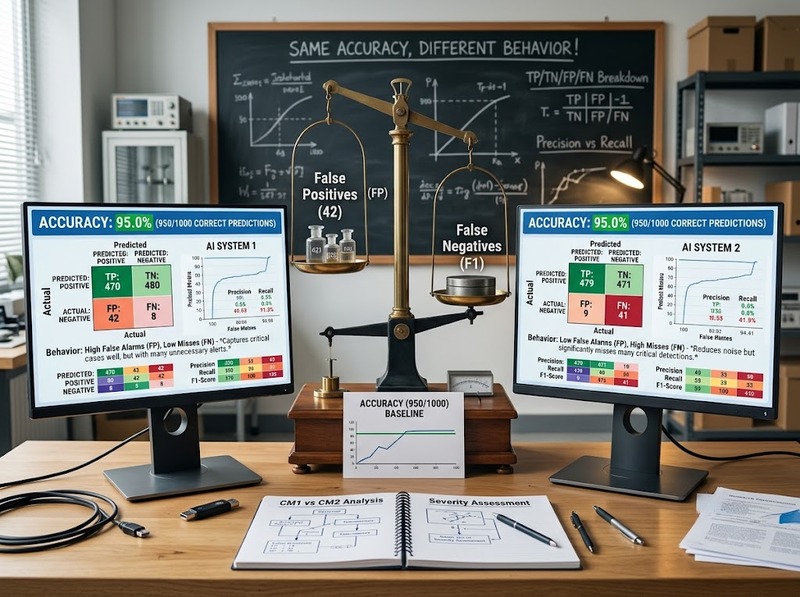
Giả sử tập kiểm thử có 1.000 trường hợp gồm 100 mẫu dương tính và 900 mẫu âm tính. Hai mô hình đều đạt accuracy 95%:
Mô hình A: TP = 90, FN = 10, FP = 40, TN = 860
Mô hình B: TP = 60, FN = 40, FP = 10, TN = 890
Cả hai đều dự đoán đúng 950 trường hợp. Nhưng hành vi của chúng rất khác nhau.
Mô hình A đạt recall 90%, nghĩa là tìm được 90 trong 100 trường hợp dương tính, nhưng tạo ra nhiều false positive hơn. Precision của nó khoảng 69,2%.
Mô hình B có ít false positive hơn và precision khoảng 85,7%, nhưng recall chỉ còn 60%. Nó bỏ sót 40% trường hợp dương tính.
Nếu bỏ sót trường hợp dương tính gây hậu quả lớn, mô hình A có thể phù hợp hơn. Nếu một cảnh báo sai rất tốn kém, mô hình B có thể đáng giá hơn. Accuracy 95% không thể hiện sự đánh đổi này vì nó chỉ quan tâm tổng số lỗi, không phân biệt lỗi thuộc loại nào.
Đó là lúc confusion matrix và các metric dẫn xuất trở nên cần thiết:
Precision = TP / (TP FP) cho biết trong các trường hợp mô hình dự đoán dương tính, bao nhiêu trường hợp thực sự đúng.
Recall = TP / (TP FN) cho biết trong toàn bộ trường hợp dương tính thực sự, mô hình phát hiện được bao nhiêu.
Không có quy tắc rằng precision luôn quan trọng hơn recall hoặc ngược lại. Việc lựa chọn phụ thuộc vào hậu quả của false positive và false negative trong hệ thống cụ thể.
Metric nào phù hợp hơn trong từng mục tiêu?
Các bộ công cụ đánh giá machine learning như scikit-learn tách accuracy, balanced accuracy, precision, recall, F1, ROC-AUC và log loss thành những metric riêng vì chúng đo các thuộc tính khác nhau. Thay accuracy bằng một metric khác chỉ có ý nghĩa khi metric mới phù hợp hơn với câu hỏi cần trả lời.
|
Mục tiêu đánh giá |
Metric thường hữu ích |
Điều metric làm rõ |
|
Các lớp mất cân bằng nhưng đều cần được xem xét |
Balanced accuracy, macro recall |
Giảm ảnh hưởng của lớp chiếm đa số |
|
Cần hạn chế false positive |
Precision |
Mức đáng tin của các dự đoán dương tính |
|
Cần hạn chế false negative |
Recall |
Khả năng tìm đủ các trường hợp dương tính |
|
Cần cân bằng precision và recall |
F1-score |
Trung bình điều hòa của precision và recall |
|
Cần đánh giá khả năng xếp hạng qua nhiều threshold |
ROC-AUC hoặc PR-AUC |
Khả năng tách/xếp hạng hai lớp thay vì chỉ một ngưỡng |
|
Hệ thống sử dụng xác suất dự đoán |
Log loss, Brier score và calibration |
Chất lượng và độ tin cậy của xác suất |
F1-score hữu ích khi precision và recall đều quan trọng, nhưng nó không trực tiếp sử dụng true negative. Vì vậy, F1 cũng không phải metric thay thế accuracy trong mọi trường hợp.
Với bài toán nhiều lớp, macro F1 tính metric riêng cho từng lớp rồi cho các lớp trọng số ngang nhau. Cách này giúp lớp hiếm không bị chìm trong kết quả tổng hợp. Ngược lại, weighted F1 gán trọng số theo số mẫu của từng lớp nên vẫn chịu ảnh hưởng đáng kể từ các lớp phổ biến.
ROC-AUC và PR-AUC lại giải quyết một câu hỏi khác. Accuracy đánh giá kết quả sau khi đã chọn một threshold cụ thể; AUC đánh giá hành vi của mô hình trên nhiều threshold. Khi lớp dương tính rất hiếm và chất lượng dự đoán dương tính là trọng tâm, đường precision–recall thường cho góc nhìn trực tiếp hơn về sự đánh đổi giữa precision và recall.
Nếu đầu ra xác suất được sử dụng để định giá rủi ro hoặc ra quyết định tiếp theo, một mô hình dự đoán đúng nhãn chưa chắc đã cung cấp xác suất tốt. Dự đoán xác suất 0,51 và 0,99 có thể tạo cùng một nhãn sau threshold 0,5, nhưng mức độ tự tin hoàn toàn khác nhau. Accuracy không phân biệt hai trường hợp đó; log loss, Brier score và kiểm tra calibration được thiết kế để đánh giá phần thông tin này.
Khi nào accuracy vẫn là thước đo hợp lý?
Giới hạn của accuracy không có nghĩa metric này nên bị loại bỏ. Trong đúng điều kiện, sự đơn giản của nó là một lợi thế.
Accuracy phù hợp hơn khi các lớp có phân bố tương đối cân bằng hoặc sự mất cân bằng không làm thay đổi mục tiêu đánh giá; false positive và false negative có hậu quả gần tương đương; mọi lớp có tầm quan trọng tương tự; đầu ra cần đánh giá là nhãn phân loại cuối cùng; và tập kiểm thử phản ánh hợp lý dữ liệu mà mô hình sẽ gặp khi triển khai.
Ví dụ, nếu một bài toán phân loại hai lớp có tỷ lệ gần 50/50, mỗi lỗi được xem như nhau và mục tiêu đơn giản là tối đa hóa số dự đoán đúng, accuracy thể hiện trực tiếp mục tiêu đó. Trong trường hợp này, thêm nhiều metric có thể cung cấp thông tin bổ sung nhưng không nhất thiết thay đổi quyết định.
Tuy nhiên, accuracy vẫn cần được đặt cạnh baseline. Một mô hình đạt 92% trên bài toán mà chiến lược đơn giản chỉ đạt 50% có ý nghĩa khác hẳn mô hình đạt 92% khi lớp phổ biến nhất đã chiếm 91% dữ liệu.
Tập dữ liệu dùng để tính accuracy cũng quan trọng không kém công thức. Accuracy trên tập huấn luyện chủ yếu cho biết mô hình khớp dữ liệu đã thấy đến đâu; nó không đủ để chứng minh khả năng tổng quát hóa. Khi mục tiêu là hiệu năng thực tế, metric phải được tính trên dữ liệu validation hoặc test độc lập và có phân bố đủ gần với môi trường triển khai.
Vì vậy, accuracy có thể là metric chính khi các giả định của nó phù hợp với bài toán. Nó trở thành lựa chọn yếu khi người đánh giá sử dụng con số này chỉ vì dễ hiểu mà không kiểm tra các giả định phía sau.
Cách chọn bộ metric cho một hệ thống thông minh
Thay vì bắt đầu bằng câu hỏi “metric nào tốt nhất?”, nên bắt đầu bằng quyết định mà đầu ra của mô hình sẽ hỗ trợ.
Trước hết, xác định một dự đoán sai gây hậu quả gì. Nếu false positive và false negative tạo ra tác động khác nhau, cần đo riêng hai loại lỗi. Precision và recall khi đó mang nhiều thông tin hơn một accuracy tổng hợp.
Tiếp theo, kiểm tra tỷ lệ các lớp. Với dữ liệu lệch mạnh, luôn so sánh mô hình với baseline theo lớp phổ biến và xem hiệu năng riêng của lớp hiếm. Balanced accuracy, macro F1, recall từng lớp hoặc precision–recall có thể cho thấy những thất bại mà accuracy che khuất.
Sau đó, xác định đầu ra mà hệ thống thực sự sử dụng. Nếu hệ thống chỉ cần nhãn cuối cùng, metric dựa trên confusion matrix có thể đủ. Nếu xác suất được dùng để xếp hạng, phân bổ nguồn lực hoặc điều chỉnh threshold, cần đánh giá thêm ranking và calibration thay vì chỉ kiểm tra nhãn đúng hay sai.
Không nên chọn threshold và metric như hai quyết định tách biệt. Thay đổi threshold thường làm precision và recall dịch chuyển theo hai hướng khác nhau. Một mô hình có thể không thay đổi nhưng kết quả vận hành thay đổi đáng kể chỉ vì điểm cắt được điều chỉnh.
Cuối cùng, một metric chính nên đi cùng một số metric kiểm soát đúng với failure mode quan trọng. Chẳng hạn, accuracy có thể là chỉ số tổng quan trong một bài toán phân loại tương đối cân bằng, nhưng vẫn nên kiểm tra confusion matrix và hiệu năng từng lớp. Với bài toán lớp hiếm, recall hoặc PR-AUC có thể là metric chính trong khi precision giữ vai trò kiểm soát số cảnh báo sai. Với hệ thống dựa trên xác suất, log loss hoặc Brier score cần được xem cùng calibration.
Mục tiêu không phải báo cáo càng nhiều metric càng tốt. Một bộ metric tốt là bộ metric đủ để trả lời ba câu hỏi: mô hình làm đúng điều gì, nó thất bại theo cách nào và kiểu thất bại đó có chấp nhận được đối với quyết định thực tế hay không.
Độ chính xác mô hình là một phép đo có giá trị, nhưng giá trị của nó phụ thuộc vào cấu trúc dữ liệu và mục tiêu sử dụng. Accuracy trả lời rất tốt câu hỏi “tỷ lệ dự đoán đúng là bao nhiêu”; nó không tự trả lời được lớp nào đang bị bỏ sót, loại lỗi nào quan trọng hơn, xác suất có đáng tin hay kết quả có phù hợp với chi phí vận hành.
Vì thế, accuracy không nên được xem là thước đo mặc định tốt nhất cho mọi hệ thống thông minh. Khi lớp mất cân bằng, chi phí lỗi bất đối xứng, threshold có vai trò quan trọng hoặc hệ thống sử dụng xác suất, metric cần được chọn theo failure mode và quyết định thực tế. Accuracy vẫn có thể nằm trong bộ đánh giá, nhưng chỉ nên giữ vai trò trung tâm khi những giả định làm cho nó có ý nghĩa thực sự được đáp ứng.

GỬI Ý KIẾN BÌNH LUẬN

