Vì sao khả năng tổng quát hóa của mô hình quan trọng?
Mục lục
- Khả năng tổng quát hóa đo điều gì ở một mô hình?
- Mô hình tổng quát hóa từ dữ liệu huấn luyện bằng cách nào?
- Vì sao khả năng tổng quát hóa quan trọng với hệ thống thông minh?
- Đánh giá khả năng tổng quát hóa bằng dữ liệu mới ra sao?
- Khi nào mô hình có vẻ tổng quát hóa tốt nhưng vẫn thất bại?
- Làm gì để duy trì khả năng tổng quát hóa khi hệ thống vận hành?
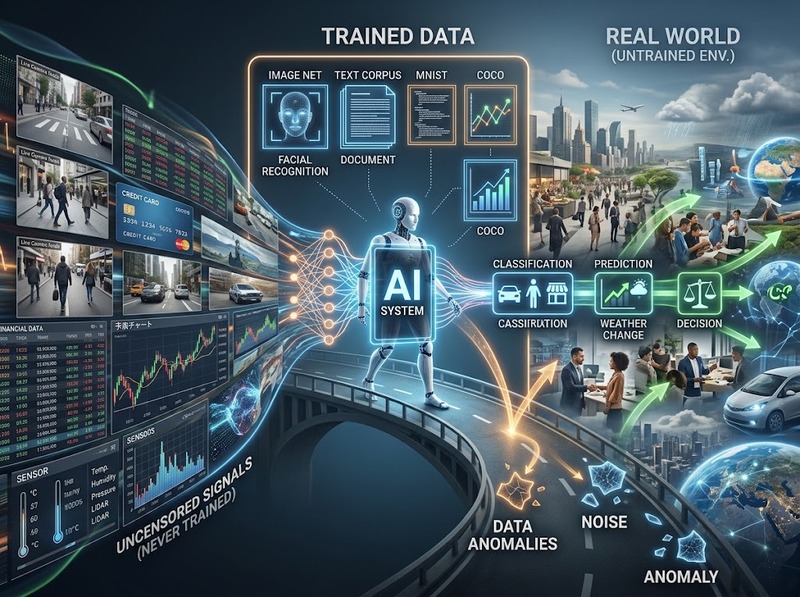
Khả năng tổng quát hóa cho biết mô hình có duy trì hiệu suất trên dữ liệu chưa từng thấy hay chỉ phù hợp với dữ liệu huấn luyện. Đây là tiêu chí cốt lõi để đánh giá liệu một hệ thống thông minh có đáng tin cậy khi gặp đầu vào mới trong thực tế hay không.
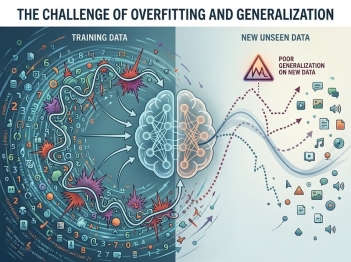
Trong machine learning, mục tiêu không phải là đạt kết quả tốt nhất trên tập huấn luyện, mà là học được những quy luật đủ ổn định để tiếp tục dự đoán tốt trên các quan sát mới từ phân phối mục tiêu. Vì vậy, hiệu suất huấn luyện rất cao chưa tự chứng minh khả năng tổng quát hóa. Khoảng cách giữa hiệu suất trên dữ liệu huấn luyện và dữ liệu chưa thấy — thường được gọi là generalization gap — là một tín hiệu quan trọng, nhưng không có một ngưỡng “tốt” duy nhất cho mọi bài toán.
Khả năng tổng quát hóa đo điều gì ở một mô hình?
Khả năng tổng quát hóa là năng lực của mô hình duy trì hiệu suất trên những mẫu dữ liệu mà nó chưa gặp trong quá trình huấn luyện, với điều kiện các mẫu đó đại diện cho phân phối mục tiêu mà hệ thống cần xử lý. Trong ngôn ngữ của statistical learning theory, điều cần quan tâm không chỉ là empirical risk — sai số đo trên tập huấn luyện — mà là expected risk hoặc generalization error, tức sai số kỳ vọng trên các quan sát mới.
Tổng quát hóa khác với việc “học thuộc” tập huấn luyện. Một mô hình có thể đạt loss gần bằng 0 hoặc accuracy rất cao trên dữ liệu đã thấy nhưng vẫn dự đoán kém trên tập kiểm thử. Khi đó, quá trình tối ưu đã tìm được một hàm phù hợp với mẫu huấn luyện, nhưng chưa chắc đã nắm được những quy luật có khả năng lặp lại ở dữ liệu mới.
Tổng quát hóa cũng không phải một thuộc tính tuyệt đối chỉ nằm trong bản thân kiến trúc mô hình. Nó phụ thuộc đồng thời vào dữ liệu huấn luyện, cách lấy mẫu, độ nhiễu, mục tiêu tối ưu, độ phức tạp của mô hình, quy trình học và phân phối dữ liệu mà hệ thống sẽ gặp. Vì vậy, cùng một mô hình có thể tổng quát hóa tốt trong một miền dữ liệu nhưng kém khi bối cảnh sử dụng thay đổi.
Mô hình tổng quát hóa từ dữ liệu huấn luyện bằng cách nào?
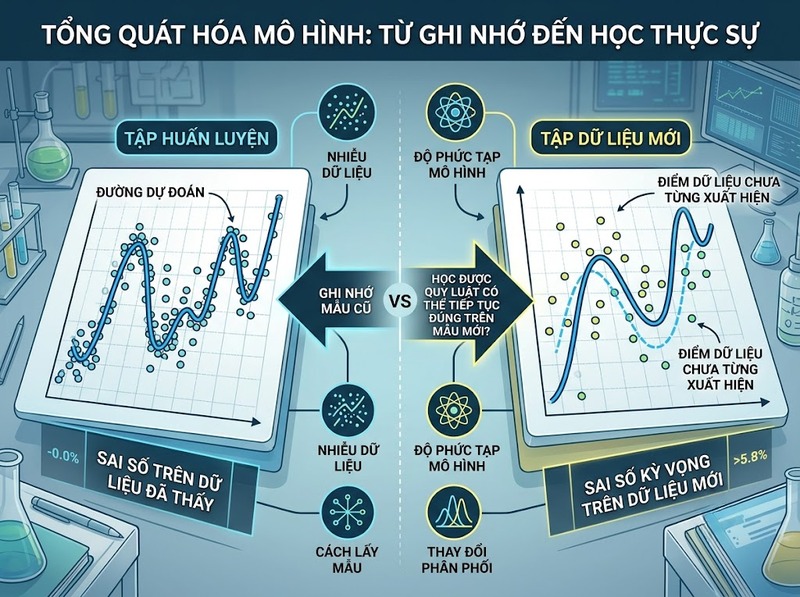
Trong huấn luyện có giám sát, mô hình điều chỉnh tham số để giảm loss trên một tập mẫu hữu hạn. Từ một số lượng quan sát giới hạn, nó phải hình thành một hàm ánh xạ có thể tiếp tục hoạt động trên những quan sát chưa xuất hiện. Tổng quát hóa xảy ra khi hàm học được phản ánh những quy luật thống kê ổn định thay vì phụ thuộc quá mạnh vào nhiễu, ngoại lệ ngẫu nhiên hoặc đặc điểm chỉ có trong tập huấn luyện.
Khả năng này chịu ảnh hưởng của inductive bias — những giả định mà thuật toán, kiến trúc hoặc quy trình học áp đặt lên tập các lời giải có thể có. Chẳng hạn, regularization, early stopping hoặc data augmentation có thể làm giảm xu hướng bám quá sát dữ liệu huấn luyện. Tuy nhiên, các kỹ thuật đó chỉ thay đổi điều kiện học; chúng không phải bằng chứng trực tiếp rằng mô hình đã tổng quát hóa tốt. Bằng chứng vẫn phải đến từ hiệu suất trên dữ liệu chưa được dùng để khớp tham số hoặc lựa chọn mô hình.
Mối quan hệ giữa memorization và generalization cũng không hoàn toàn đối lập. Một mô hình lớn có thể ghi nhớ một phần dữ liệu và đồng thời dự đoán tốt trên mẫu mới. Vì vậy, năng lực fit tập train không đủ để kết luận. Mô hình chỉ có bằng chứng về tổng quát hóa khi hiệu suất được duy trì trên các quan sát độc lập và đại diện cho bài toán thực tế.
Vì sao khả năng tổng quát hóa quan trọng với hệ thống thông minh?
Một hệ thống thông minh được triển khai để xử lý những đầu vào chưa biết trước. Camera sẽ gặp khung hình mới, mô hình phát hiện gian lận sẽ gặp giao dịch mới, hệ thống dự báo sẽ nhận dữ liệu của những thời điểm chưa xảy ra. Nếu năng lực chỉ tồn tại trên mẫu huấn luyện, hệ thống không tạo ra giá trị dự đoán khi vận hành.
Do đó, tổng quát hóa là cầu nối giữa khả năng fit dữ liệu và khả năng sử dụng mô hình trong thực tế. Một ví dụ giả định cho thấy khác biệt này: nếu mô hình đạt 99% accuracy trên tập train nhưng chỉ đạt 82% trên một test set độc lập, khoảng chênh 17 điểm phần trăm là tín hiệu rõ ràng rằng hiệu suất huấn luyện đang đánh giá quá lạc quan năng lực trên dữ liệu mới. Con số 17 điểm không phải một ngưỡng phổ quát để kết luận overfitting; ý nghĩa của nó còn phụ thuộc bài toán, kích thước mẫu, độ bất định và chi phí của lỗi.
Khả năng tổng quát hóa còn quyết định mức độ đáng tin của những quyết định dựa trên mô hình. Nếu sai số ngoài mẫu không được ước lượng đúng, một hệ thống có thể trông rất chính xác trong phát triển nhưng suy giảm mạnh sau triển khai. Với các tác vụ có chi phí sai lầm cao, sự chênh lệch nhỏ về metric cũng có thể quan trọng hơn nhiều so với các tác vụ ít rủi ro.
Dù vậy, tổng quát hóa tốt không đồng nghĩa với hệ thống đã “thông minh” theo mọi nghĩa, cũng không bảo đảm đầy đủ robustness, fairness, calibration hay an toàn. Nó là điều kiện thiết yếu để mô hình hữu dụng trên dữ liệu mới, nhưng chỉ là một phần của chất lượng hệ thống.
Đánh giá khả năng tổng quát hóa bằng dữ liệu mới ra sao?
Tách đúng train, validation và test
Tập train dùng để khớp tham số. Tập validation dùng để chọn hyperparameter, kiến trúc hoặc ngưỡng quyết định. Tập test nên được giữ độc lập cho đánh giá cuối cùng. Nếu thông tin từ test set quay trở lại quá trình lựa chọn mô hình nhiều lần, test set dần trở thành một nguồn tín hiệu huấn luyện gián tiếp và không còn cho ước lượng khách quan về hiệu suất ngoài mẫu.
Cách chia dữ liệu cũng phải phản ánh điều kiện sử dụng. Với dữ liệu chuỗi thời gian, việc xáo trộn ngẫu nhiên quá khứ và tương lai có thể tạo leakage. Với dữ liệu có nhiều bản ghi từ cùng một người dùng, thiết bị hoặc đối tượng, chia từng hàng ngẫu nhiên có thể khiến các mẫu rất giống nhau xuất hiện ở cả train và test. Khi đó, metric cao có thể phản ánh sự trùng lặp cấu trúc hơn là năng lực xử lý trường hợp thực sự mới.
Theo dõi generalization gap và độ ổn định của metric
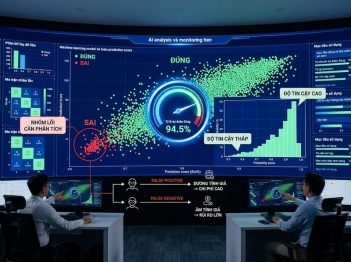
Trong thực hành, có thể ước lượng generalization gap bằng cách so sánh error trên train với error trên validation hoặc test. Với loss/error, một ước lượng đơn giản là test error − training error; về mặt lý thuyết, generalization error là sai số kỳ vọng trên phân phối mục tiêu chứ không phải chính sai số của một test set hữu hạn. Gap dương lớn là tín hiệu mô hình đang hoạt động kém hơn đáng kể trên dữ liệu chưa thấy. Với các metric mà “cao hơn là tốt hơn” như accuracy, người đánh giá thường nhìn theo chiều ngược lại: training accuracy trừ test accuracy.
Không có ngưỡng gap cố định áp dụng cho mọi bài toán. Một mức chênh chấp nhận được phải được diễn giải cùng metric gốc, độ khó của tác vụ, độ lớn test set, biến thiên thống kê và chi phí của từng loại lỗi. Khi dữ liệu hạn chế, cross-validation có thể cung cấp nhiều lần đánh giá trên các phần dữ liệu khác nhau để xem kết quả có ổn định hay chỉ phụ thuộc vào một lần chia mẫu.
Metric cũng cần phù hợp với nhiệm vụ. Accuracy có thể gây hiểu nhầm khi lớp dữ liệu mất cân bằng; khi đó precision, recall, F1, AUROC hoặc các metric theo chi phí có thể phù hợp hơn. Tổng quát hóa không được chứng minh bằng một con số “đẹp”, mà bằng hiệu suất ngoài mẫu được đo bằng chỉ số phù hợp với quyết định mà hệ thống sẽ hỗ trợ.
Khi nào mô hình có vẻ tổng quát hóa tốt nhưng vẫn thất bại?
Data leakage và benchmark không đại diện
Một test score cao chỉ có ý nghĩa khi tập test thực sự độc lập và đại diện. Data leakage xảy ra khi thông tin mà mô hình đáng lẽ không được biết trong thời điểm dự đoán lại lọt vào feature, preprocessing hoặc cách chia tập dữ liệu. Khi đó, mô hình có thể đạt kết quả rất cao nhưng không tái lập được mức hiệu suất ấy trong vận hành.
Một rủi ro khác là “overfit vào benchmark”. Nếu cùng một tập test được kiểm tra lặp đi lặp lại để quyết định thay đổi mô hình, đội phát triển có thể vô tình tối ưu theo chính benchmark đó. Dù tham số không được fit trực tiếp trên test set, chuỗi quyết định của con người vẫn truyền thông tin từ test vào quy trình phát triển.
Distribution shift làm thay đổi bài toán mà test set đại diện
Khái niệm tổng quát hóa thông thường giả định dữ liệu mới được rút ra từ cùng hoặc gần cùng phân phối mục tiêu với dữ liệu đánh giá. Khi phân phối thay đổi — ví dụ hành vi người dùng, môi trường cảm biến, chính sách kinh doanh hoặc đặc điểm quần thể thay đổi — test performance trước đây không còn là bằng chứng đầy đủ cho hiệu suất hiện tại.
Đây là ranh giới quan trọng giữa in-distribution generalization và khả năng chịu distribution shift. Một mô hình có thể tổng quát hóa tốt trên dữ liệu mới cùng phân phối nhưng vẫn thất bại trên dữ liệu ngoài miền. Vì vậy, không nên diễn giải “test score cao” thành “mô hình sẽ hoạt động tốt với mọi dữ liệu mới”.
Làm gì để duy trì khả năng tổng quát hóa khi hệ thống vận hành?
Thiết kế đánh giá nên bắt đầu từ câu hỏi hệ thống thực sự sẽ gặp loại dữ liệu nào. Cách chia train–validation–test cần mô phỏng ranh giới triển khai quan trọng, chẳng hạn theo thời gian, người dùng, thiết bị, địa điểm hoặc nguồn dữ liệu. Mục tiêu là làm cho dữ liệu đánh giá gần với những trường hợp mà mô hình phải xử lý sau khi đưa vào sử dụng.
Trong quá trình phát triển, cần theo dõi cả train metric và validation metric thay vì chỉ tối ưu một phía. Khi train performance tiếp tục cải thiện nhưng validation performance xấu đi, có thể cần điều chỉnh regularization, độ phức tạp mô hình, dữ liệu hoặc quy trình huấn luyện; lựa chọn cuối cùng vẫn phải được xác nhận trên dữ liệu độc lập. Một thay đổi làm training loss xấu hơn đôi chút nhưng cải thiện validation/test performance vẫn có thể là lựa chọn tốt hơn cho mục tiêu triển khai.
Sau triển khai, khả năng tổng quát hóa không nên được coi là kết luận vĩnh viễn. Phân phối dữ liệu có thể dịch chuyển, tỷ lệ các trường hợp có thể thay đổi và các pattern từng hữu ích có thể suy yếu. Theo dõi metric trên dữ liệu vận hành, phát hiện drift và tái đánh giá trên mẫu mới giúp xác định thời điểm mô hình cần cập nhật hoặc huấn luyện lại.
Cuối cùng, tiêu chí chấp nhận phải gắn với hậu quả thực tế của sai số. Một mô hình không cần có generalization gap bằng 0 để hữu dụng; điều cần thiết là hiệu suất ngoài mẫu đủ ổn định và đạt mức phù hợp với rủi ro, chi phí và yêu cầu của hệ thống.
Khả năng tổng quát hóa là năng lực duy trì hiệu suất trên dữ liệu chưa từng thấy nhưng vẫn thuộc phạm vi mà hệ thống được thiết kế để xử lý. Nó quan trọng vì giá trị của một mô hình không nằm ở việc tái hiện tốt dữ liệu huấn luyện, mà ở khả năng đưa ra dự đoán hoặc quyết định đáng tin cậy khi gặp các trường hợp mới.
Đánh giá tổng quát hóa cần dựa trên dữ liệu độc lập, cách chia tập phù hợp với bối cảnh triển khai, metric đúng với nhiệm vụ và việc theo dõi generalization gap. Một test score cao là bằng chứng trong điều kiện mà test set đại diện; nó không bảo đảm hiệu suất khi phân phối dữ liệu thay đổi. Vì vậy, tổng quát hóa là điều kiện thiết yếu cho một hệ thống thông minh hữu dụng, nhưng phải được kiểm chứng và theo dõi xuyên suốt vòng đời mô hình.

GỬI Ý KIẾN BÌNH LUẬN

