Underfitting xảy ra khi nào trong quá trình xây dựng mô hình?
Mục lục
Underfitting xảy ra khi mô hình quá đơn giản hoặc quá bị giới hạn nên không học được những quy luật quan trọng trong dữ liệu, khiến sai số trên cả tập huấn luyện và dữ liệu mới đều cao
Underfitting xảy ra khi mô hình chưa học đủ cấu trúc và quy luật quan trọng của dữ liệu để tạo ra dự đoán chính xác. Dấu hiệu điển hình là mô hình có hiệu năng kém ngay trên tập huấn luyện và thường tiếp tục kém trên tập kiểm tra hoặc tập validation
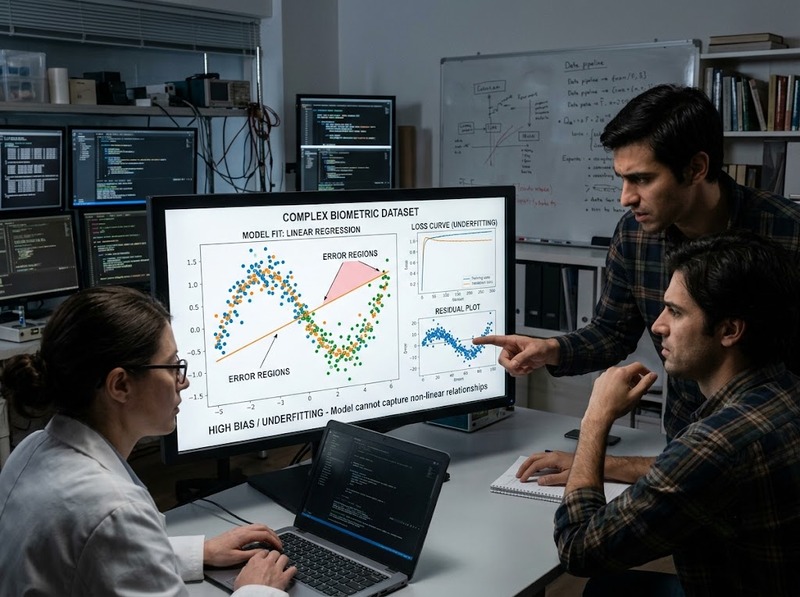
Nói cách khác, vấn đề của underfitting không phải là mô hình học quá sát dữ liệu huấn luyện mà là mô hình chưa đủ khả năng biểu diễn mối quan hệ cần học. Tình trạng này thường xuất hiện khi mô hình quá đơn giản, đặc trưng chưa đủ thông tin, mức regularization quá mạnh hoặc quá trình huấn luyện bị giới hạn
Underfitting là gì?
Underfitting là trạng thái trong đó mô hình có độ phức tạp hoặc khả năng biểu diễn thấp hơn mức cần thiết để mô tả quy luật thực sự của dữ liệu
Một mô hình bị underfitting thường có hai đặc điểm:
· Sai số trên tập huấn luyện vẫn cao
· Hiệu năng trên tập validation hoặc test cũng thấp
Điểm quan trọng là khoảng cách giữa lỗi huấn luyện và lỗi kiểm tra thường không lớn như trường hợp overfitting. Mô hình chưa học tốt ngay từ dữ liệu mà nó đã được dùng để huấn luyện
Ví dụ, nếu dữ liệu có quan hệ phi tuyến nhưng chỉ sử dụng một mô hình tuyến tính đơn giản, mô hình có thể không đủ khả năng biểu diễn quan hệ đó. Việc cung cấp thêm dữ liệu huấn luyện trong trường hợp này không nhất thiết giải quyết được vấn đề nếu bản thân mô hình vẫn không có đủ năng lực biểu diễn
Underfitting xảy ra khi nào trong quá trình xây dựng mô hình?
Underfitting thường xuất hiện khi quá trình xây dựng mô hình tạo ra một trong các điều kiện khiến năng lực học bị giới hạn quá mức
Mô hình có độ phức tạp quá thấp
Đây là nguyên nhân trực tiếp và phổ biến nhất. Nếu quan hệ giữa đầu vào và đầu ra phức tạp nhưng mô hình chỉ có khả năng biểu diễn một dạng quan hệ đơn giản, mô hình sẽ bỏ qua nhiều quy luật quan trọng
Ví dụ, một bài toán có quan hệ phi tuyến rõ rệt nhưng được giải bằng mô hình tuyến tính có thể tạo ra sai số cao trên cả tập train và test. Khi đó, tăng độ phức tạp mô hình hoặc lựa chọn một dạng mô hình phù hợp hơn có thể giúp mô hình biểu diễn dữ liệu tốt hơn
Regularization quá mạnh
Regularization được sử dụng để hạn chế mô hình học quá phức tạp và giảm nguy cơ overfitting. Tuy nhiên, nếu mức regularization quá lớn, các tham số của mô hình có thể bị hạn chế đến mức mô hình không còn đủ khả năng học những tín hiệu quan trọng
Vì vậy, regularization tạo ra một trade-off: quá yếu có thể dẫn đến overfitting, trong khi quá mạnh có thể dẫn đến underfitting
Đặc trưng đầu vào chưa chứa đủ thông tin
Mô hình có thể đủ phức tạp nhưng vẫn underfitting nếu dữ liệu đầu vào không cung cấp những thông tin cần thiết cho nhiệm vụ dự đoán
Chẳng hạn, nếu một biến mục tiêu phụ thuộc mạnh vào một đặc trưng quan trọng nhưng đặc trưng đó không được đưa vào mô hình, việc tăng độ phức tạp của thuật toán cũng không thể tạo ra thông tin mà dữ liệu đầu vào không chứa
Trường hợp này cần phân biệt với underfitting thuần túy do mô hình quá đơn giản. Vấn đề nằm ở information representation của dữ liệu chứ không chỉ ở thuật toán
Huấn luyện chưa đủ
Một mô hình có năng lực biểu diễn phù hợp vẫn có thể chưa học được quy luật nếu quá trình tối ưu bị dừng quá sớm
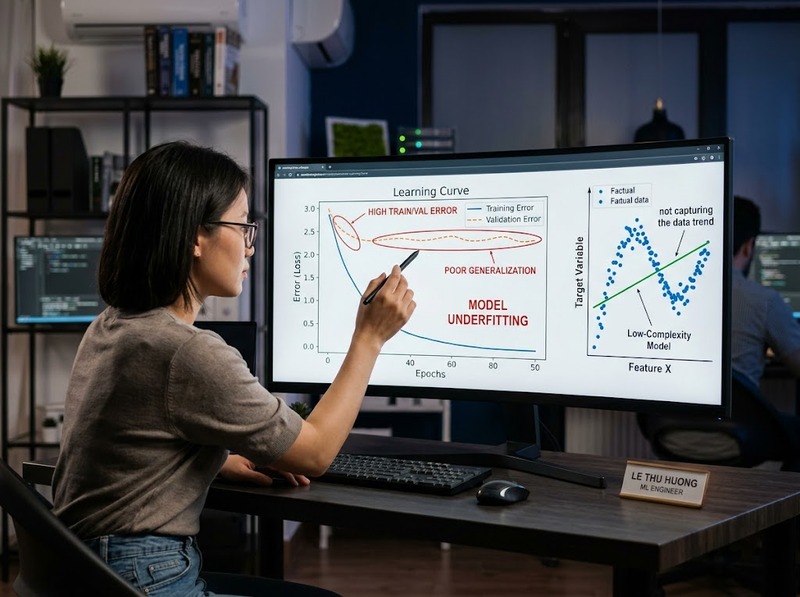
Trong mạng neural, chẳng hạn, số epoch quá thấp có thể khiến loss trên tập huấn luyện vẫn còn cao. Khi đường cong learning curve cho thấy lỗi train tiếp tục giảm nếu huấn luyện thêm, việc tăng thời gian huấn luyện có thể là hướng xử lý phù hợp
Tuy nhiên, không nên mặc định rằng cứ huấn luyện lâu hơn sẽ giải quyết underfitting. Nếu mô hình đã đạt giới hạn biểu diễn của nó, thêm epoch chỉ làm thay đổi rất ít kết quả
Làm thế nào nhận biết mô hình đang bị underfitting?
Có thể nhận biết underfitting bằng cách đối chiếu hiệu năng trên tập huấn luyện với validation hoặc test thay vì chỉ nhìn một chỉ số riêng lẻ
|
Trạng thái |
Lỗi train |
Lỗi validation/test |
Đặc điểm |
|
Underfitting |
Cao |
Cao |
Mô hình học chưa đủ quy luật |
|
Phù hợp |
Thấp |
Thấp |
Khả năng tổng quát hóa tốt |
|
Overfitting |
Rất thấp |
Cao |
Mô hình học quá sát dữ liệu train |
Với bài toán phân loại, có thể quan sát accuracy, precision, recall, F1 hoặc các metric phù hợp khác. Với hồi quy, các chỉ số như MAE, MSE hoặc RMSE có thể được sử dụng
Điều quan trọng là ngưỡng “cao” hay “thấp” không có một giá trị chung cho mọi bài toán. Cần so sánh metric với baseline, yêu cầu của bài toán và kết quả validation phù hợp
Learning curve cũng là một công cụ hữu ích. Nếu cả train error và validation error đều còn cao, đồng thời hai đường có khoảng cách tương đối nhỏ, đó là dấu hiệu phù hợp với underfitting. Nếu train error rất thấp nhưng validation error cao, vấn đề lại nghiêng về overfitting
Underfitting khác overfitting như thế nào?
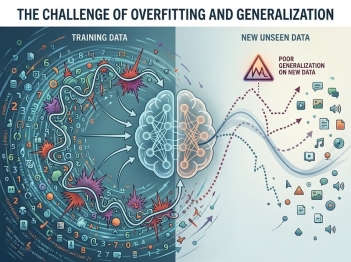
Underfitting và overfitting là hai dạng lỗi theo hướng ngược nhau trong việc cân bằng độ phức tạp của mô hình
Underfitting: mô hình quá đơn giản hoặc bị giới hạn nên không học được quy luật quan trọng
Overfitting: mô hình đủ hoặc quá phức tạp và học quá sát các đặc điểm riêng của dữ liệu huấn luyện, bao gồm cả nhiễu
Một cách nhìn trực quan là:
· Underfitting: mô hình chưa học đủ
· Mô hình phù hợp: học được quy luật có tính khái quát
· Overfitting: học quá sát dữ liệu huấn luyện
Theo góc nhìn bias–variance, underfitting thường gắn với high bias, còn overfitting thường gắn với high variance. Mục tiêu không phải là làm mô hình phức tạp nhất có thể mà là tìm mức độ phức tạp đủ để biểu diễn tín hiệu thực sự mà vẫn tổng quát hóa tốt
Làm gì khi mô hình bị underfitting?
Cách xử lý nên bắt đầu từ nguyên nhân thay vì chỉ tăng độ phức tạp mô hình một cách máy móc
Kiểm tra đặc trưng và chất lượng dữ liệu
Trước tiên cần xác định các biến đầu vào có chứa đủ thông tin liên quan đến mục tiêu hay không. Có thể cần bổ sung đặc trưng, cải thiện cách biểu diễn dữ liệu hoặc xử lý dữ liệu đầu vào phù hợp hơn
Điều chỉnh độ phức tạp của mô hình
Nếu mô hình thực sự quá đơn giản, có thể chuyển sang mô hình có khả năng biểu diễn quan hệ phức tạp hơn hoặc điều chỉnh các hyperparameter liên quan đến capacity
Việc này nên được đánh giá bằng validation thay vì lựa chọn mô hình chỉ dựa trên giả định rằng mô hình phức tạp hơn luôn tốt hơn
Giảm mức regularization nếu đang quá mạnh
Nếu regularization đang hạn chế mô hình quá mức, có thể điều chỉnh giảm cường độ regularization và theo dõi sự thay đổi của cả train và validation performance
Mục tiêu là tìm điểm cân bằng: mô hình phải đủ tự do để học tín hiệu nhưng không đến mức ghi nhớ dữ liệu huấn luyện
Huấn luyện lâu hơn khi learning curve cho thấy còn dư địa
Nếu lỗi train vẫn giảm rõ rệt theo thời gian huấn luyện, có thể tăng số epoch hoặc điều chỉnh quá trình tối ưu
Ngược lại, nếu lỗi train đã gần như không cải thiện dù mô hình được huấn luyện thêm, nguyên nhân có thể nằm ở model capacity, đặc trưng hoặc cách xây dựng bài toán thay vì thời gian huấn luyện
Đánh giá lại bằng validation
Mọi thay đổi nên được kiểm tra trên dữ liệu validation hoặc quy trình cross-validation phù hợp. Chỉ giảm training error chưa đủ để chứng minh mô hình đã được cải thiện
Một mô hình tốt là mô hình vừa học được quy luật trên dữ liệu huấn luyện vừa duy trì khả năng tổng quát hóa trên dữ liệu chưa nhìn thấy
Underfitting xảy ra khi mô hình không đủ khả năng học các quy luật cần thiết của dữ liệu, thường do mô hình quá đơn giản, regularization quá mạnh, đặc trưng thiếu thông tin hoặc quá trình huấn luyện chưa đạt mức cần thiết. Dấu hiệu quan trọng là hiệu năng trên tập train đã kém và hiệu năng trên validation/test cũng kém
Cách xử lý đúng không phải lúc nào cũng là tăng độ phức tạp. Cần xác định nguyên nhân nằm ở model capacity, dữ liệu và đặc trưng, regularization hay quá trình tối ưu, sau đó kiểm chứng thay đổi bằng validation để tìm mức độ phức tạp phù hợp

GỬI Ý KIẾN BÌNH LUẬN

